

IMAGE: AI生成ビジュアル
MODELS / MODELS
Liquid AI、LFM2.5向けQ4_0 GGUFをQuantization-Aware Distillationで刷新 — BF16の97%を維持しながらエッジでの高速推論を実現
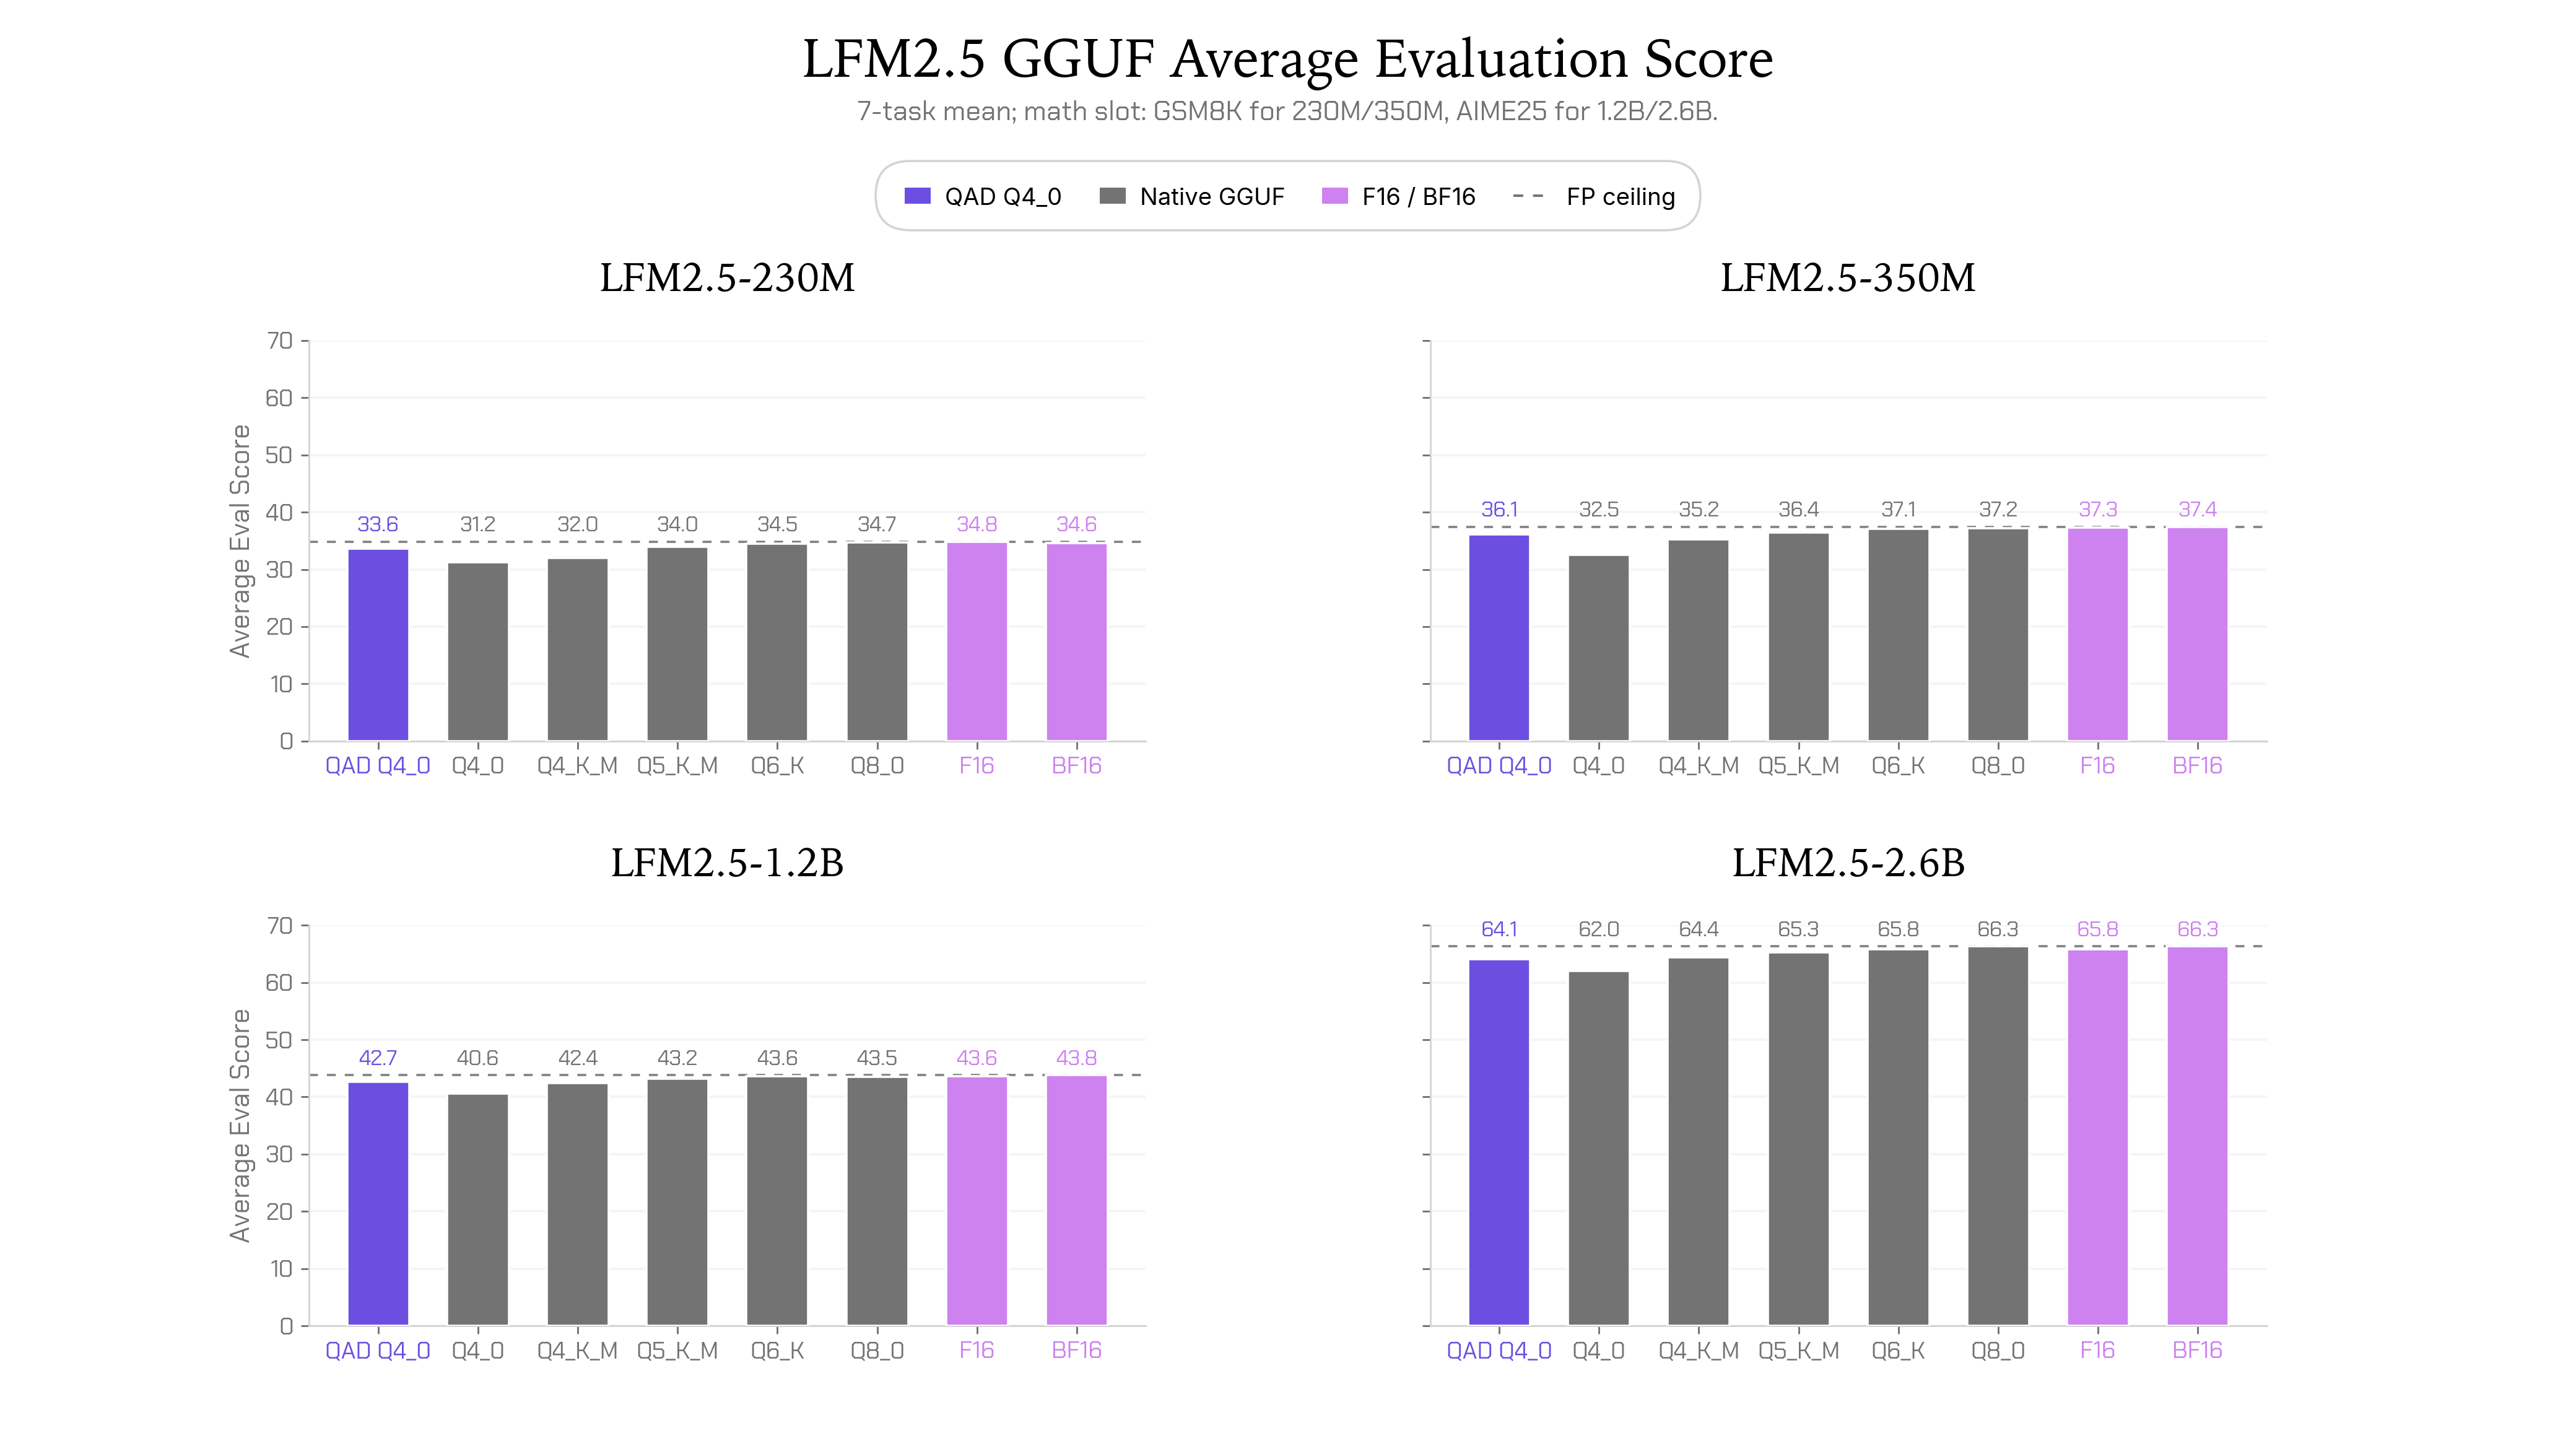
Liquid AIは2026年8月19日、LFM2.5の4モデル向けにQuantization-Aware Distillation(QAD)で学習したQ4_0 GGUFチェックポイントを公開した。230M/350M/1.2B-Instruct/2.6Bの4サイズで、従来の事後量子化(PTQ)によるQ4_0の品質低下を大幅に回復し、BF16平均精度の96.5〜97.4%を維持すると報告。Q4_0の低メモリ・高スループットは保ったまま、実機ベンチでもQ5_K_MやQ4_K_M並みの品質をより高速に達成するとしている。
Liquid AIは2026年8月19日、エッジ向け小規模言語モデル「LFM2.5」ファミリーの4サイズ向けに、Quantization-Aware Distillation(QAD)で学習したQ4_0 GGUFチェックポイントをHugging Faceで公開した。対象はLFM2.5-230M/LFM2.5-350M/LFM2.5-1.2B-Instruct/LFM2.5-2.6B。高精度の教師モデルを量子化済みの生徒モデルへ蒸留することで、従来の事後量子化(PTQ)で生じる品質低下を学習時に補正し、Q4_0の低メモリ・高スループットを保ったままBF16平均精度の約97%を回復したとしている。
 出典:
何が公開されたか — QADで鍛えたQ4_0 GGUF
- 公開されたのは、4モデルそれぞれのQAD Q4_0 GGUF。ファイル名は
LFM2.5-*-QAD-Q4_0.ggufで、Hugging Faceの各モデルリポジトリ(LiquidAI/LFM2.5-*-GGUF)で配布される - Quantization-Aware Distillation(QAD):高精度(BF16)の教師モデルを、量子化されたQ4_0の生徒モデルへ蒸留する学習手法。PTQ(学習なしの変換)ではなく、量子化を前提に学習することで誤差を補正する
- メモリと速度はネイティブQ4_0と同等:QAD版は従来のQ4_0 GGUFと同じフットプリントとスループットを維持するとしている
- 利用は llama.cpp 互換ランタイムでそのまま可能。例:
llama-cli -hf LiquidAI/LFM2.5-350M --hf-file LFM2.5-350M-QAD-Q4_0.gguf -p "What is C. elegans?" - ライセンスや配布形態は各HFリポジトリのモデルカードに準拠する
ベンチマーク — PTQ Q4_0からの回復と上位量子化フォーマットとの比較
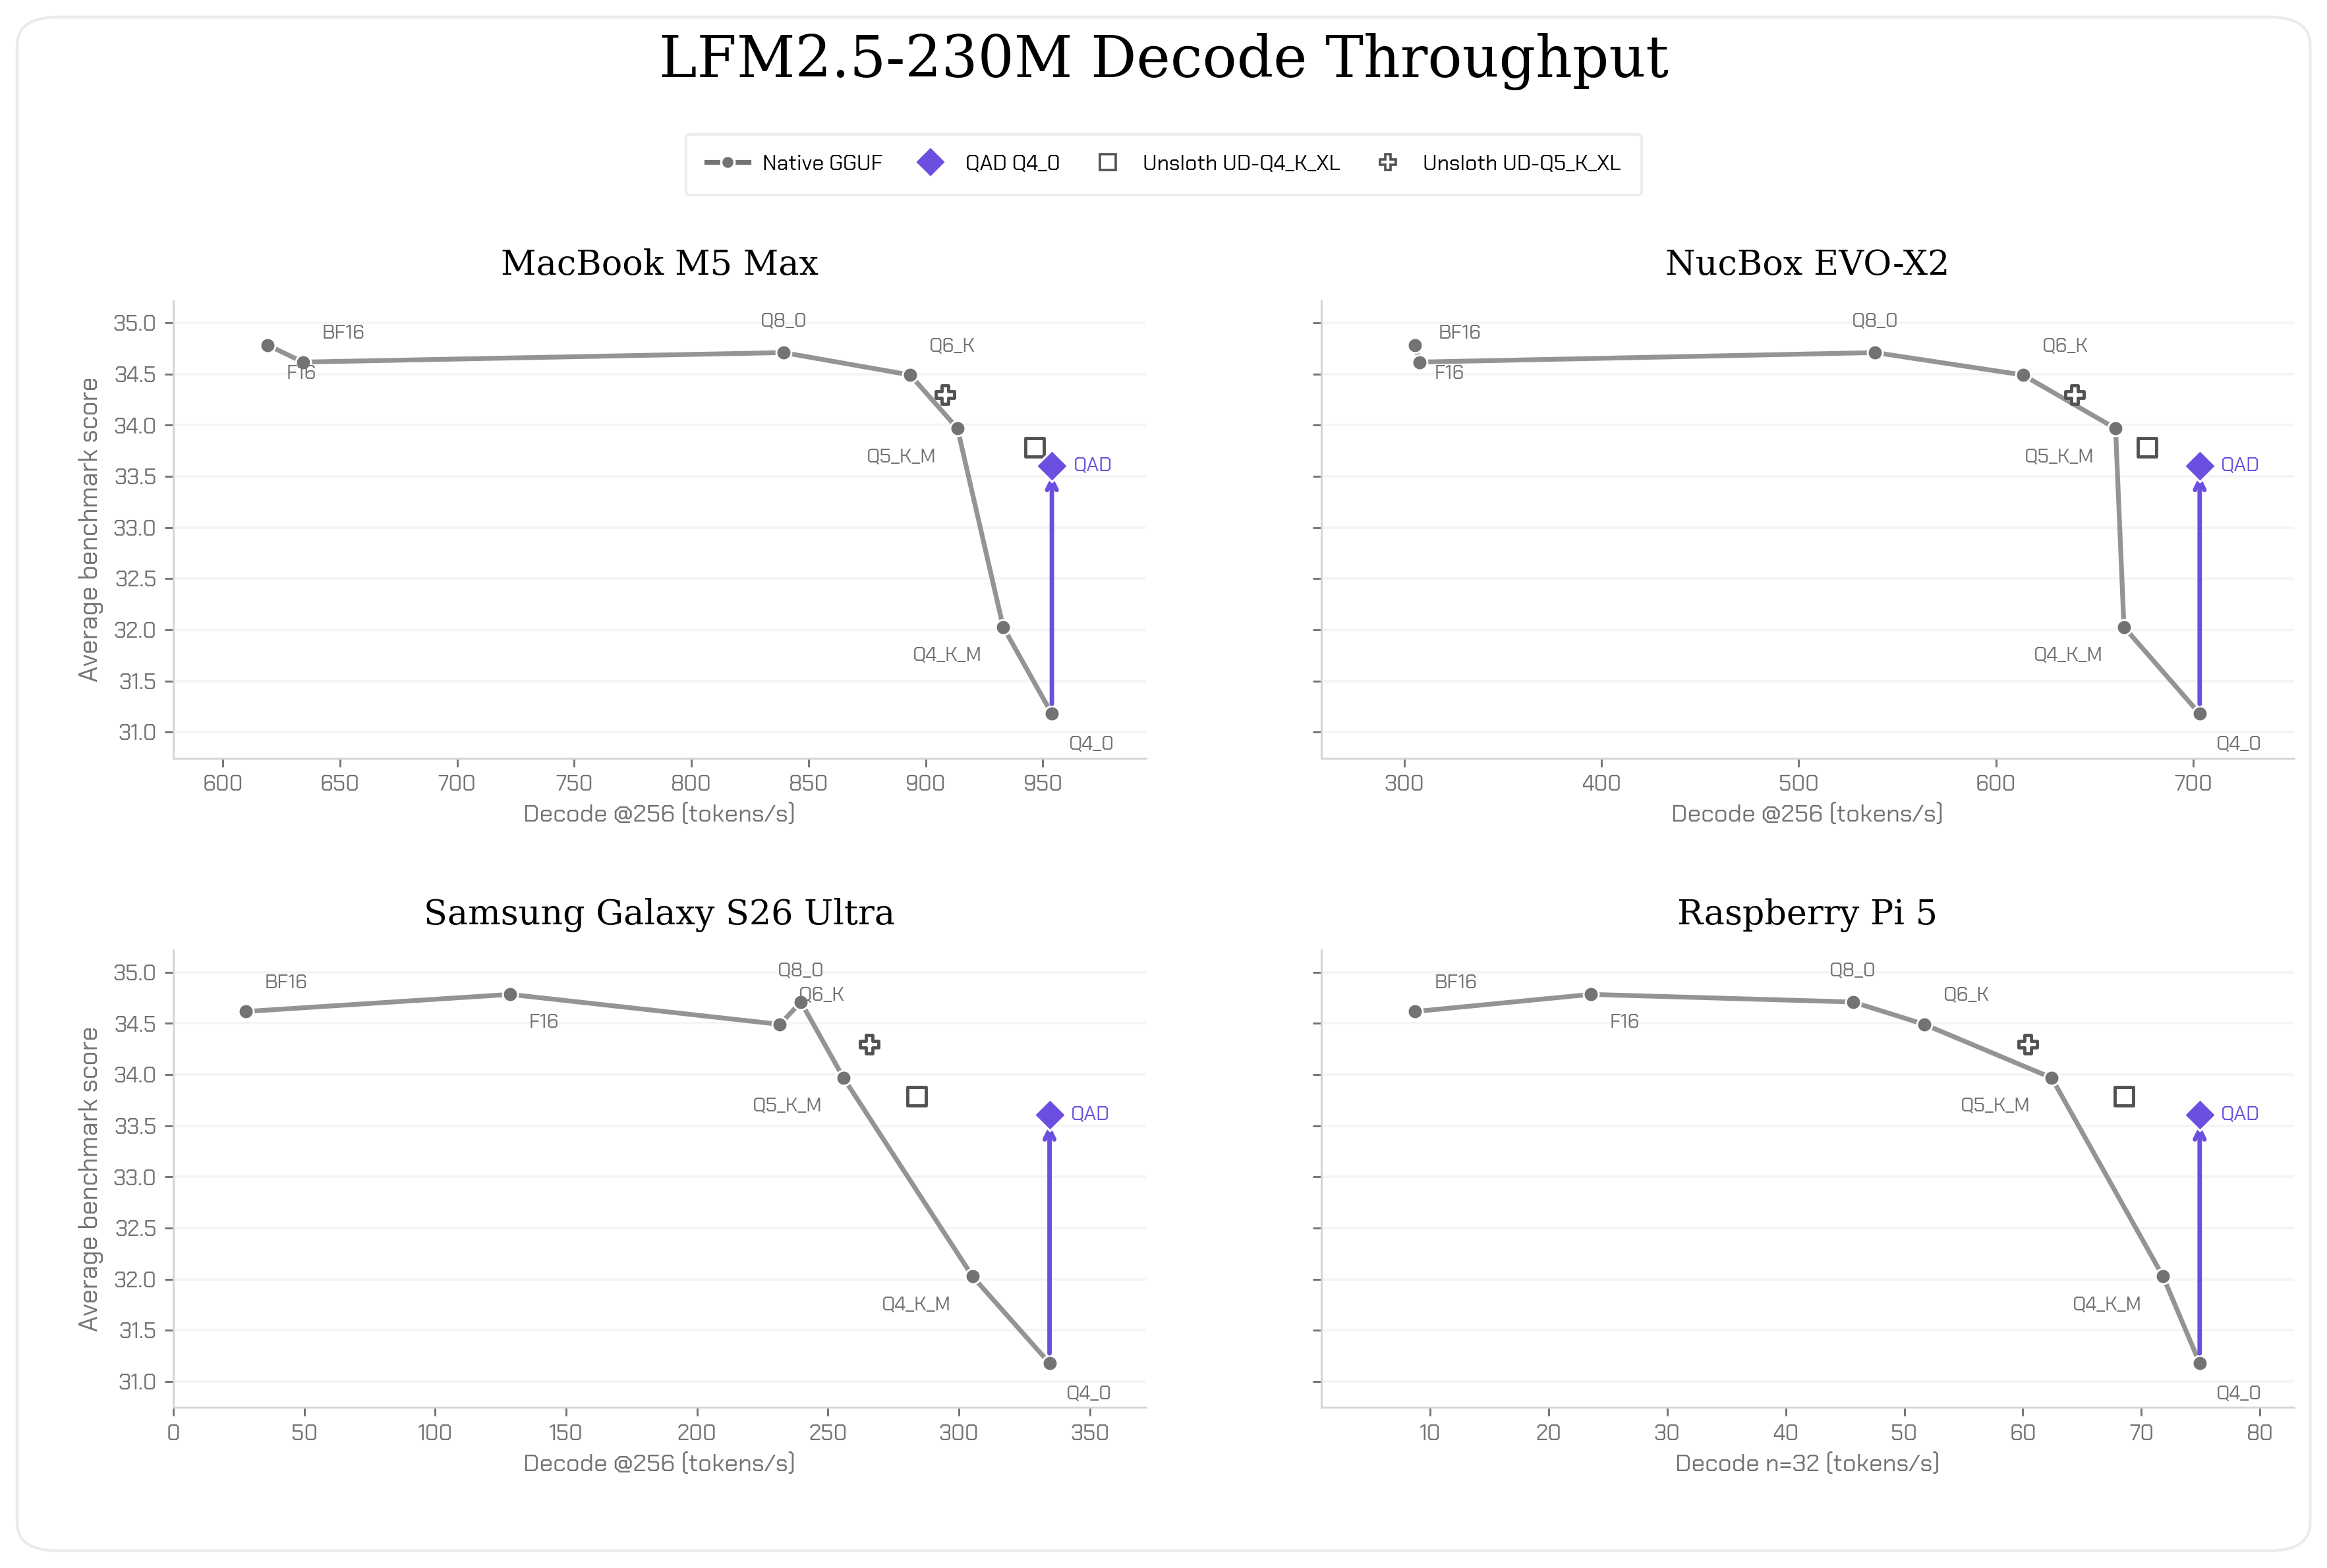
Liquid AIは、公開済みGGUF(PTQ)とQAD Q4_0、BF16 GGUF(フォーマット上の上限)を同一条件で比較した。評価は推論・指示追従・ツール利用・エージェント能力をカバーする GPQA Diamond/MMLU-Pro/IFEval/IFBench/Multi-IF/BFCLv4 に、スケールに応じた数学タスク(230M/350MはGSM8K、1.2B/2.6BはAIME25)を加えた7種。5回反復の平均を報告している。
 出典:
- 全体傾向:4モデルすべてでQAD Q4_0がPTQ Q4_0を大幅に上回る
- BF16に対する保持率:QAD Q4_0はBF16平均精度の 97.1%(230M)/96.5%(350M)/97.4%(1.2B-Instruct)/96.6%(2.6B) を保持。すなわち「量子化で失われた精度の97%を回復」した計算になる
- 上位フォーマットとの比較:より高ビット・高品質とされるフォーマットとの対比でも効率を示す
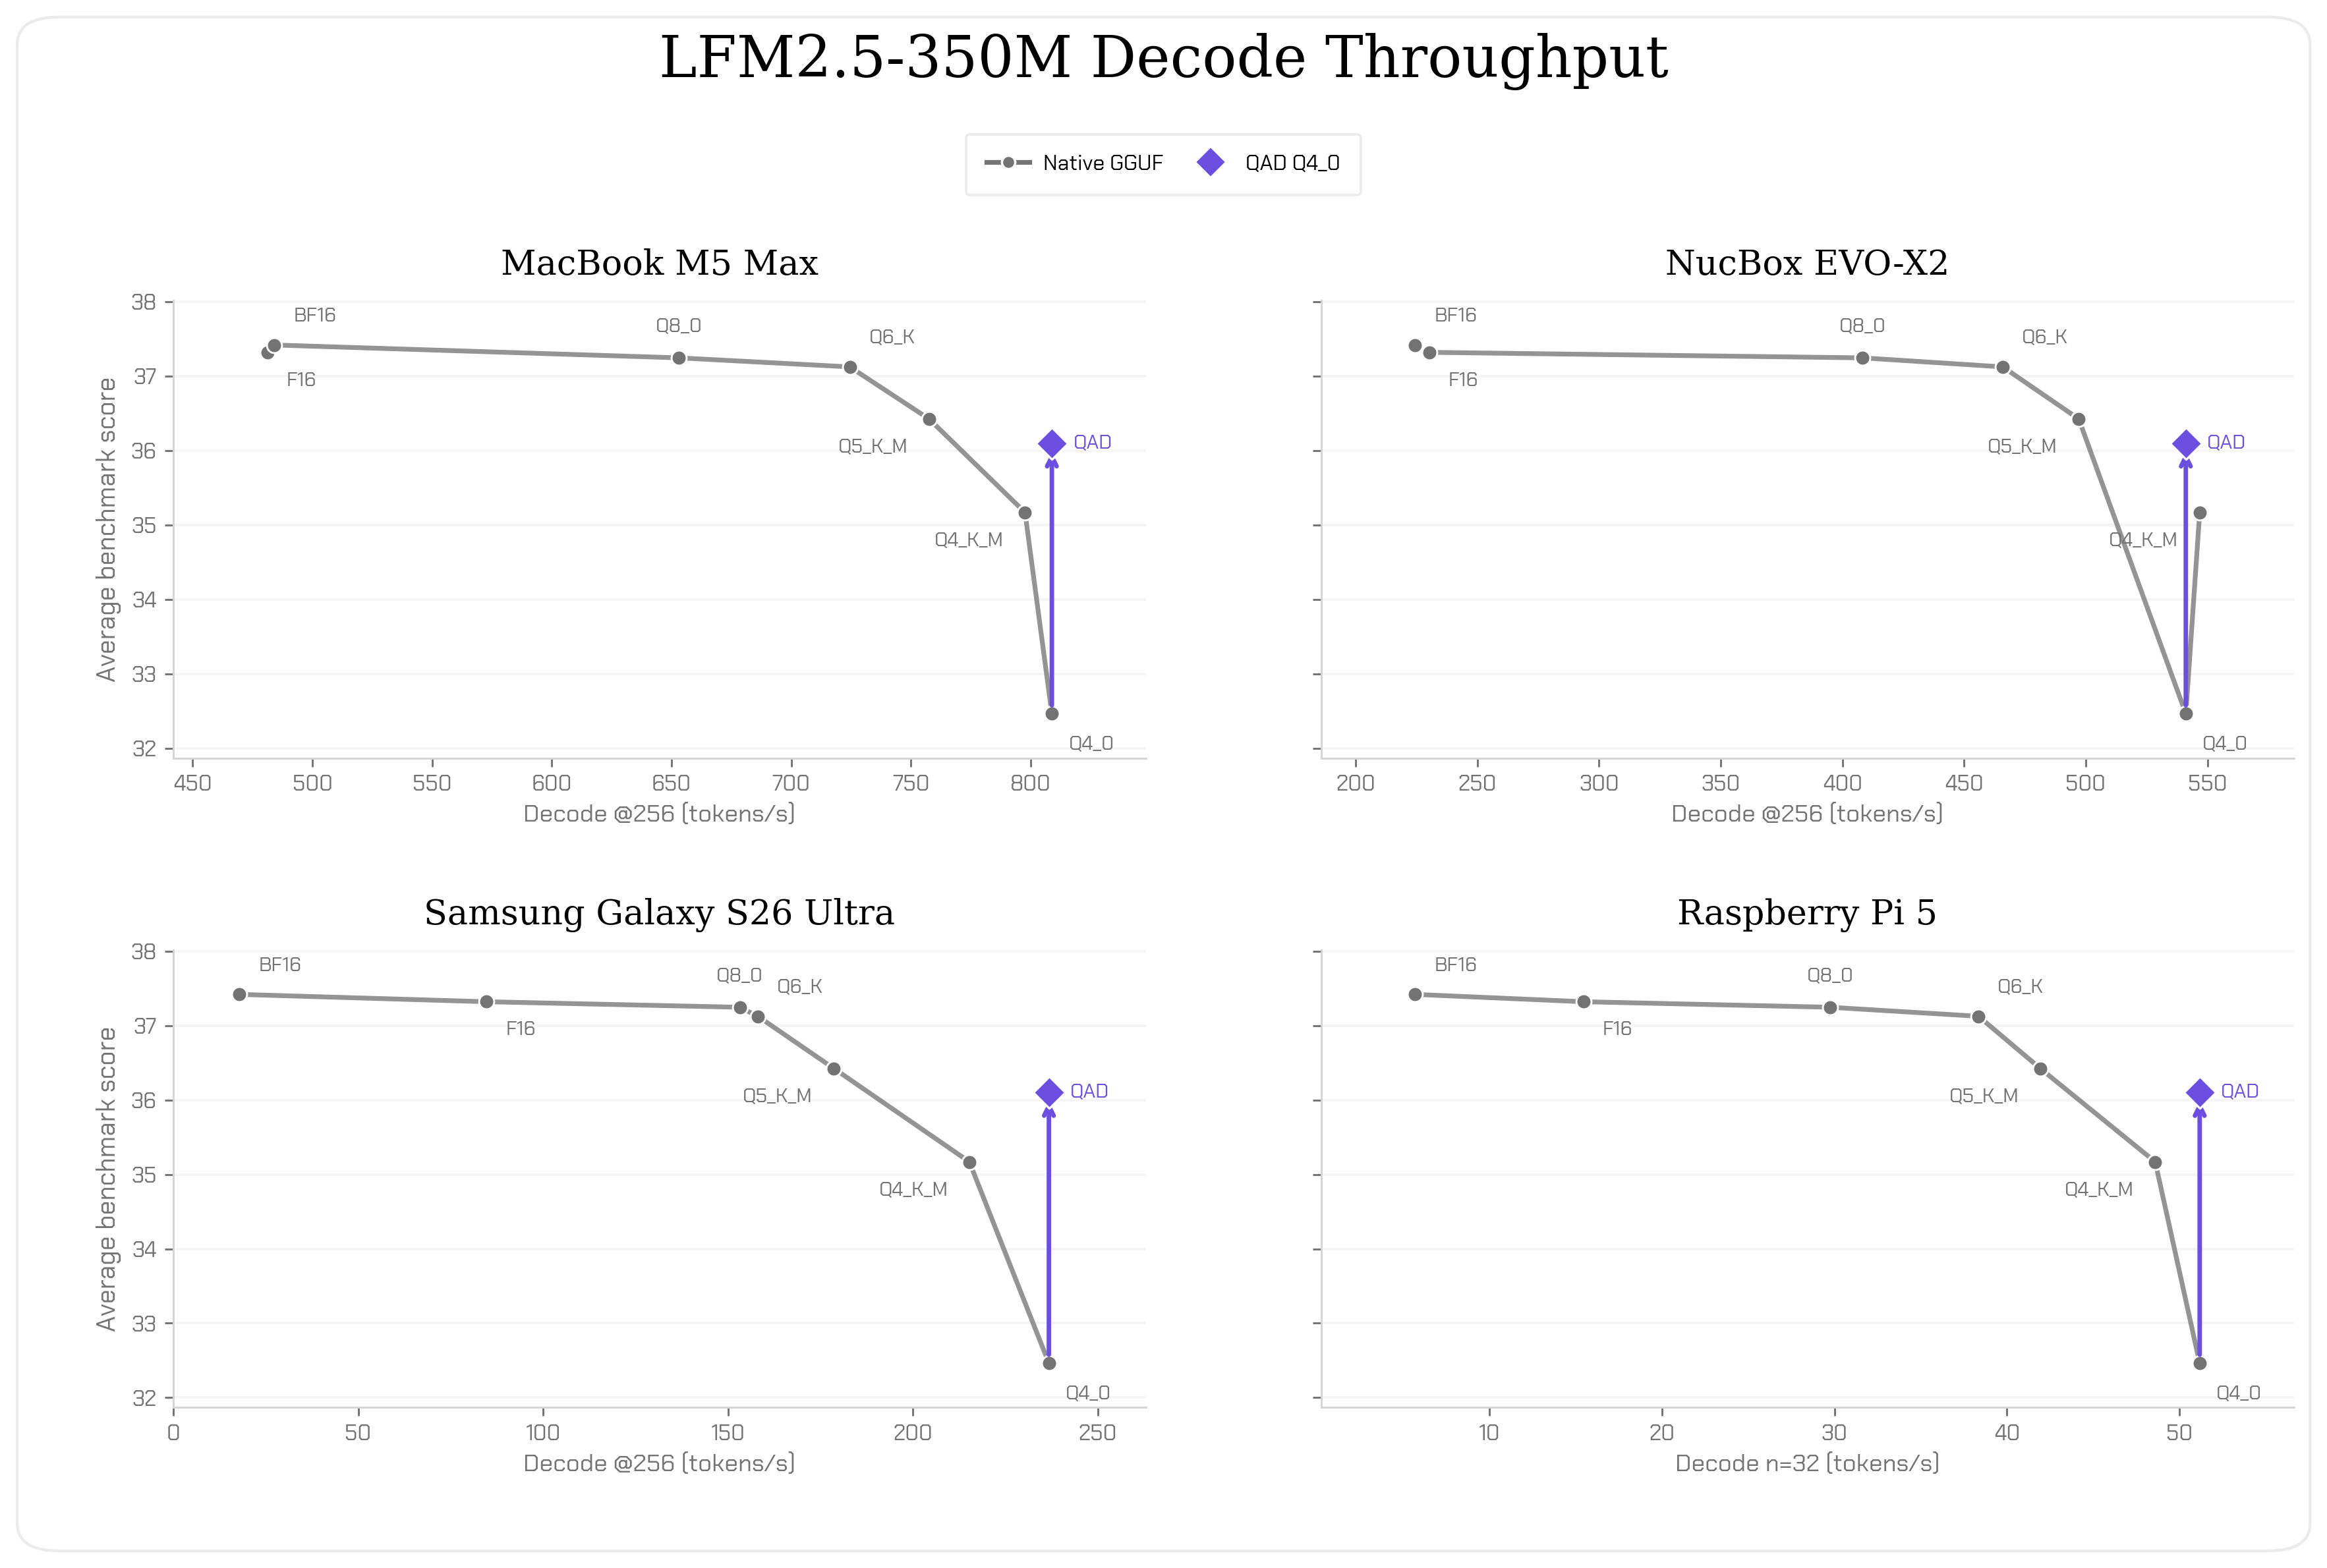
- 230M/350M:QAD Q4_0は Q5_K_M 並みの品質を、評価分散の範囲内で達成しつつデコードスループットは4〜33%高い
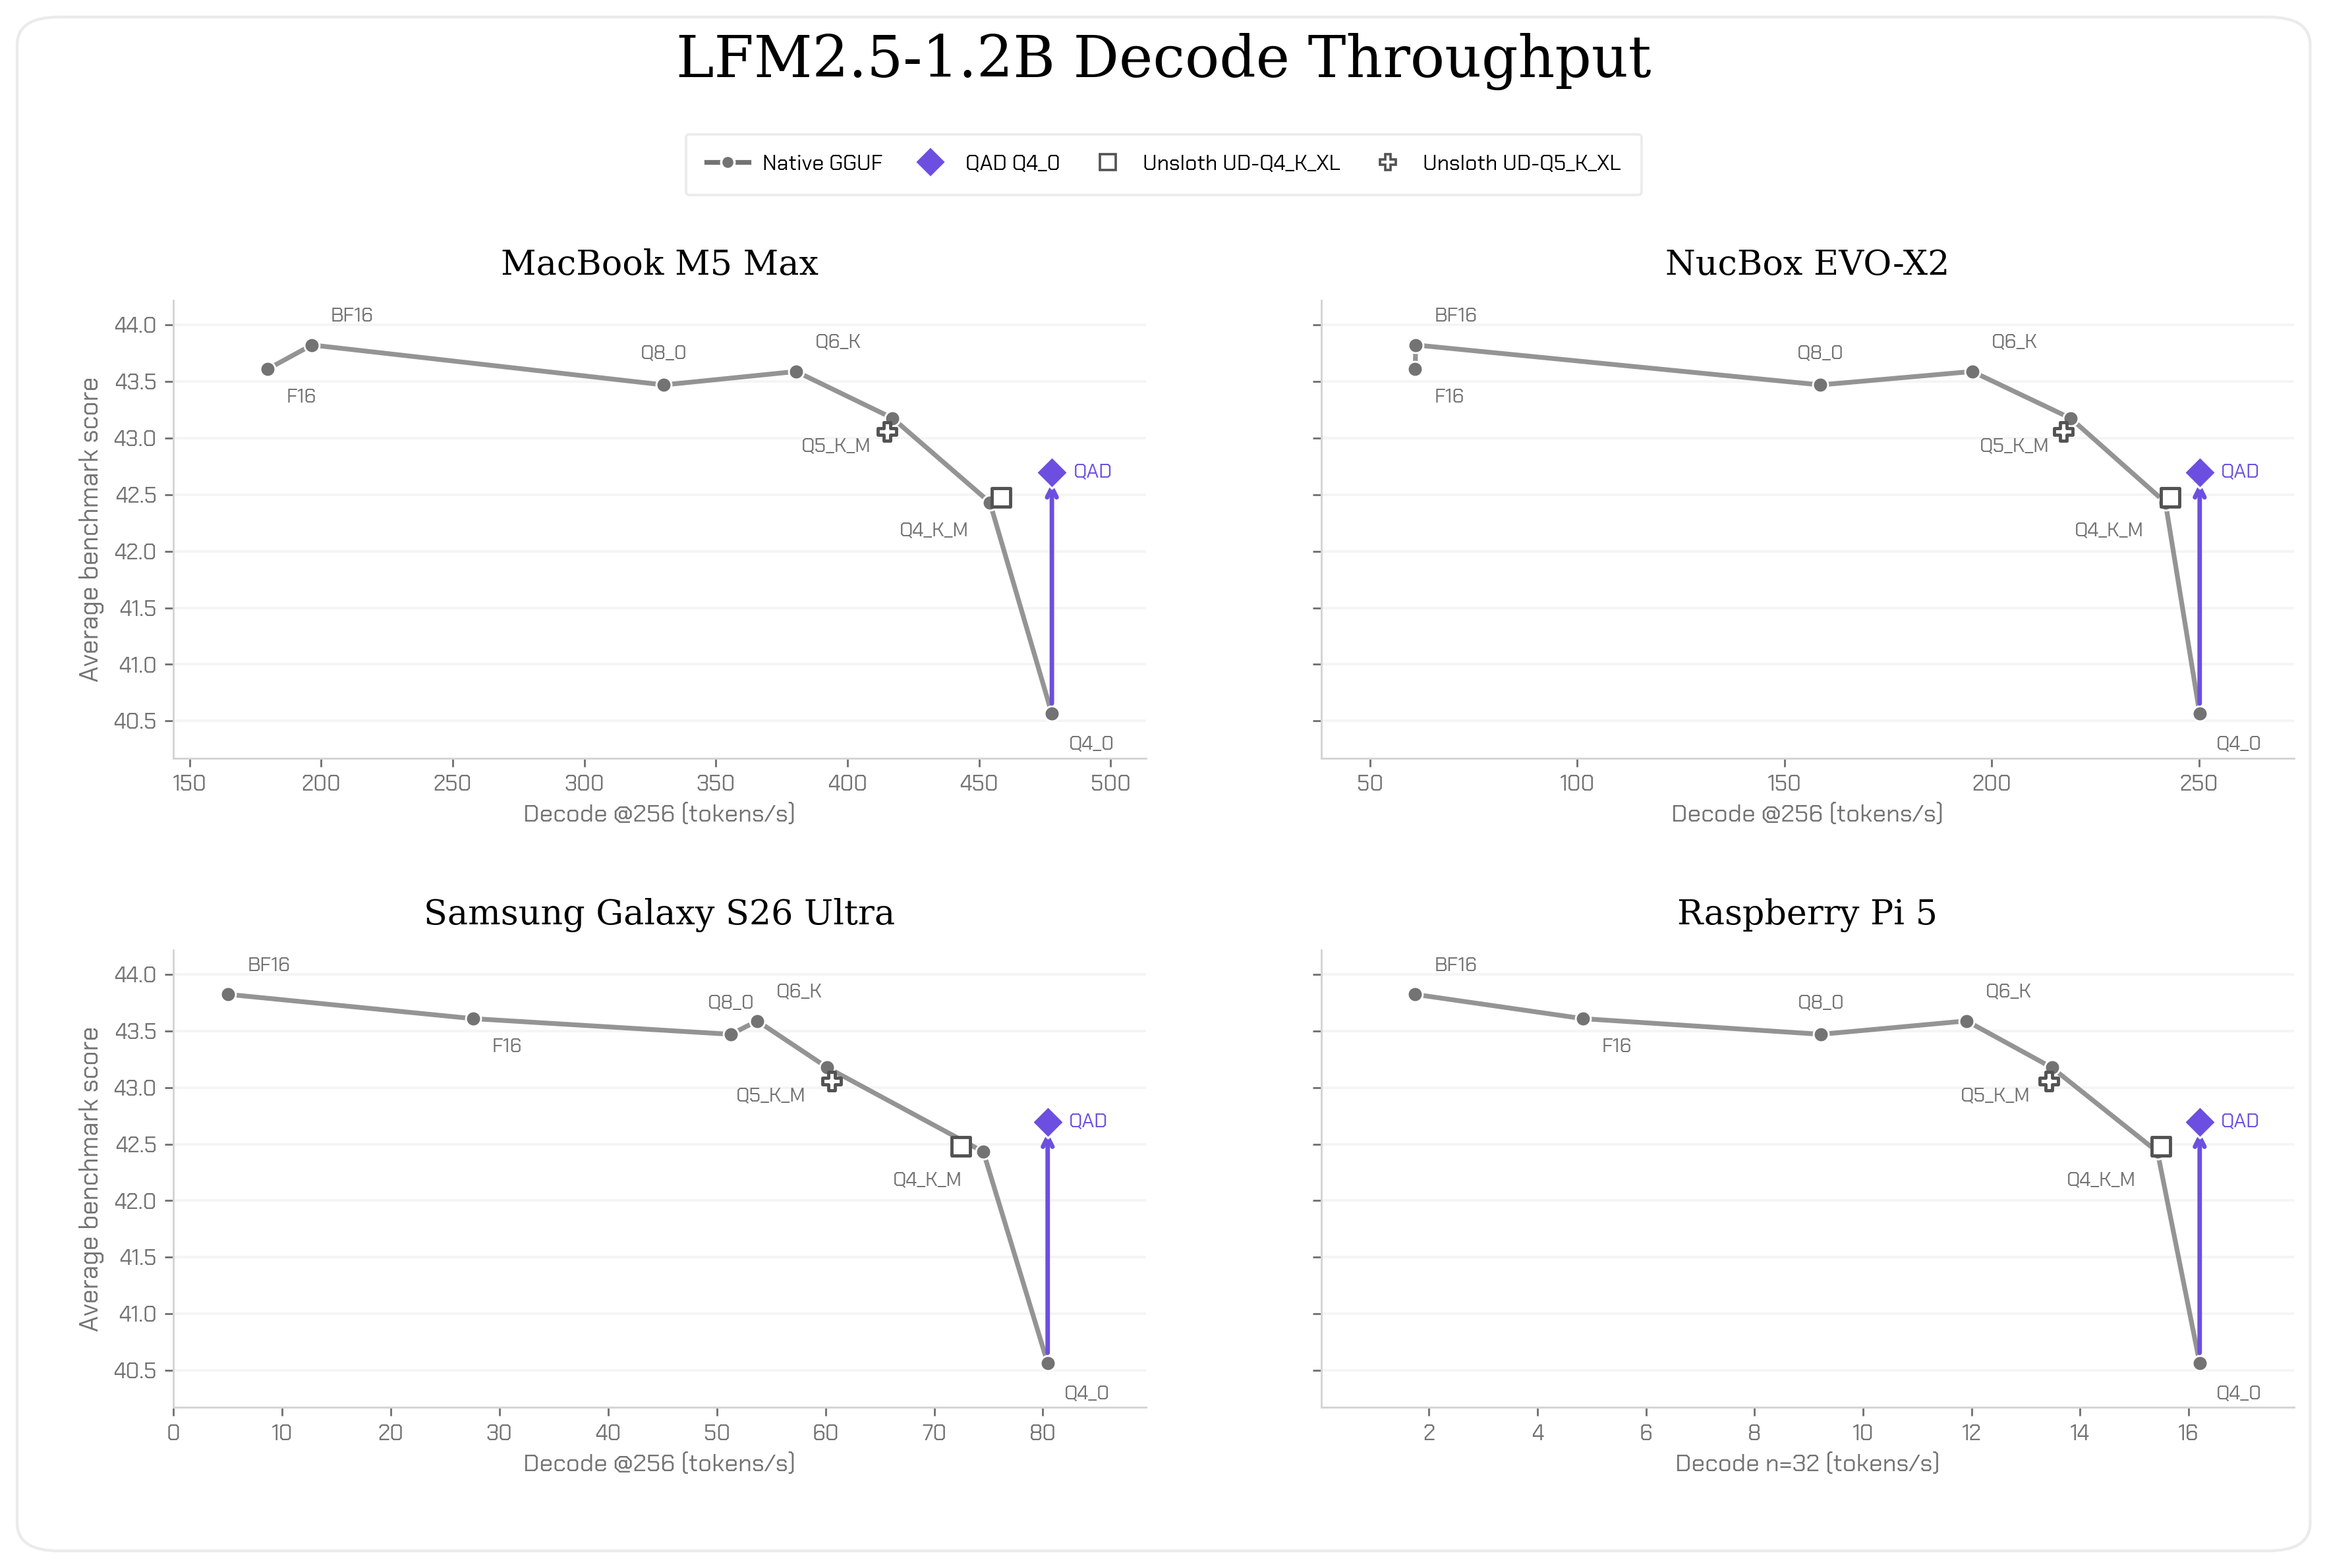
- 1.2B/2.6B:QAD Q4_0は Q4_K_M 並みの品質を3〜14%高いスループットで達成
- 外部PTQとの比較:230Mと1.2Bでは、強力な外部PTQである Unsloth UD-Q4_K_XL と同等の品質に達したとしている
- いずれもベンダー自身による同一ベンチマーク内比較であり、独立した第三者評価ではない点に留意が必要
実機での速度とサイズ — エッジデバイス4種で計測
 出典:
 出典:
- 計測環境は MacBook Pro/NucBox EVO-X2(GPU推論) と Samsung Galaxy S26 Ultra/Raspberry Pi 5(Arm CPU推論) の4種。BF16/F16をフル精度参照として併記している
- 結果として、QAD Q4_0は従来のQ4_0と同等のサイズ・速度を維持しながら、上位ビット相当の品質をより低いコストで提供する位置づけになる
- エッジでのローカルエージェント実行やオフライン推論など、メモリとレイテンシが制約となる用途での恩恵が期待される
入手方法と位置づけ
- 入手先:Hugging Faceの各GGUFリポジトリで即日利用可能 — LFM2.5-230M/LFM2.5-350M/LFM2.5-1.2B-Instruct-GGUF/LFM2.5-2.6B-GGUF
- 使い方:llama.cppやGGUF Q4_0対応ランタイムでそのまま読み込み可能。既存のQ4_0ワークフローを差し替える形で導入できる
- 位置づけ:LFM2.5はLiquid AIがエッジ推論向けに展開する小規模モデルファミリー。今回のQAD GGUFは、「4ビットの効率」と「フル精度に近い品質」の両立を学習手法で実現するアプローチとして、PTQ後の補正ではなく学習段階から量子化を織り込む点が特徴
本記事の数値・比較はすべて一次情報(Liquid AIのHugging Faceブログ)に基づく。ベンチマークは同社が選定した7種の平均であり、実タスクでの品質・速度はデバイス、プロンプト、推論設定により変動する。導入時は自身のワークロードでの再計測が推奨される。
出典:
