

IMAGE: AI生成ビジュアル
MODELS / MODELS
Liquid AI、LFM2.5向けDSparkドラフトを公開 — 推論を最大3.2倍高速化、品質はそのままにllama.cpp / SGLang対応
Liquid AIは2026年8月20日、LFM2.5ファミリー向けの投機的デコーディング用ドラフトモデル「DSpark」を公開した。LFM2.5-1.2B-Instruct/2.6B/8B-A1Bの3モデルに対し各約300Mパラメータのドラフト(5層・ブロック9)を用意し、llama.cpp(Metal)とSGLang(H100)で最大3.18倍のスループット向上を報告。greedyでは出力は同一のためベンチマーク精度は不変とし、関数呼び出しのレイテンシは平均57%削減するとしている。
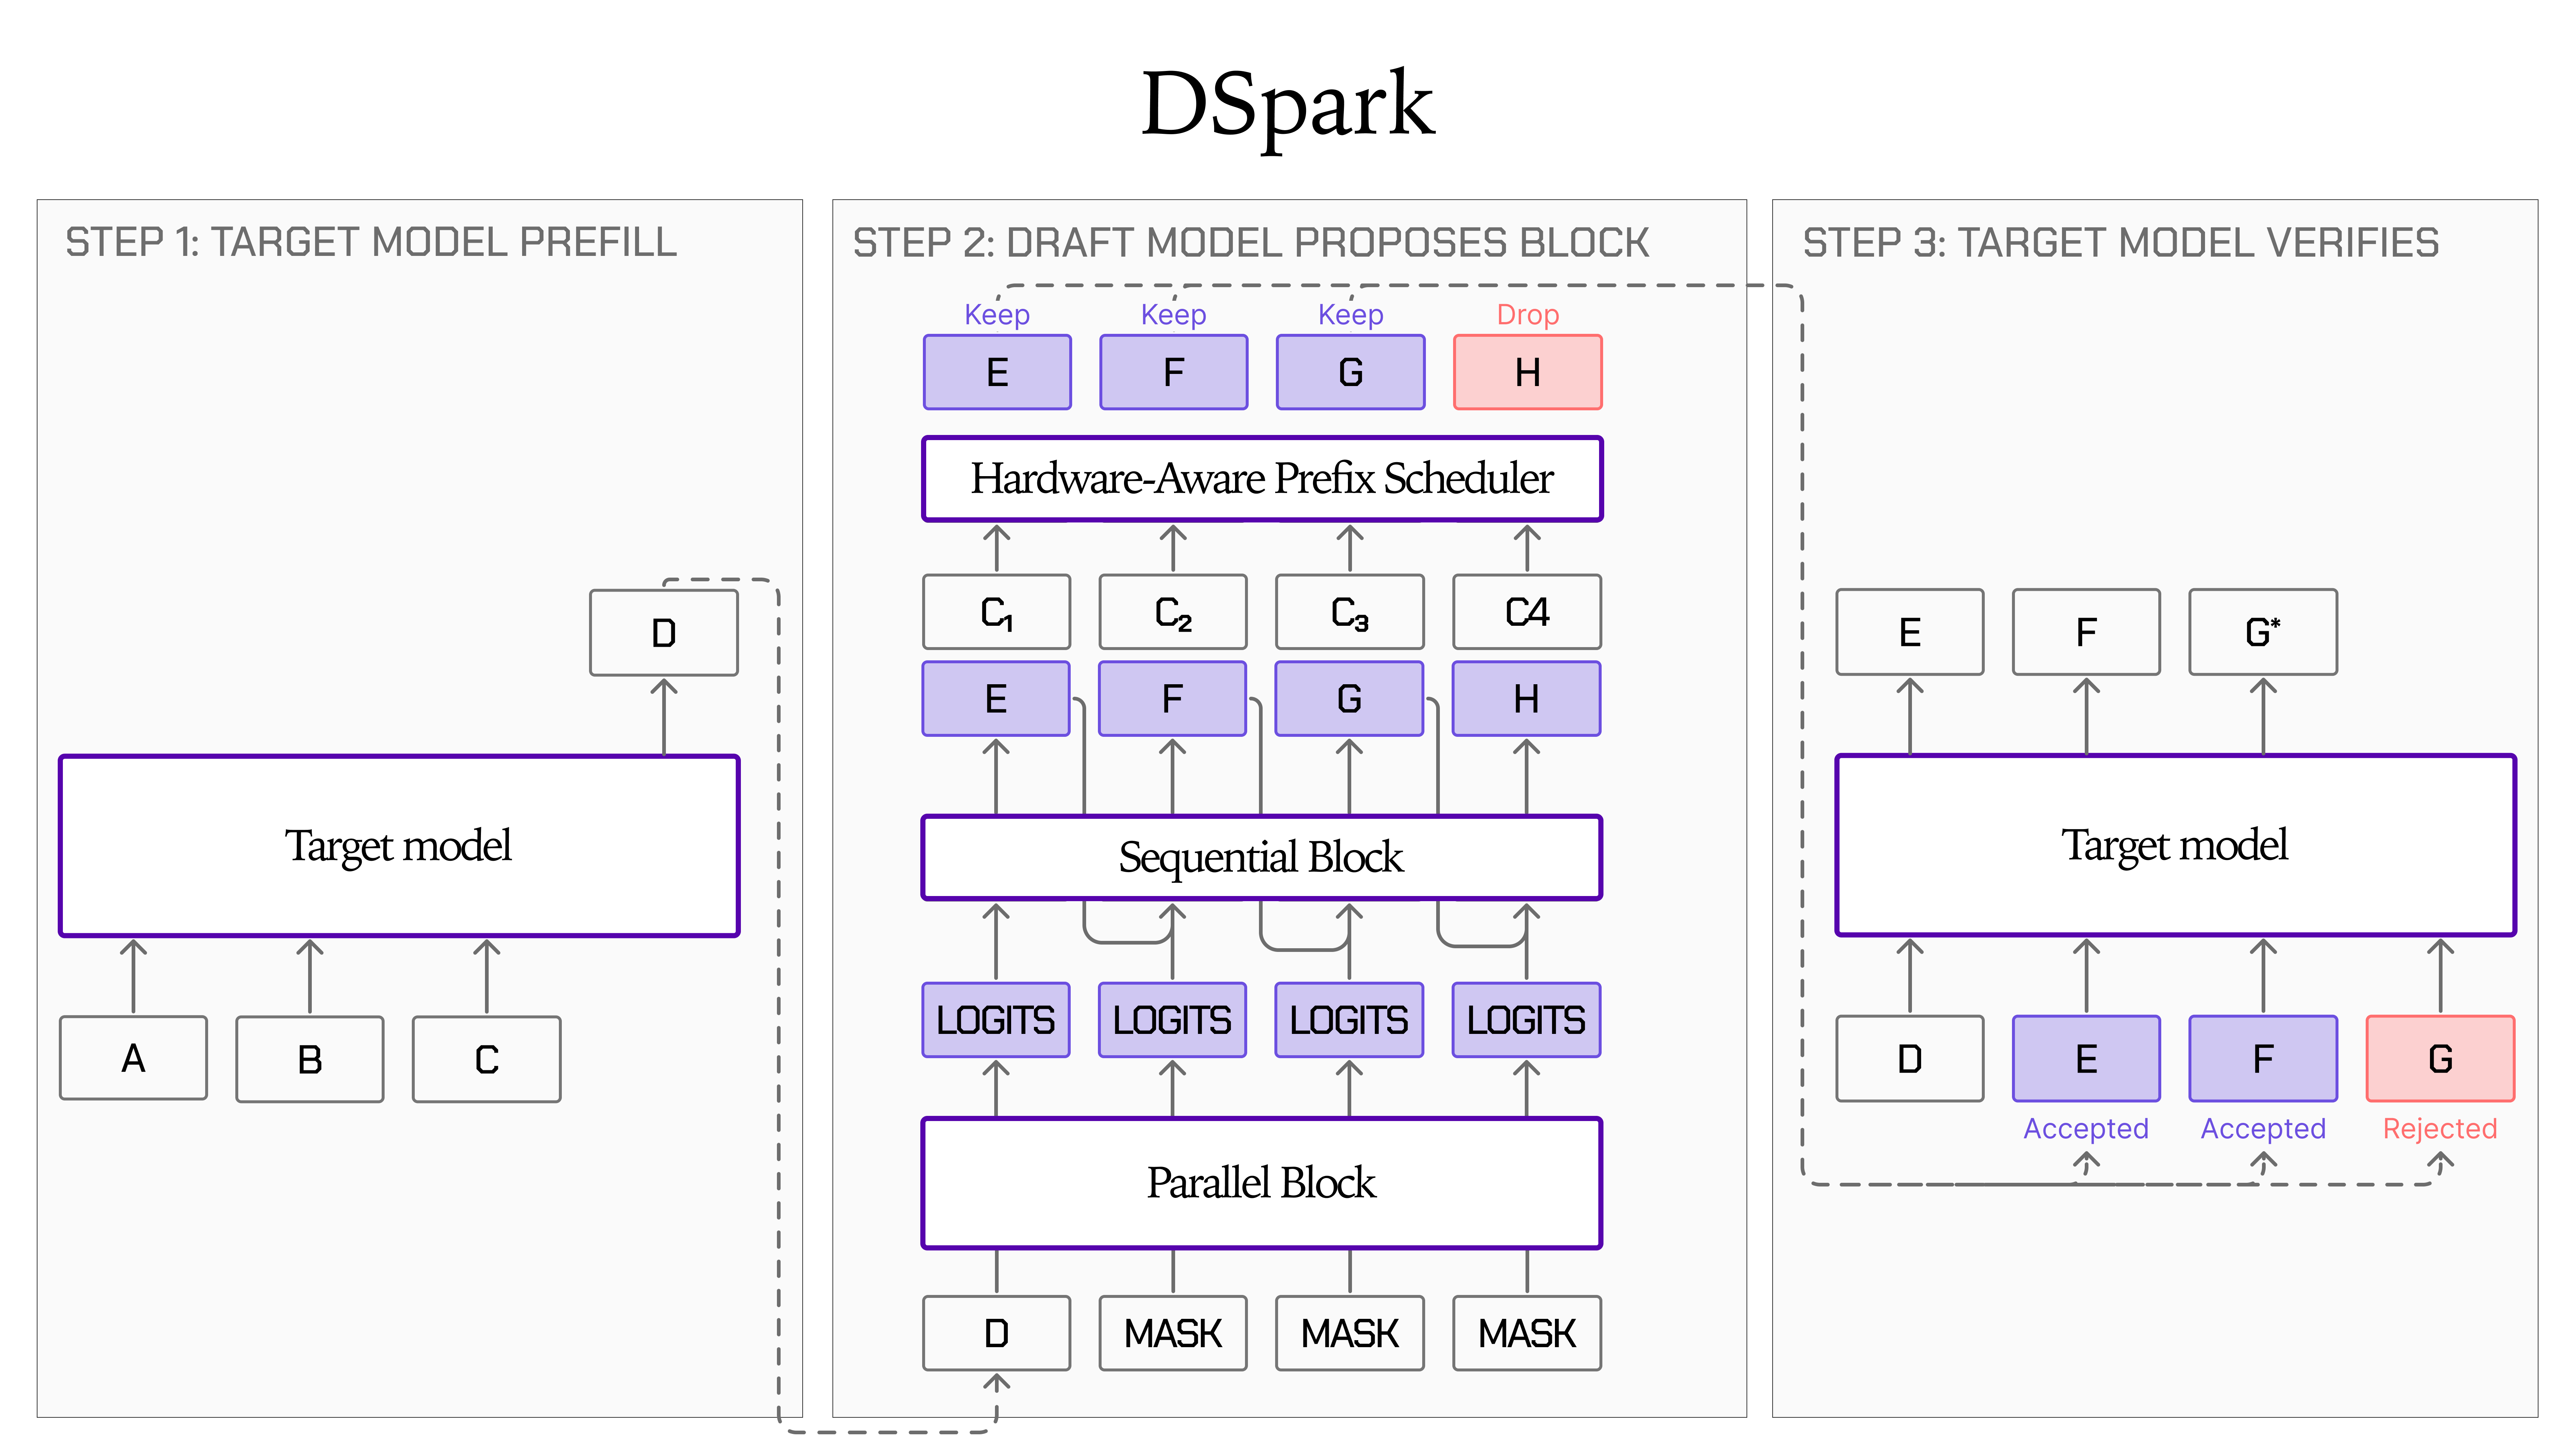
Liquid AIは2026年8月20日、エッジ向けモデルファミリーLFM2.5向けの投機的デコーディング(speculative decoding)用ドラフトモデルLFM2.5-DSparkをHugging Faceで公開した。対象はLFM2.5-1.2B-Instruct/LFM2.5-2.6B/LFM2.5-8B-A1Bの3モデルで、各モデルに対応する約300Mパラメータのドラフト(5層・アテンション特化、ブロックサイズ9)を提供する。llama.cpp(Metal)とSGLangにday-oneで対応し、品質を変えずにデコードを大幅高速化できるとしている。
 出典: Up to 3.2x Faster Inference with LFM2.5-DSpark — Hugging Face Blog (Liquid AI, 2026-08-20)
DSparkとは — 軽量ドラフトが候補を一括生成、ターゲットが一括検証
LLM推論のデコード段階は、重みをDRAMからSRAMへ流すメモリバウンドが支配的で、計算そのものより転送が律速になる。投機的デコーディングは、軽量なドラフトモデルが候補トークンを先に生成し、ターゲットモデルが1回のフォワードパスで一括検証することで、重みロードのコストを複数トークンで共有する。
Liquid AIが採用したDSpark(論文 2607.05147)は、従来のEAGLE-3やDFlashの発展形で、3要素からなる。
- DFlash型の並列バックボーン: ターゲットモデルのコンテキスト特徴を条件に、全ドラフトトークンの隠れ状態を1回のフォワードで並列生成
- 軽量な逐次ヘッド(マルコフ連鎖): 隣接トークン間の依存をモデル化し、後方位置での受理率を向上
- 信頼度スケジュール検証器(confidence-scheduled verifier): 各トークンの生存確率を予測し、検証コストが利益を上回る低信頼な末尾を枝刈り
学習はSFT/チャット/コード/関数呼び出しを含むより大規模で多様な混合データで行い、各ドラフトは15エポック学習して損失最小ではなく受理率最大のエポックを選択した。初期版はアブレーションに基づきアテンション特化の簡素なドラフトとしている。
| コンポーネント | LFM2.5-1.2B-Instruct | LFM2.5-8B-A1B | LFM2.5-2.6B |
|---|---|---|---|
| Decoder stack(5層) | 241.2M | 241.2M | 241.2M |
| Hidden-state projection | 21.0M | 21.0M | 21.0M |
| Markov head | 33.6M | 65.5M | 65.5M |
| Norms + confidence head | 27.5k | 27.5k | 27.5k |
| 合計 | 295.7M | 327.7M | 327.7M |
メモリ増加は最小限に抑えつつ、検証時の重み共有でスループットを大きく引き上げる設計としている。
精度は不変 — greedyでは出力が同一
投機的デコーディングでは、greedy設定でドラフトの候補がターゲット分布と一致した場合のみ受理し、不一致ならターゲット自身のトークンに置換される。したがって出力列はベースラインのgreedyと同一になることが保証され、ベンチマーク精度(pass@1や完全一致)は不変だとLiquid AIは説明している。
推論速度 — H100で最大3.18倍、M4 Maxで最大2.87倍
評価はllama.cpp+Metal(M4 Max MacBook Pro、FP16 GGUF、最大256出力トークン)とSGLang(H100 80GB単一、BF16)の2環境で実施。いずれもDSparkブロック9、バッチ1、temperature 0の条件で、MATH500/HumanEval/MBPP/GSM8K/MT-Benchの5データセットで計測した。
LFM2.5-2.6B — 平均2.67倍(H100)/2.27倍(M4 Max)
| データセット | 受理率(/10) | H100(SGLang) | M4 Max(llama.cpp) |
|---|---|---|---|
| MATH500 | 5.42 | 3.06倍 326→1000 tok/s | 2.25倍 61→137 tok/s |
| HumanEval | 4.54 | 2.56倍 326→835 tok/s | 2.63倍 61→161 tok/s |
| MBPP | 4.71 | 2.64倍 326→861 tok/s | 2.11倍 62→132 tok/s |
| GSM8K | 4.32 | 2.22倍 312→693 tok/s | 2.36倍 60→143 tok/s |
| MT-Bench | 5.07 | 2.87倍 325→933 tok/s | 1.99倍 62→123 tok/s |
| 平均 | 4.81 | 2.67倍 323→864 tok/s | 2.27倍 61→139 tok/s |
M4 Maxでは約140 tok/s前後に達し、クラウドの多くのプロプライエタリモデルを上回るインタラクティブ性をエッジで実現するとしている。
LFM2.5-1.2B-Instruct — 平均2.10倍(H100)/2.54倍(M4 Max)
| データセット | 受理率(/10) | H100 | M4 Max |
|---|---|---|---|
| MATH500 | 6.02 | 2.56倍 668→1712 tok/s | 2.62倍 140→366 tok/s |
| HumanEval | 5.31 | 2.26倍 664→1499 tok/s | 2.87倍 136→389 tok/s |
| MBPP | 5.52 | 2.37倍 667→1578 tok/s | 2.74倍 137→375 tok/s |
| GSM8K | 4.34 | 1.67倍 624→1041 tok/s | 2.73倍 140→381 tok/s |
| MT-Bench | 3.90 | 1.66倍 657→1091 tok/s | 1.72倍 137→237 tok/s |
| 平均 | 5.02 | 2.10倍 656→1384 tok/s | 2.54倍 138→350 tok/s |
データセットによる受理率のばらつきが大きく、分布により高速化が最大52%変動するとしている。
LFM2.5-8B-A1B(MoE) — H100で最大3.18倍、M4 Maxでは平均1.18倍
- H100: MATH500で**3.18倍(428→1362 tok/s)**など、受理率8.27/10と高く大幅高速化
- M4 Max: 平均1.18倍にとどまる。原因として、llama.cppのMetalバックエンドにおける現行MoE実装と、kトークン検証時に活性化するエキスパート数と重み転送量が単一デコードより増えることを挙げている
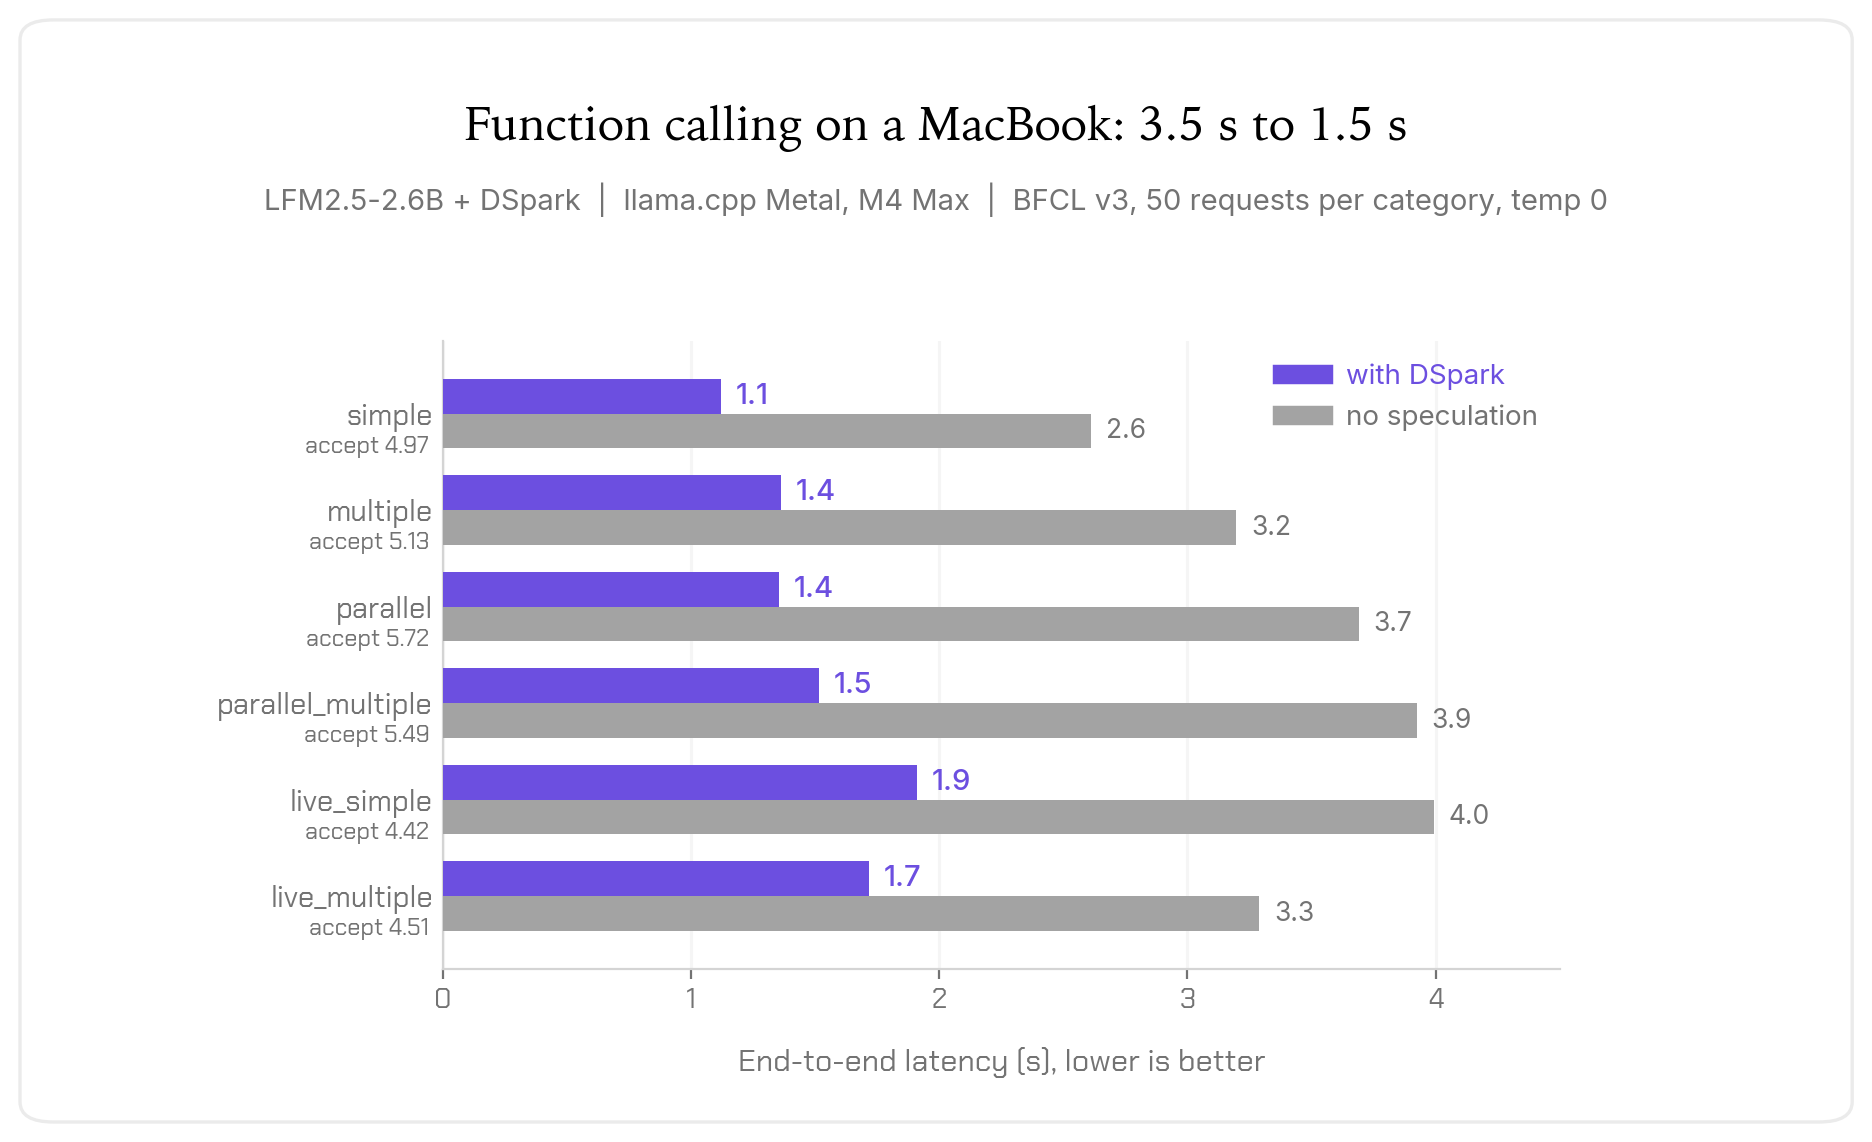
エージェント推論 — 関数呼び出しのレイテンシを平均57%削減
 出典: Up to 3.2x Faster Inference with LFM2.5-DSpark — Hugging Face Blog (Liquid AI, 2026-08-20)
LFM2.5-2.6Bでは、複数ツールを伴う関数呼び出しシナリオでレイテンシを平均57%削減したと報告。オンデバイスでのエージェント的な推論(ツール呼び出しを伴う逐次実行)での体感改善を強調している。
使い方 — llama.cppとSGLangにday-one対応
- llama.cpp: Liquid AIによるLFM互換DSpark統合(公式コードベース上の実装、Metalカーネルは実験的)としてオープンソースで提供
- SGLang: SGLang公式のDSpark実装をベースにした統合として提供
- 入手先: Hugging Faceブログでドラフトチェックポイントを公開。各LFM2.5モデルと組み合わせて利用する
本記事の数値・比較はすべて一次情報(Liquid AIのHugging Faceブログ、2026-08-20)の公称値に基づく。実環境でのスループットはデバイス、量子化形式、プロンプト長、推論設定により変動する。MoEモデルのオンデバイス性能は実装改善により今後変わり得る。
出典:
