

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / Liquid AI
Liquid AI、エッジ向けオープンウェイト決定モデル「d1-3B」「d1-omni-600M」を公開 — トークン生成なしの単一フォワードパスで回答
Liquid AIは2026年10月7日、決定(decision)タスク専用のオープンモデルd1-3Bとd1-omni-600Mを公開した。トークンを生成せず単一フォワードパスで回答し、d1-3BはDecision Index v0.2.1(公開split)で48.57と10B未満で首位、12倍の規模のDecider 35B-A3Bに並ぶとしている。RTX 4090で8ms、Jetson Orin Nanoでも50msのレイテンシを報告。Hugging Faceで提供中だがライセンスはother扱いのため利用前の確認が必要。
Liquid AIは2026年10月7日、決定(decision)タスク専用のオープンモデル d1-3B と d1-omni-600M を公開した。同社の生成系Liquid Foundation Models(LFMs)とは異なり、d1決定モデルはトークンを生成せず、単一フォワードパスで回答を出す。分類・ルーティング・採点といった構造化された判断を1回の呼び出しで返す用途を想定している。以下は公式ブログとHugging Faceの記載内容の整理であり、性能・速度の数値はすべて同社の公称値である。
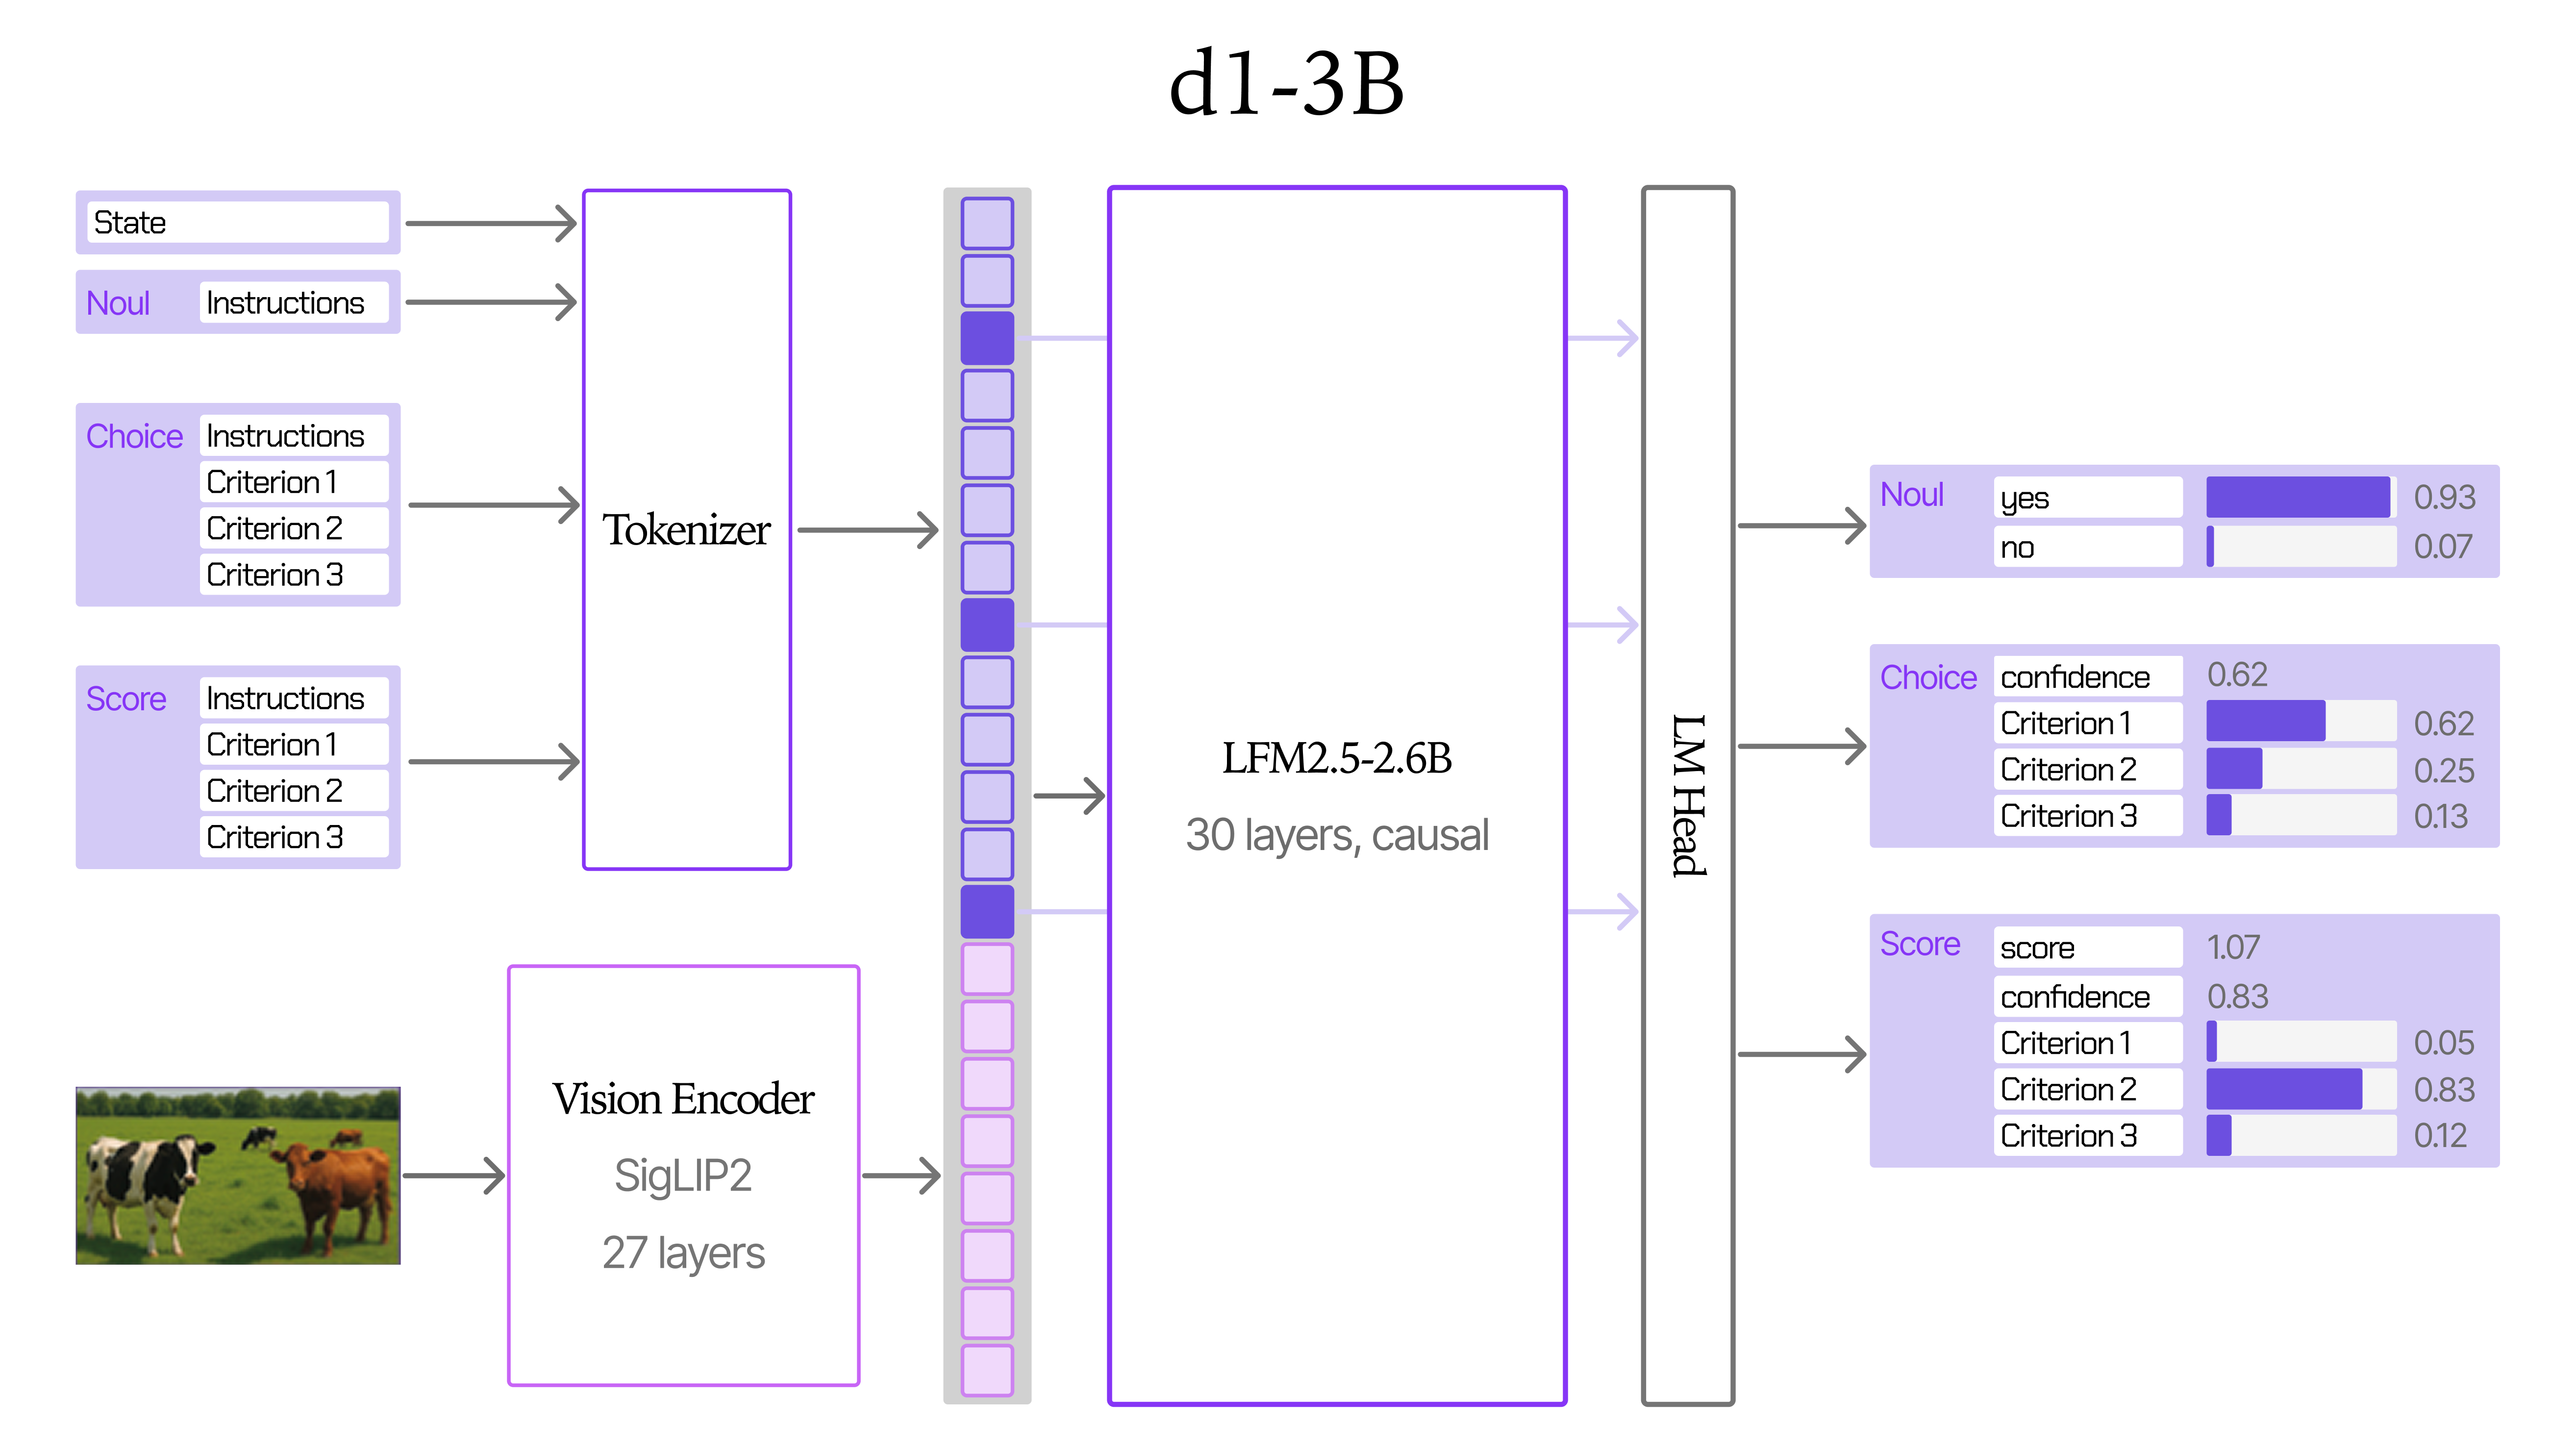
画像出典: Open d1: Edge decision models for text, vision, and audio — Liquid AI Blog(© Liquid AI。アーキテクチャ説明図として転載)
モデルの概要 — 2サイズ、異なる基盤からの学習
- d1-3B: 最新VLMのLFM2.5-VL-3B(デコーダーのみ)を基盤に学習。テキストと画像を入力に取る。LFM2.5-2.6BとLFM2.5-VL-3Bのテキスト基盤の重み平均で土台を作り、異なるシード・データ混合で微調整したチェックポイントを再統合した。長い入力での学習、選択肢のシャッフル、データの近道(shortcut)修正が高度な手法より効果が大きかったとしている。
- d1-omni-600M: 初の実験的チェックポイント。テキスト+画像、またはテキスト+音声を扱う。双方向エンコーダのLFM2.5-Encoder-350Mを決定タスクで微調整後、音声はFastConformerエンコーダ+アダプタ、視覚はLFM2.5-VL-450Mのエンコーダ+アダプタとLoRA更新(画像入力時のみ有効)を段階的に追加し、最終的にLoRAを統合・重み平均で正則化した。
- 提供形態: いずれもHugging Faceで公開中。Apple・AMD・Qualcomm・NVIDIA向けにllama.cppへ初日対応し、NVFP4に対応する。Hugging Face Spaceでカメラ入力にループ実行する10種のデモ、NVIDIAとの連携でJetson実機をhardware-in-the-loopに据えたIsaac Simでのナビゲーション実演も用意されている。
- ライセンスの注意: 公式ブログは「制限なくダウンロード・微調整・デプロイできるオープンウェイト」と説明しているが、Hugging Faceのモデルメタデータ上のライセンス表記は両モデルとも other(独自ライセンス) である。商用利用などの前にリポジトリ同梱のLICENSEの確認が必要だ。
性能 — Decision Indexと7種テキストベンチマーク(いずれも公称値)
- Decision Index v0.2.1(公開split): d1-3Bは48.57で、10B未満のモデルで首位、12倍の規模の決定モデルDecider 35B-A3Bに並ぶとしている。d1-omni-600Mは同指数で15.95。視覚の非公開splitは今回報告対象外で、音声の決定ベンチマークは分野として未整備であり今後の整備に期待するとしている。
- 7種テキストベンチマーク: 読解・有害性検出・意図分類・医療QA・多言語理解をカバーするSQuAD 2.0/Civil Comments/MASSIVE intent/PubMedQA/BoolQ/XNLI/PAWS-Xの平均は、d1-3Bが82.9で表内首位(Decider 4B 81.1、Decider 2B 77.1)。d1-omni-600Mは78.4で、4分の1のパラメータでDecider 2Bを上回り、Civil Comments(95.8)とPAWS-X(79.5)は表内最高だとしている。
- 測定の前提: いずれも同社が選定したベンチマークでの自社測定であり、独立評価ではない。実タスクでの品質はプロンプトや設定により変動するため、導入時は自身のワークロードでの再計測が推奨される。
速度 — 単一質問は全測定デバイスで50ms以内と報告
- 測定方法: 決定モデルは出力トークンを生成しないため、入力から出力までのend-to-endレイテンシで評価。1回1リクエストで、単一質問・同一状態での3質問・3.4Kトークン状態・384px画像などの条件で計測した(d1-omni-600Mは開発中のため速度報告の対象外)。
- エッジ: d1-3Bの単一質問はApple M5 Proで30ms、Jetson AGX Thorで16ms、Jetson AGX Orin 64GBで26ms、Jetson Orin Nanoで50ms。3質問でも1質問の約1.3倍程度に収まるとしている。
- GPU: NVIDIA RTX 4090で8ms、AMD MI325Xで9ms。384px画像の処理は両GPUで18ms以内、64状態パック時はRTX 4090で475/s、MI325Xで1,106/sとしている。NVIDIAスタック全体(データセンターのDGXからRTXワークステーション、エッジのJetsonまで)での動作をうたう。