IMAGE: AI生成ビジュアル
PRODUCTS / PRODUCTS
Mistral、Agentic Searchを公開 — 5つのツールで複雑な文書を横断的に検証、FinanceBenchで3倍の正確性
Mistral AIは2026年8月20日、複雑な企業文書をAIが多段階に探索・検証するための検索レイヤー「Agentic Search」を公開した。既存の検索インデックスの上にsearch/open/navigate/read/grepの5ツールを提供し、StudioとVibeのLibrariesおよびSearch Toolkit経由で利用できる。FinanceBenchでは26.7%から86%へ約3倍の正確性向上、p90レイテンシは最大39.6%削減、トークン消費は最大3分の1削減したとしている。
Mistral AIは2026年8月20日、AIシステムが複雑で長大な文書の中から情報を正確に探し出し検証するための検索レイヤーAgentic Searchを公開した。単発のRAGでチャンクを返すのではなく、モデルが検索→ファイルを開く→特定位置へ移動→読む→grepを反復し、インデックスを能動的なツールとして使う多段階ループを提供する。Mistral Search Toolkitと、StudioおよびVibeに組み込まれたLibraries経由で提供され、既存の検索インデックスの上に構築できる。
 出典: Introducing Agentic Search | Mistral
何が提供されるか — 既存インデックスの上に5ツール
- 提供形態: Mistral Search ToolkitとLibraries(Studio / Vibeに組み込み)。既存の検索インデックスをそのまま活用する
- 5つのツール:
search(検索)、open(ファイルを開く)、navigate(文書内の位置へ移動)、read(該当箇所を読む)、grep(パターン検索)。長大・高密度な文書や複数ソースにまたがる探索に対応する - 機密データへの配慮: ポータブルでオープンなツール群により、クラウド/オンプレミスを問わず分離境界(isolation boundaries)を越えずに企業データの価値を引き出せるとしている
- 想定用途: 金融提出書類、契約書、技術文書のような表・数値が多くページ数が多い文書で、単一チャンクに答えが収まらないケース
従来のインデックス検索が有効なのは「短く整った文書で、答えが最初の検索結果に含まれる可能性が高い」「大量のキーワード/セマンティック検索で十分」といったケースだとMistralは整理する。Agentic Searchは、初回検索の結果を超えて原典を掘り下げて検証する必要がある質問で差が出ると位置づけている。
ベンチマーク — FinanceBenchとOfficeQA Proで検証
Mistralは、デフォルトのチャンク分割・ランキング・チューニングなしの標準構成(out-of-the-box)で2つの業界標準ベンチマークを計測した。結果は下限(floors)であり、ユースケース固有のチューニングでさらに改善し得るとしている。検証にはMistral Medium 3.5(MM 3.5)とZ.ai GLM-5.2の2モデルを用い、モデル非依存性も確認した。
 出典: Introducing Agentic Search | Mistral
 出典: Introducing Agentic Search | Mistral
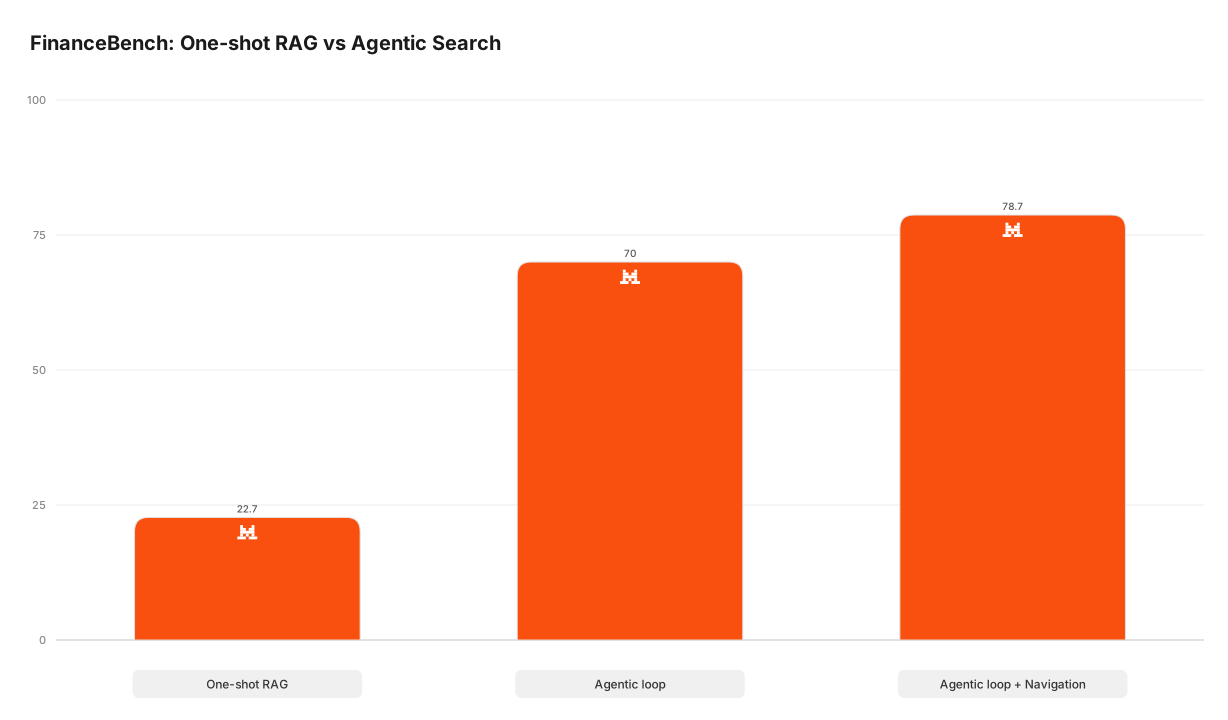
FinanceBench: SEC提出書類368件・150問
- 対象は368件のSEC提出書類(10-K / 10-Q / 8-K)、平均約147ページ、合計約53,900ページの長大で表が多い金融文書。Islam et al., 2023によるベンチマークで、回答は人手ラベルで較正したLLMジャッジが採点する
- 正確性: Agentic Searchにより26.7% → 86% へ約3倍に向上(全体)。表を含む複数文書にまたがる質問では顕著としている
- 多段階ループの効果:
- One-shot RAGからsearchのみのAgenticループに変えるだけで**+47.3ポイント(MM 3.5)、+52.6ポイント(GLM-5.2)**向上。いずれも約3倍の改善で、反復検索により弱い初回結果から回復しクエリを洗練できる効果
- さらに
open / navigate / read / grepを加えると**+8.7ポイント(MM 3.5)、+6.7ポイント(GLM-5.2)**上乗せ。広く再検索するより、狙いを定めた掘り下げ(targeted drill-in)が有効だとしている
- モデル非依存: 小型のMM 3.5と大型のGLM-5.2で同じ改善パターンが観測され、新モデルでも品質向上が期待できるとしている
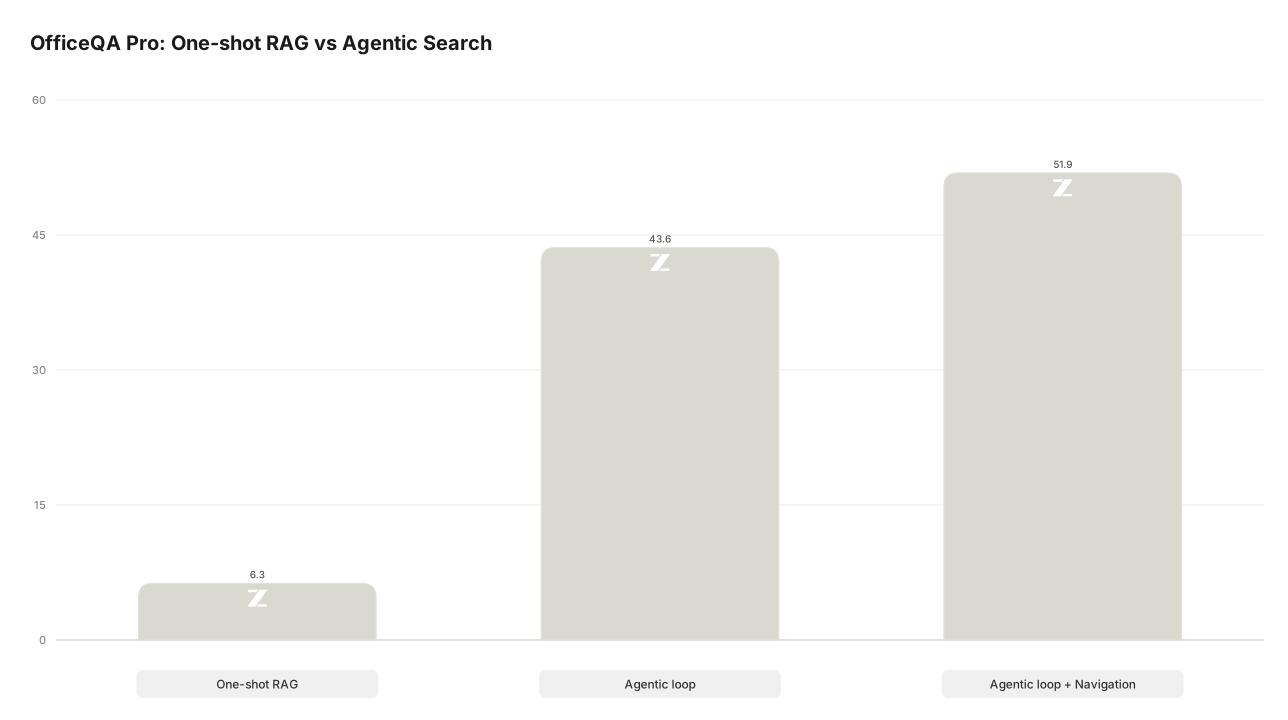
OfficeQA Pro: 表が多く複数文書にまたがる質問
- 正確性: 6.3% → 51.9% へ+45.6ポイントの向上を計測。複雑な表を含む業務文書での改善を強調している
レイテンシとトークン効率
- p90レイテンシ: 狙いを定めたナビゲーションにより最大39.6%削減
- トークン消費: 繰り返しの広域検索が減ることで最大約3分の1(33%)削減
- 品質向上と同時に、不要なトークン・ターン・待ち時間を削減する点が特徴としている。いずれもMistralの社内計測による公称値であり、独立した第三者評価ではない点に留意が必要
使い方と位置づけ
- 入手方法: Mistral Search ToolkitのドキュメントとLibraries経由で利用可能。Studio / Vibeのワークフローに組み込んで使える
- いつ使うか: 短い文書や答えの所在が明確な単純な質問ではOne-shot RAGで十分だが、答えが複数箇所に分散・表の中に埋もれている・複数ソースの突き合わせが必要な場合にAgentic Searchが有効とMistralは説明する
- インデックスは依然として基盤: 良く設定されたインデックスがどちらのケースでも出発点であり、Agentic Searchはその上に「エージェント的な探索」を追加するレイヤーという位置づけ
- 注意点: 今回の数値はMistralが選定した2ベンチマーク・2モデルでの社内評価であり、実務データでの効果は文書構造、インデックス設定、モデル、プロンプトにより変動する。導入時は自社データでの再計測が推奨される
出典: