

IMAGE: AI生成ビジュアル
PRODUCTS / DEV TOOLS
Sentence Transformers v6.0、4番目のモデル型「MultiVectorEncoder」— ColBERT式のレイトインタラクション検索をネイティブ対応
Hugging Faceは2026年8月18日、埋め込み・再ランクモデル用ライブラリ「Sentence Transformers」のv6.0を公開した。トークンごとに1ベクトルを保持しMaxSim演算でスコアリングするレイトインタラクション(ColBERT式)モデルを扱う新モデル型「MultiVectorEncoder」を追加。PyLate・Stanford-NLP ColBERT・ColPali系のチェックポイントを直接読み込み可能になる。
Hugging Faceは2026年8月18日、埋め込み・再ランクモデル用ライブラリ「Sentence Transformers」のv6.0を公開した。従来のdense(単一ベクター)・sparse・rerankerに加え、レイトインタラクション(ColBERT式)モデルを扱う新モデル型「MultiVectorEncoder」が第4のモデル型として追加された。検索・RAG(検索拡張生成)・ビジュアルドキュメント検索の用途で、トークン粒度のマッチング情報を活かす実装をライブラリ標準で扱えるようになる。
MultiVectorEncoderとは何か
通常の埋め込みモデルは文全体を1つのベクトルに圧縮する。これに対しマルチベクターモデルは、トークンごとに1ベクトルを保持し、クエリと文書のスコアリングを「MaxSim」演算で行う。MaxSimはクエリの各トークンについて文書側トークンとの最大類似度を取り、それらを合計する方式だ。
- 単一ベクターが平均化で失うトークン単位の対応情報を保持するため、通常は検索精度が向上する
- その代償としてインデックスが大きくなる。4,874 passageをLateOnでエンコードすると60万8,414個のトークンベクトル(passageあたり平均124.8個)になり、MiniLMインデックスの約42倍のストレージ(passageあたり約62 KiB)となる
- PLAIDなどの圧縮インデックスでは、centroid IDと量子化残差を持つ方式により、同じベクトル群が約92 MBに収まる
- テキストをOCRなしでページ画像に直接マッチングするビジュアルドキュメント検索(ColPali系)でも、この方式が事実上の標準となっている
既存チェックポイントとの互換性
MultiVectorEncoderは、各プロジェクトが公開してきたチェックポイント形式を自動判別して読み込む。
- PyLate(LightOn)のチェックポイントは追加設定なしで読み込める(例:
lightonai/LateOn、lightonai/mLateOn) - Stanford-NLPのColBERTチェックポイントも直接読み込み可能(例:
colbert-ir/colbertv2.0) mixedbread-ai/mxbai-edge-colbert-v0-17m、LiquidAI/LFM2.5-ColBERT-350Mなどの対応モデルも列挙されている- ColPali系(
colpali-engine形式)は独自形式のため、リポジトリへ小幅な設定追加が必要で、その作業のほとんどはマージ待ちの状態
マルチベクターモデルはクエリと文書で異なるプレフィックス・長さ上限・スコアリング用マスクを使う非対称な構造のため、encode_query()とencode_document()は使い分ける設計になっている。
性能と評価
レイトインタラクションの利点は、同条件での比較で示される。LightOnが同一のModernBERTバックボーン・同一パラメータ数(149M)で、トークンごとにベクトルを保持するか、文書ごとに1ベクトルへ集約するかだけを変えて訓練した「LateOn」と「DenseOn」の比較が、ブログ内で報告されている。
- 13データセットからなるNanoBEIRで、LateOnは9件と平均値でDenseOnに勝利。差はNDCGで概ね1ポイント程度
- 負けた4件(ArguAna、FiQA2018、SCIDOCS、SciFact)は「同モデルサイズで検索品質が向上する一方、インデックスが大きくなる」というトレードオフの典型例
- 同じ組み合わせはBEIR全体(15データセット)でも57.22対56.20で、傾向が小規模ベンチマーク特有のものではないことも示された
- 新設の
MultiVectorNanoBEIREvaluatorを使えば、13件のNanoBEIRをMaxSimスコアリングで簡易評価できる
バックエンドごとの推論速度比較(GPU・CPUベンチマーク)も掲載されており、CPUでは対応アーキテクチャの場合OpenVINOが有利で、int8量子化でさらに高速化できる一方、精度コストは約0.4%とされる。
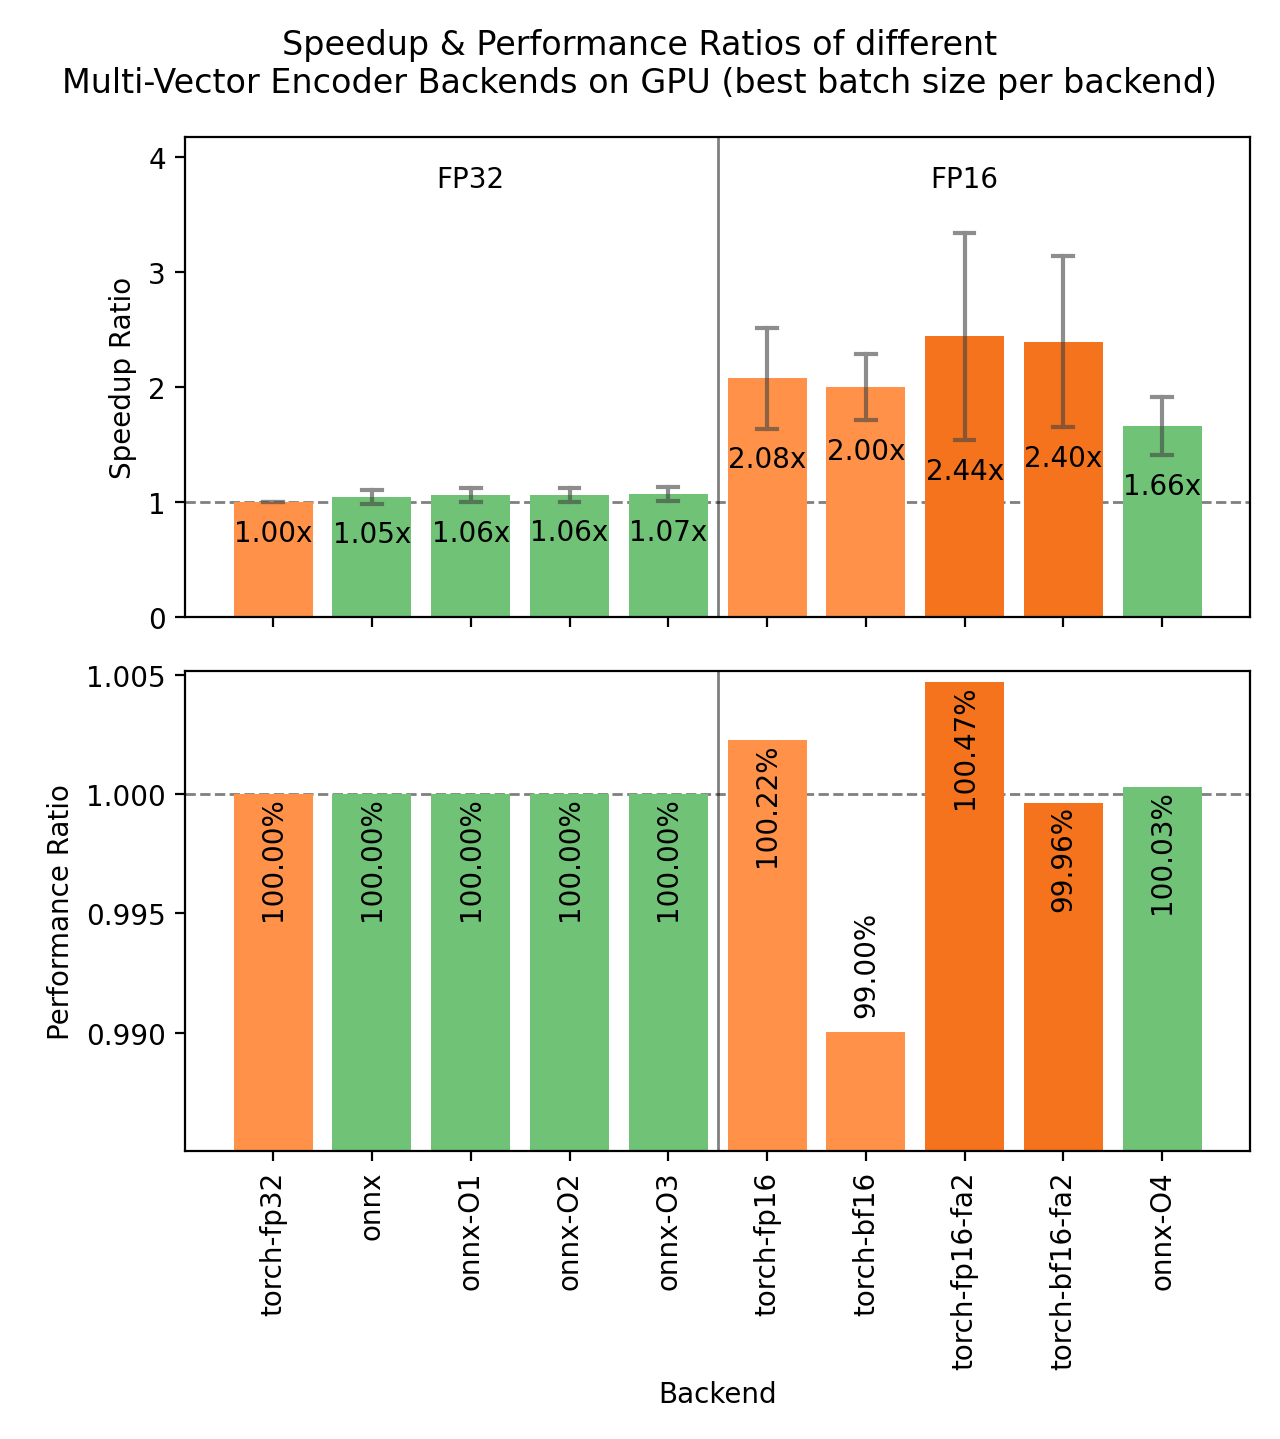 出典: Hugging Face公式ブログ「Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers」
Hugging Faceは今回のリリースについて、単一ベクターモデルだけでは難しかった「トークン粒度の検索品質と、大きくなるインデックス」の両面を、ひとつのライブラリで扱えるようにする狙いだと説明している。RAGやセマンティック検索を構築する開発者にとって、ColBERT系モデルの導入ハードルが下がる変更といえる。

