

IMAGE: AI生成ビジュアル
MODELS / AllenAI
Ai2が科学レポート生成モデル「AstaBrief 8B」をオープンウェイト公開 — 引用付きレポートを約3.5倍高速に
アレンAI研究所(Ai2)は2026年10月2日、科学文献の調査レポートを引用付きで生成する80億パラメータモデル「AstaBrief 8B」をオープンウェイトとして公開した。Qwen3-8Bを起点にSFTとDPOで学習し、Astaのレポート生成パイプライン全体でThinkingモードの約3.5倍の速度を記録。モデル、学習データ、コレクションをHugging Faceで公開している。
アレンAI研究所(Ai2)は2026年10月2日、科学文献のリサーチレポートを引用付きで生成するための言語モデル「AstaBrief 8B」をオープンウェイトとして公開した。同研究所の科学支援エージェント基盤「Asta」のレポート生成機能ではFastモードとして提供され、従来のClaude基盤のThinkingモードと比べてパイプライン全体で約3.5倍速い。モデル本体に加え、学習データやレポート生成のサンプルワークフローもHugging Face上で公開されている。以下は同研究所の発表記事の整理である。
公開内容 — モデル・データ・ワークフロー
- モデル:
allenai/AstaBrief_8B(80億パラメータ、起点はQwen3-8B)。テキスト生成モデルとしてHugging Faceで公開。 - データと学習過程: 学習に使ったデータセットや中間チェックポイントを含む「AstaBrief Collection」(5アイテム)も公開。検証・再現・派生研究を想定している。
- サンプルワークフロー: 研究者自身のPDFからレポートを作れる実装例を公開しており、自前インフラでのローカルなレポート生成の出発点にできる。機密性の高い未発表研究を扱う機関が自前のハードウェアやファイアウォール内で運用できる点を利点として挙げている。
- Astaでの位置づけ: Astaの「Generate a report」機能では、Claude基盤のThinkingモードと並ぶFastモードとして提供される。
学習レシピ — 実クエリ由来のSFTとDPO、引用密度フィルタ
- SFT: Astaに寄せられた実研究者のクエリを品質・関連性・プライバシーの観点で選別し、約9万件の研究志向クエリを確保。ScholarQAパイプラインで全文レポートの教師出力を生成し、品質選別後に約4.7万件をSFTに使用。教師出力の生成にはClaude 3.5 Sonnet、Claude 3.7 Sonnet、o3、o4-mini、GPT-4.1を混用した。
- DPO: SFTと重ならないクエリ群で、ScholarQA由来レポートと他モデル(o3、o4-mini、DeepSeek-V3、DeepSeek-R1のいずれか)による競合レポートをペア化。GPT-4.1とDeepSeek-R1の2つのジャッジが一致したものだけを採用し、最終的に約6千件。ジャッジと人間の好みの一致率は95%だったとしている。
- 引用フィルタ: 出力トークン比率、引用関連性、引用密度、引用多様性の4種を検証し、引用密度の低い合成レポートの除去が最も効いた。精緻な組み合わせよりも「主張に一貫して引用が付いているか」という単純な信号が有用だったと報告している。
- 高速化の設計: 高コストなスニペット要約・クラスタリング段階と節ごとの逐次執筆を省き、クエリと検索スニペットから最終レポートを一括生成するよう学習させた。性能を犠牲にせず高速化できたとしている。
- 手法選択: RL系(DR Tuluで有効性が示された方向)ではなく、安価で運用・デバッグしやすいSFT+DPOの構成を採用した。
評価 — SQABench-CS2とDeepScholarBench、速度と利用状況
- 指標: メイン評価は200問の計算機科学系研究質問セット「SQABench-CS2」で、ルーブリックスコア(内容網羅)、回答適合度、引用適合度、引用再現率の4指標を追跡。副次評価として63問の「DeepScholarBench」と、LLM判定および小規模な人間評価によるペアワイズ比較を実施した。
- 結果の位置づけ: 開発中の評価では、回答と引用の品質の複数指標でClaude基盤パイプラインやDR Tuluと競合する水準だった。14問・研究者3名の人間評価では、総合選好でDR-Tuluが上回った一方、引用精度では3名中2名がAstaBriefを他より好んだとしている。
- 速度: Astaパイプライン全体で、Fastモードは1レポート平均51.1秒、Thinkingモードは178.5秒で、約3.5倍速い。
- 初期利用: Fastモードを試した374ユーザーのうち29.1%が2日以上利用し、1人平均3.67スレッドを生成。23%はThinkingモードに戻らず継続、18%は目的に応じて使い分け(約40%のスレッドでFastモードを使用)。肯定的フィードバック率はFastモード84.2%、Thinkingモード85.2%で同程度だった。
- 注意点: 筆者らによれば、学習と評価の多くは2025年に完了しており、教師データ生成や比較対象のプロプライエタリモデルは当時のフロンティアを反映する。今日のフロンティアに対する主張ではなく、当時検証した学習・システム設計の有効性を示すものとして読むべきだとしている。
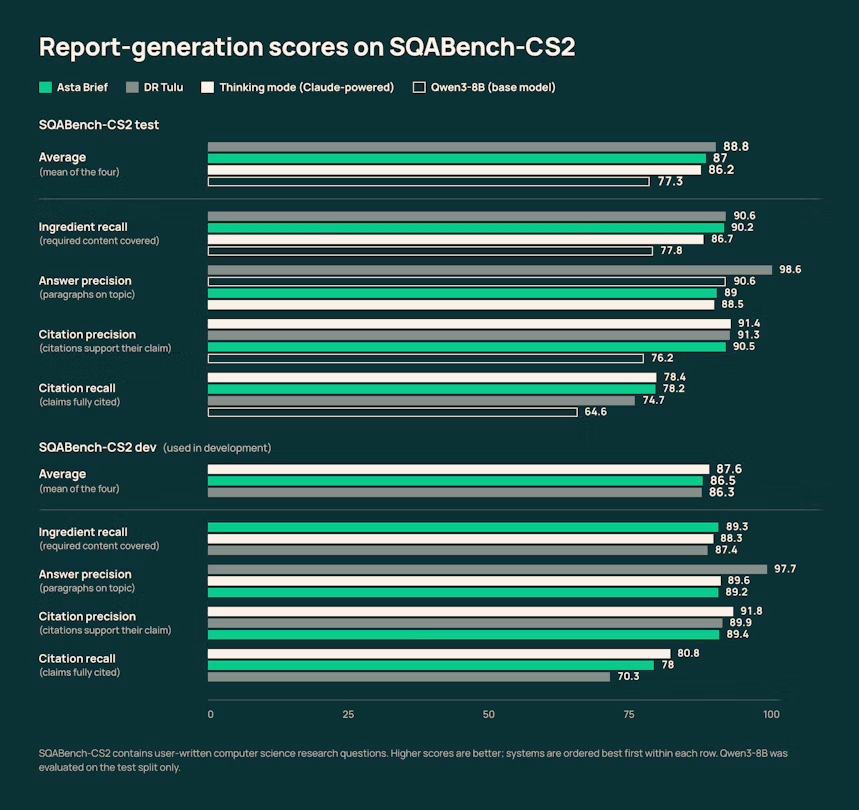
出典: Open-sourcing AstaBrief, the fast report-generation model in Asta(評価結果の表。各行は上から良い順、すべての指標で高いほど良い。Qwen3-8BはSQABench-CS2テストのみで評価。DeepScholarBenchの指標はSQABench-CS2と比較不可)
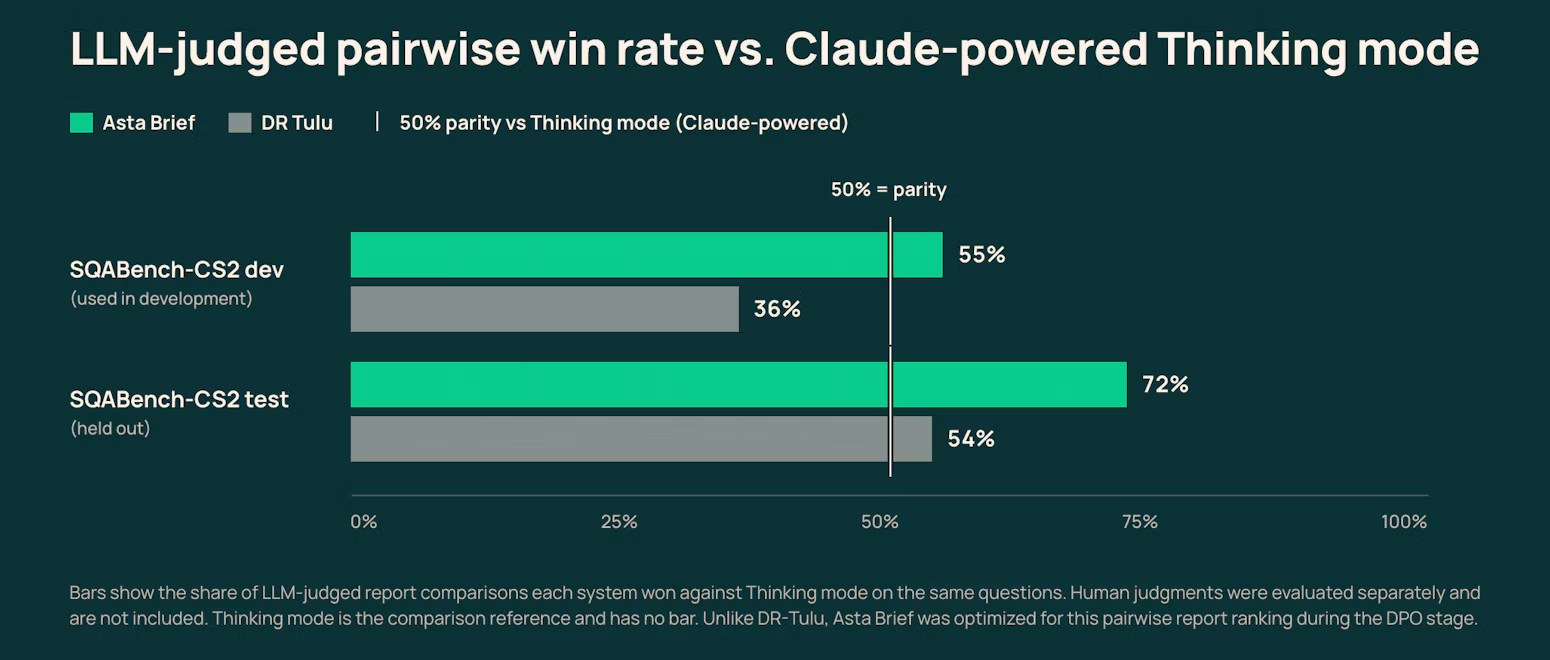
出典: Open-sourcing AstaBrief, the fast report-generation model in Asta(同じ質問に対するThinkingモードとの比較で各システムが勝った割合。Thinkingモードは比較基準のためバーなし。人間判定は別途評価でグラフに含まない)
