

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
Reflectionが501B・23BアクティブのMoE「Beam」を発表 — 米オープンウェイトの新鋒、重みは10月中にApache 2.0で公開へ
Reflectionが2026年10月5日、初のオープンウェイトモデルBeamを発表した。総501B・トークンあたり23Bアクティブの疎なMoEで、コーディングとエージェント性能に特化する。23.8兆トークンの事前学習とGB300約1万基・4週間の大規模RLが特徴で、SWE-Bench Verified 80.9%などを公称する(ベンダー公称値)。重み・技術レポート・モデルカードは10月中の公開予定で、現時点では選抜ユーザーへの早期提供と待機登録の段階だ。
Reflectionは2026年10月5日(現地時間)、同社初のオープンウェイトモデル Beam を発表した。総501Bパラメーター・トークンあたり23Bアクティブの疎なMixture-of-Experts(MoE)で、コーディング・推論・エージェントワークロードに特化する。23.8兆トークンの事前学習と、NVIDIA GB300約1.05万基を4週間使う大規模強化学習(RL)を両輪とし、「西側オープンウェイトの最前線を前進させる」位置づけを掲げる。重み・技術レポート・モデルカード・開発者向け成果物は10月中の公開予定で、現時点では選抜ユーザーへの早期提供と待機登録の段階だ。本稿は同社の公式ブログで確認できる範囲に限定して整理する。
モデルの概要 — 仕様と提供形態
- アーキテクチャ: 総501Bパラメーター、トークンあたり23Bアクティブの疎なMoE。コーディングとエージェント性能に特に注力して訓練したとしている
- 事前学習: Webと独占ライセンスのデータセットから厳選した多様で高品質な 23.8兆トークン で学習し、同規模の公開ベースモデルと同等以上だとしている(ベンダー主張)
- 位置づけ: 大規模なGLM 5.2級と競合し、コーディングとエージェントではQwen 3.8-Maxに迫るとする一方、Kimi K3級が生の能力で先行する領域では推論時の効率を強みと位置づけている(いずれもベンダー主張)
- 提供形態(現時点): 重みは未公開。最終のレッドチーミングと評価の途上としており、この早期版を選抜ユーザーに提供し、待機登録を受け付けている
- 公開予定: 10月中に重みを Apache 2.0ライセンス で公開し、技術レポート・モデルカード・文書、実行・評価・微調整のためのフルスタックを添えるとしている。配布パートナーや主要なOSSライブラリ・ハーネスとの統合も予告している
能力の公称値 — コーディングとエージェント系ベンチマーク
以下はいずれも同社ブログに記載のベンダー公称値であり、独立評価ではない。他社モデルの値はArtificial AnalysisとDataCurveのデータを引用したと同社が説明している。
- エージェント系コーディング: SWE-Bench Verified 80.9%、SWE-Bench Pro v2-Hard 77.2%、Terminal-Bench v2.1 80.1%、SWE-Bench Multilingual 78.0%、SWE-Bench Pro v1 65.5%、DeepSWE v1.1 44.4%、SWE Atlas Codebase QnA 34.6%
- 推論・科学: AIME 2026 97.8%、GPQA Diamond 90.5%、HLE(ツールなし) 36.2%、SciCode 49.7%、CriPT AA 16.3%
- ツール呼び出し・探索: MCP Atlas 78.7%、BrowseComp(コンテキスト管理あり) 77.4%、DeepSearchQA(同) 80.1%、AutomationBench public 37.0%、tau3 banking 38.0%
- 汎用: AA-LCR 79.3%、LongBench v2 65.5%、IFBench 79.7%、AA Omniscience(index、公開分割のみ・自社測定) 13.0
出典: Introducing Beam: Reflection’s 501B open-weight model — Reflection
推論効率と大規模RL — 計算規模の主張
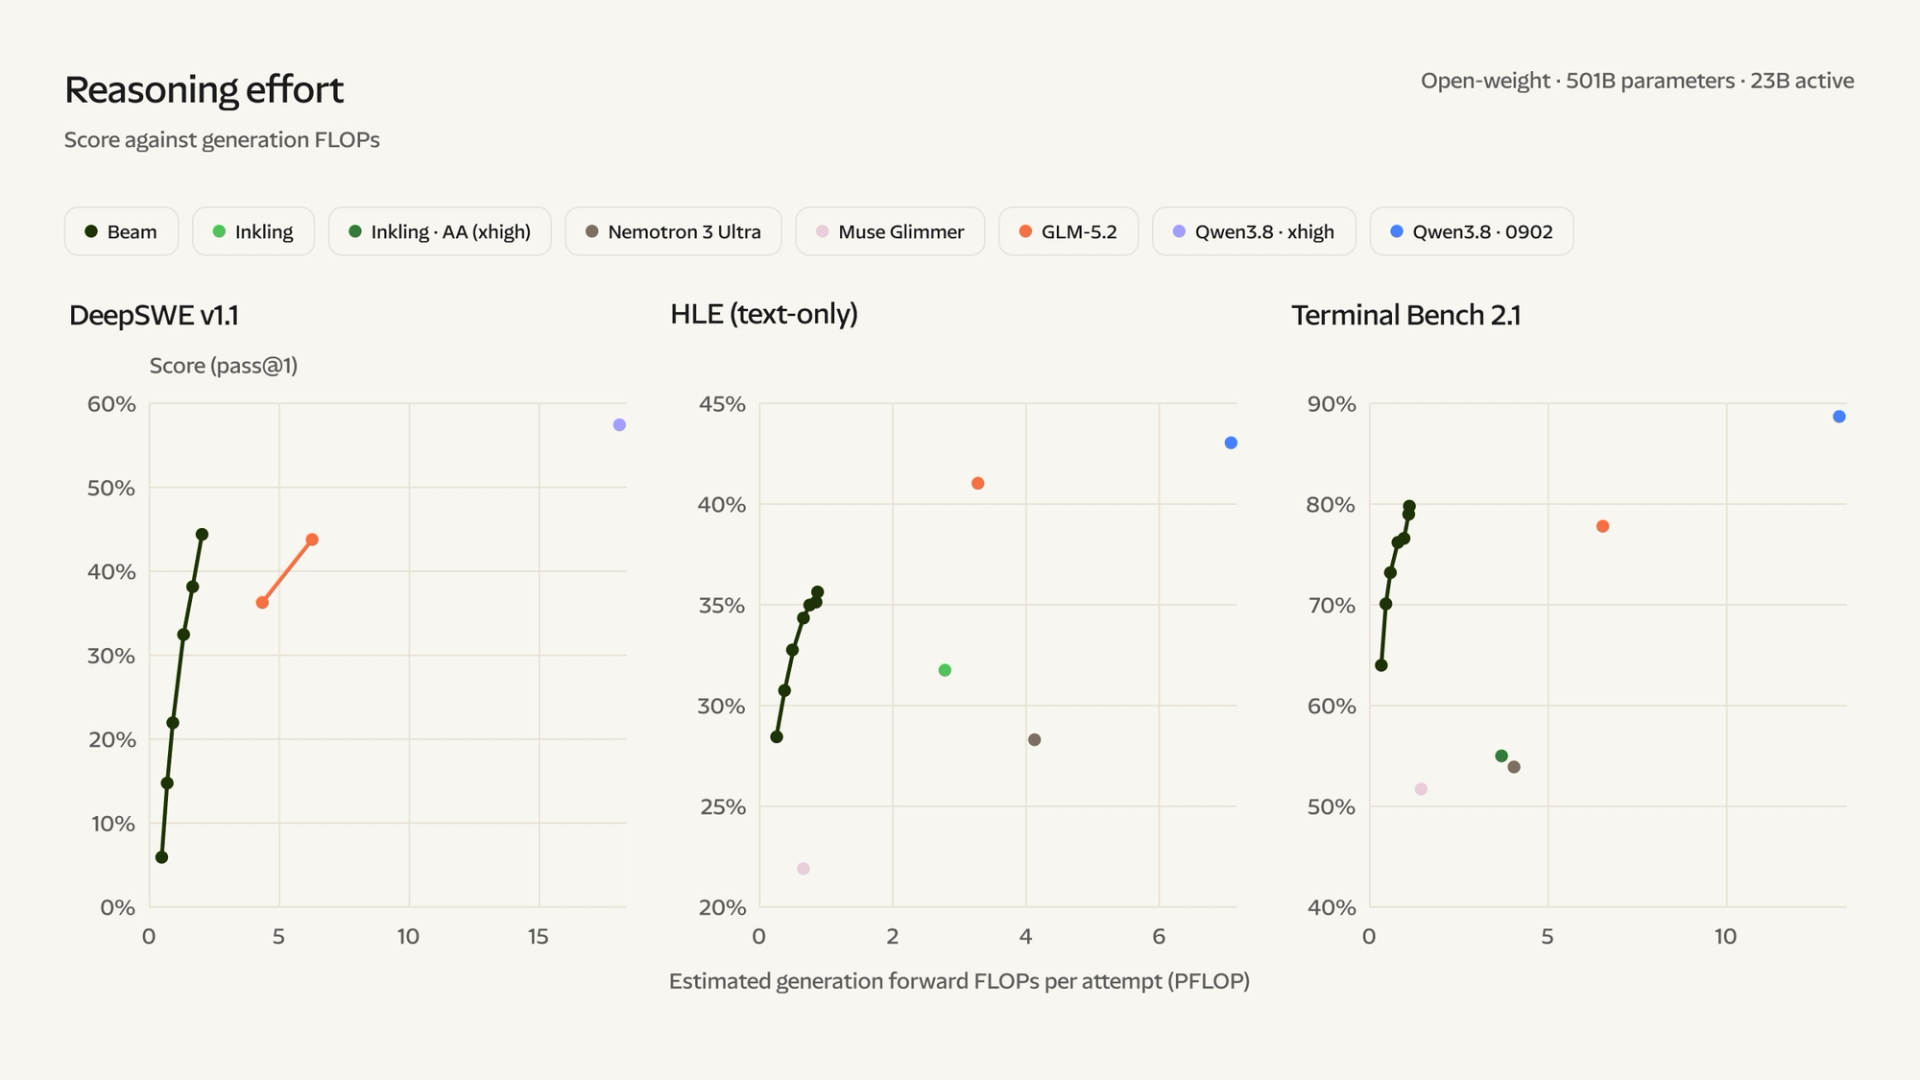
- 効率の主張: 高度な推論ベンチマークでGLM 5.2級と同等のスコアを 3〜4倍少ない推論計算量 で達成し、Qwen 3.8-Max級の2兆超パラメーター帯との差はさらに大きいとしている(同社の試算で、生成フォワードパスの近似比較であり実測の提供コストではないと注記している)
- RLの規模: 高計算RLを中心的なスケール軸とし、最大コンテキスト長256Kトークンで 1億超のロールアウト を生成。学習と採点で約13億のサンドボックスを使い、100万件の高品質なコーディング・エージェント・STEM環境を用意したとしている
- 基盤: NVIDIA GB300約1.05万基で4週間 のRL実行で、オープンの研究機関としては過去最大級のRL実行のひとつだとしている(ベンダー主張)。終盤のグッドプット(保持された学習ステップの実効割合)は92.3%に達したとしている
- 評価の伸び: 評価スイート全体でRL計算量の増加とともに能力が向上し続け、頭打ちの兆しはないとしている(ベンダー報告)
安全性と注意点 — 未公開のプレビュー段階
- 安全性の手法: 事前学習チェックポイントから、能力側の大規模RL教師と安全・アライメント専用教師の2系統を多教師オンポリシー蒸留(MOPD)で統合したとしている。原則を「破ってはならない規則」「満たすべき品質」「既定の対話スタイル」の3層に整理している
- 外部公開の方針: モデルの技術レポートとともに、内部で使った安全評価をオープンソース化し、エコシステムが検証・貢献できる共通の検査可能な標準を作るとしている
- 評価の性質: 本稿の数値はすべて同社ブログの公称値で、重み・技術レポートの公開前であり、第三者による再現検証は現時点でできない。比較表の他社値は同社が外部データを引用したものだ
- 未確定事項: 重みの公開は「10月中」の予告であり、ライセンス条文・モデルカード・配布条件の詳細は公開時の確認が必要だ
