NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / RESEARCH
NVIDIAがNemotronの競技特化レシピを公開 — IOI・IMOで金メダル水準、重みとデータもHugging Faceに
NVIDIAが2026年10月7日、Nemotronファミリーを国際情報オリンピック(IOI)と国際数学オリンピック(IMO)向けに特化させ、金メダル水準の結果を得た手法をHugging Faceブログで公開した。22,000問の競技プログラミング問題と41万件超の証明データによるSFT・RL、生成・評価・改善の推論ループの組み合わせが核で、モデル・コレクション・再現レシピをHugging Face上で公開している。
NVIDIAは2026年10月7日(現地時間)、Nemotronモデルファミリーを国際情報オリンピック(IOI)と国際数学オリンピック(IMO)向けに特化させ、いずれも金メダル水準の結果を得たとする取り組みをHugging Faceブログで公開した。新しい基盤モデルを作るのではなく、既存のNemotronを領域特化させる「再利用可能なレシピ」が主題で、モデル・データ・推論レシピをHugging Face上で公開している。本稿は同ブログで確認できる範囲に限定して整理する。
出典: One Model Family, Two Gold-Level Results: Fine-Tuning Nemotron for IOI and IMO — Hugging Face
4要素の特化レシピ — 基盤モデル+データ+SFT/RL+推論ループ
- レシピの4要素(ブログの記載通り): (1) 強力なNemotron基盤モデルから始める、(2) 領域固有の問題と高品質な推論トレースを整備する、(3) SFTなどの標準的な事後学習を適用し、有用な場合はRLを加える、(4) 特化モデルと「候補を生成・評価・改善する」推論ループを組み合わせる
- 主張の核心: 金メダルはファインチューニング単独でも、力任せのサンプリング単独でもなく、「モデル・データ・推論ループの共同設計」から生まれたとしている
- 評価条件の注記: IOIの結果は人間参加者と同じ時間・インターネットアクセス・提出制約の下で本番と並行して実施したライブ実行によるものだが、非公式・監視なしのベンチマークであり、公式ランキングには含まれない。IMOの提出証明は公式のIMO採点者が採点した
- 再現性: 学習と推論の実行規模は大きいものの手法自体は既知のもので再現可能だとし、課題ごとに基盤モデルを新規構築する必要はなかったと説明している
IOI向け特化 — Nanoの130点→468点、Ultra-CCは535.4点
- 学習データと専門家モデル: 22,000問の競技プログラミング問題を整備し、合成推論トレースを生成して2つの専門家モデルを学習した。Nemotron-3-Nano-CC(総300億パラメーター・有効30億)はSFTとRL、Nemotron-3-Ultra-CC(総5,500億・有効550億)はSFTを適用した
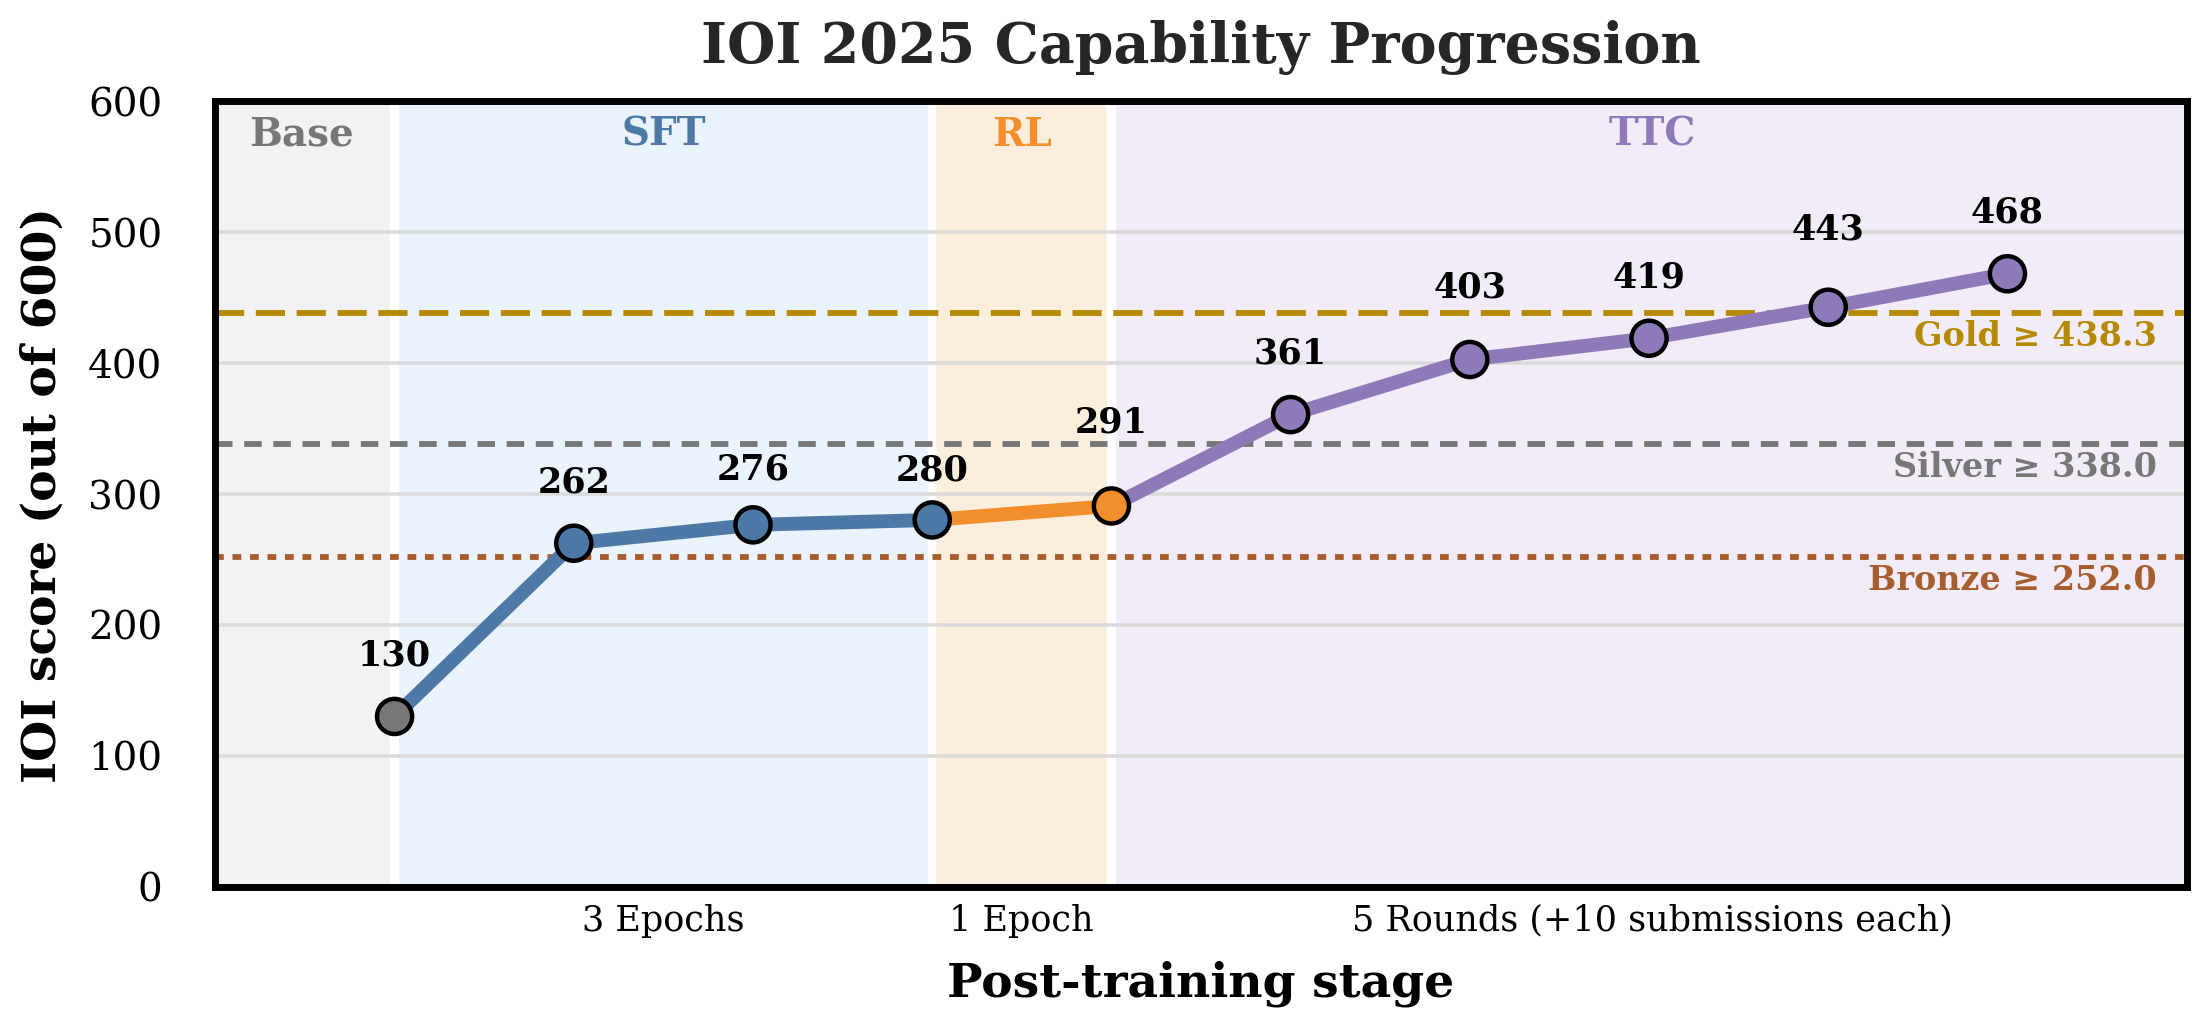
- IOI 2025での進展: Nanoは事後学習前の130点からSFT後に280点、RL後に291点へ改善。反復的な生成・評価・改善戦略「GenCorrect」により468点に到達し、金メダル閾値438.3点を超過した。Ultra-CCは同じテスト時戦略で502点に達した
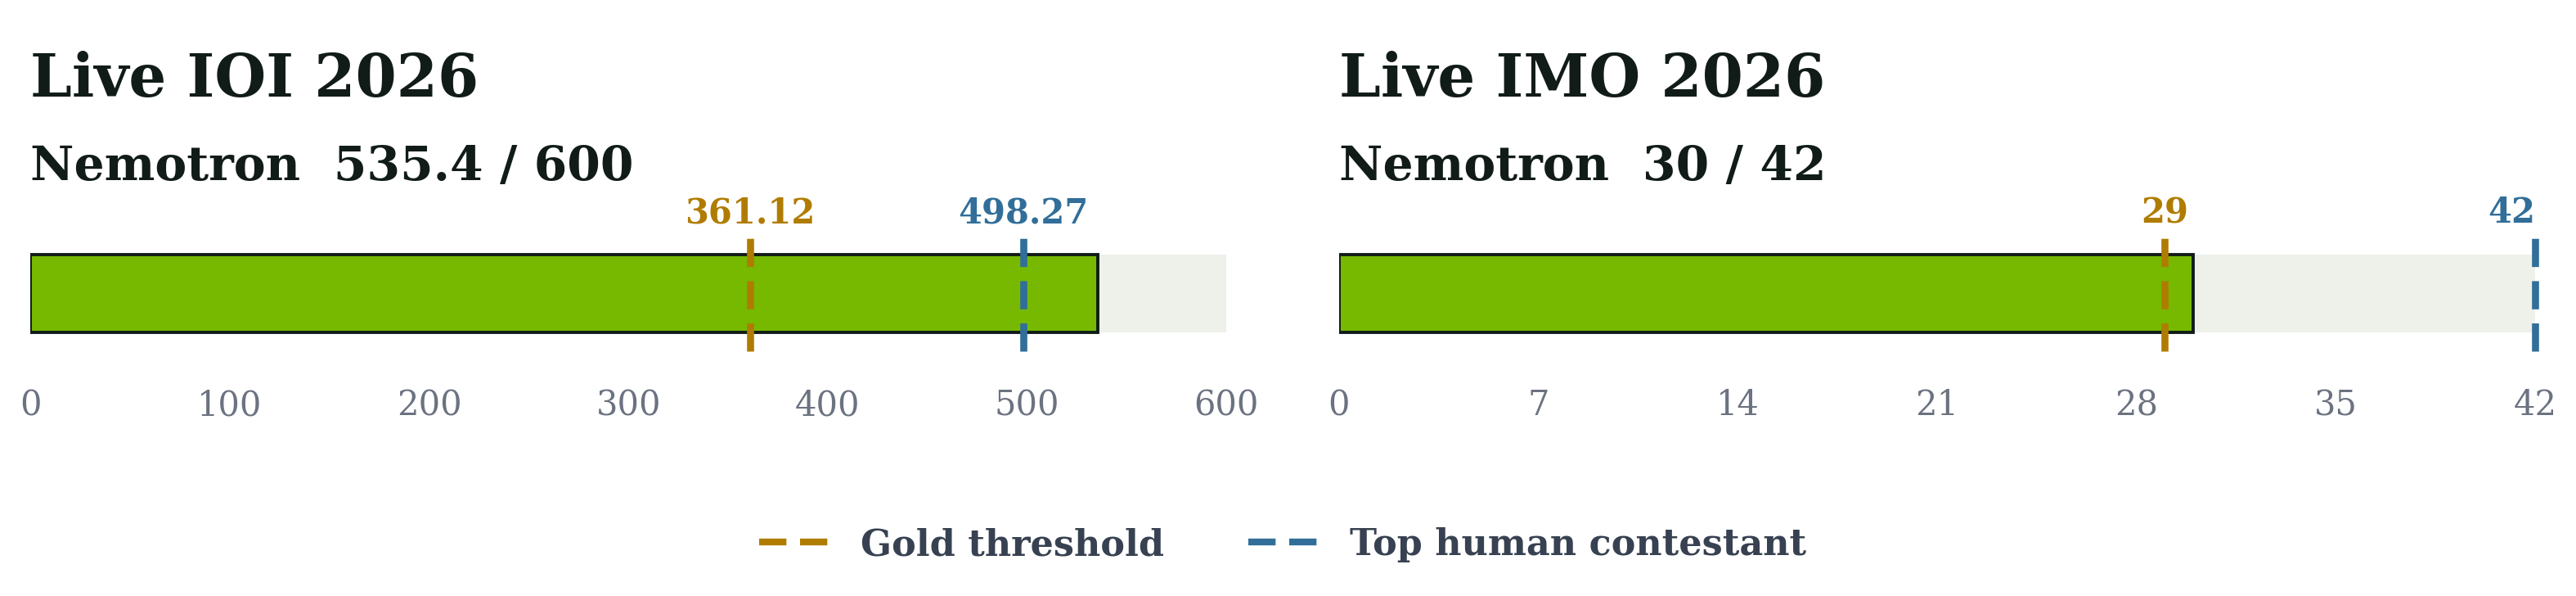
- 規模による違い: Nanoの改善の大半はSFTによるものでRLは小さいが一貫した上積みだった。一方、より強力なUltraでは1エポックのSFTだけで、完全な事後学習を受けたNanoをIOI・ICPC・LiveCodeBench Proで上回った。この知見を反映した競技用Ultra-CCシステムがIOI 2026で600点満点中 535.4点 を記録した
- 数値の扱い: 上記の点数・閾値はいずれもブログ著者(NVIDIA)による報告値であり、独立した第三者の検証結果ではない
出典: One Model Family, Two Gold-Level Results: Fine-Tuning Nemotron for IOI and IMO — Hugging Face
IMO向け特化 — 42点満点中30点、自然言語のみで証明
- 出発点と学習: Nemotron 3 Ultraを起点に、SFT専門家とRL専門家を1つずつ学習させた
- SFTデータ: 15,818問のユニークな証明問題にわたる414,890件の品質フィルタ済み事例。最終解答だけでなく証明生成・改善・検証・メタ検証を含み、議論の構築、欠陥の特定、批評への応答、証明の完全性判定を学習させたとしている
- RLデータ: モデルの能力フロンティア付近から選んだ9,597問の証明問題で学習させた
- 開発実験の結果: 両チェックポイントとも汎用モデルを上回り、SFTは初回探索ラウンドで最強、RLは単一チェックポイントとして最良の総合結果だった。強みが相補的なため、最終システムは両専門家と汎用モデルを併用した
- 本番の方式と結果: 各問題について候補証明を生成・採点・批評・改善し、別途高計算量の選定段階で最終提出物を決定した。形式証明器・外部ツール・インターネットアクセスなしの自然言語のみで動作し、42点満点中 30点、6問中4問で満点を獲得し、公式の金メダル閾値を上回ったとしている
- IOIとの対比: IOIではGenCorrectによる複数回のフィードバックが大きく効き、IMOでは単一チェックポイントからの多数サンプリングよりSFT・RL両専門家の併用が有効だった。いずれも「有能な専門家+探索・検証・改善する仕組み」の組み合わせが最良だったとまとめている
公開物 — 重み・コレクション・再現レシピ
- 競技コーディング用モデル: 550Bモデル(NVIDIA-Nemotron-Labs-3-Competitive-Coding-550B-A55B-NVFP4)がHugging Faceで公開されている
- IMO関連: Nemotron Labs IMO 2026コレクションがHugging Faceで公開され、テスト時スケーリングのレシピはGitHub(NVIDIA-NeMo/Skillsリポジトリ内のnemotron-imo-tts)に置かれている
- ライセンス・利用条件: ブログ本文の抽出範囲では各公開物のライセンス条項までは確認していない。利用時は各公開ページのライセンス表示を確認する必要がある
- 位置づけ: 同ブログはIOI・IMOを「単純な考え方(基盤モデルを世界級の領域専門家に特化させ、透明な推論ワークフローと組み合わせる)に対する異例に厳しい証拠」と結んでいる