

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / Models
NVIDIA、オープンな話者分離モデル「Nemotron 3 Diarization」を公開 — 100Mパラメータで最大8話者をリアルタイム分離
NVIDIAは2026年9月23日、誰がいつ話したかを識別する話者分離(diarization)のオープンモデル「Nemotron 3 Diarization」を公開した。100Mパラメータで最大8話者に対応し、VoiceArenaのDiarization-BenchでDER 14.72%の1位を獲得したとしている。オフラインとストリーミングの両対応で、NeMo経由で利用できる。
NVIDIAは2026年9月23日、会話中の「誰がいつ話したか」を識別する話者分離(speaker diarization)のオープンモデル「Nemotron 3 Diarization」を公開した。100Mパラメータの単一モデルで最大8話者に対応し、ライブ音声と録音済み音声の両方を処理できる。以下はNVIDIAがHugging Face公式ブログで公表した内容の整理であり、性能数値はすべて同社による測定値である。
VoiceArena Diarization-Benchで1位 — DER 14.72%
- 評価結果: VoiceArenaのDiarization-Bench初期結果で、12システム・計17構成の中で1位を獲得。139件の英語会話(計約22時間)で重なり発話を採点対象に含め、システム生成の音声区間検出・境界許容なしの条件で、話者分離誤り率(DER)14.72%を記録したとしている。次点の19.3%からは約24%の相対削減にあたる。
- DERの内訳: DERは聞き逃し(missed speech)、誤検出(false alarms)、話者の取り違え(speaker confusion)の3種の誤りを合計し、参照発話時間で割った指標。重なり合う参照話者は分母にそれぞれ加算される。
- 評価プロトコル: 901件の条件別録音からなる同社独自の評価では、多言語電話音声、会議、近接・遠方マイク、複数マイク収録、困難な音響環境をカバーし、すべての評価で重なり発話を採点。DIHARD III・AliMeeting・AMI・NOTSOFAR1は境界許容ゼロ、CALLHOME-Part2は0.25秒の許容で、NeMoの
e2e_diarize_speech.pyで計測したとしている。 - 注意点: 筆者側の注記として、VoiceArenaの結果は139件・約22時間の英語会話に基づく初期結果であり、日本語を含む他言語での同等性能を示すものではない。
前世代モデル比の改善と遅延設定 — ベンチマーク比較
- ベースライン: 比較対象はNVIDIAの前世代4話者ストリーミングモデル
diar_streaming_sortformer_4spk-v2.1。Nemotron 3 Diarizationは対応話者数を8人に拡大し、精度とスループットを改善したとしている。 - 1.04秒遅延での改善: 入力バッファ遅延1.04秒の条件で、8つの評価条件すべてでDERを削減。条件別の相対削減率はCALLHOME-Part2の9.0%からNOTSOFAR1 MHMの65.2%までで、8条件の非加重平均は41.0%としている(全録音を合算したプールDERではなく、条件別改善率の平均である点に留意)。
- 遅延の選択肢: 同一モデルで推奨入力バッファ遅延は30.4秒・1.04秒・0.64秒・0.32秒の4段階。短いバッファほど応答は速くなる一方、一般に精度とスループットは低下する。技術的には80msのバッファも可能だが、推奨下限は0.32秒としている。これらの値は推論前の音声バッファ量であり、計算・通信・ASR・アプリ処理は終端間遅延に別途加算される。
- 話者数別の傾向: DIHARD III・CALLHOME-Part2・NOTSOFAR1の高話者数サブセットで優位が広がるとしている。一方、2話者のCALLHOMEサブセットでは新モデル5.98%に対し旧ベースライン5.68%とわずかに劣る点も開示されており、全CALLHOME-Part2評価では10.32%から9.10%への改善としている。
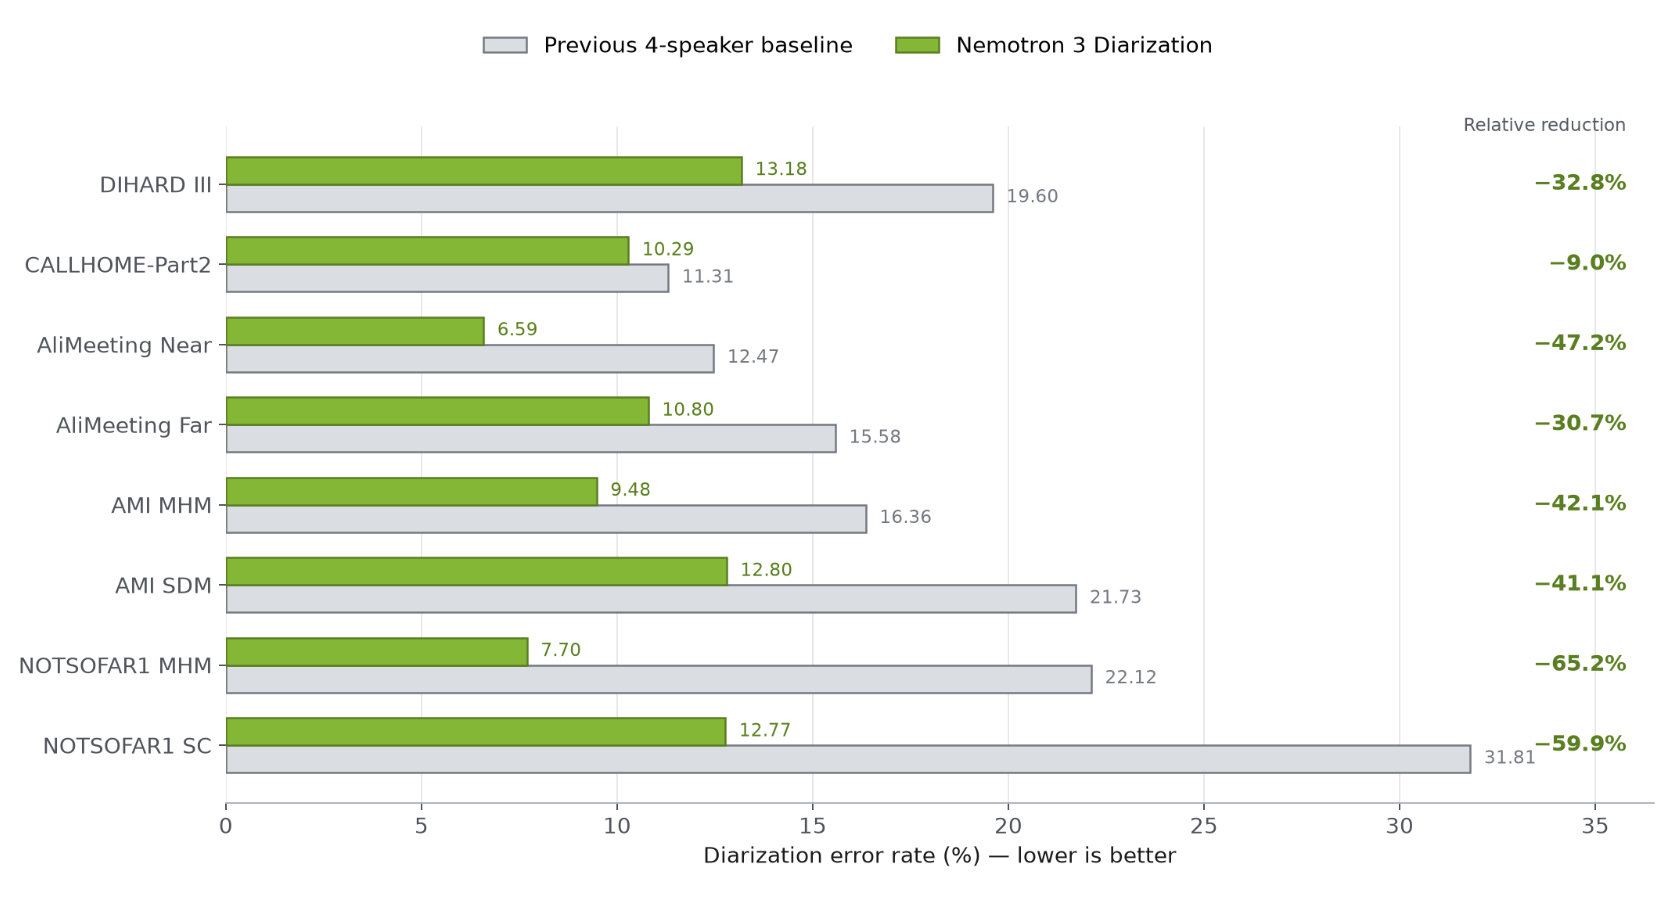
画像出典: Know Who Spoke When: Build Real-Time, Multi-Speaker AI with NVIDIA Nemotron 3 Diarization(Hugging Face Blog) のFigure 6(1.04秒遅延でのDER比較)を転載
学習データ・提供形態・ライセンス
- 学習データ: 公開データとライセンス取得データで学習し、複数話者アノテーション付きの実会話をDavid AIからライセンス取得。David AI音声を素材とする21言語にわたる大規模な模擬混合音声も使用し、David AIデータの追加で複合DERが11.19%から10.42%へ0.77ポイント低下したとしている。
- ストリーミングの仕組み: 到着順の話者活動確率を出力し、AOSCとFIFOコンテキストによるメモリ機構でチャンク間の話者割り当ての一貫性を保つ設計と説明されている。
- スループット: モデルカードでは実時間係数の高速化倍率(RTFx=音声総時間÷処理総時間)を報告。RTFxが高いほど単位計算時間あたりの処理量が多い。公表のスループット値はバッチ処理の計測であり、単一ストリームの終端間遅延ではないと注意書きがある。計測条件はBF16・NeMo PyTorchバックエンド・NVIDIA RTX PRO 5000と記載されている。
- 利用方法: NVIDIA NeMo Speechライブラリ経由で、ASR連携・ストリーミングASR・分離のみ・オフラインASRのクイックスタートを提供。Python 3.12以降・Cython・最近のPyTorchが必要としている。
- ライセンス: 利用はOpenMDW License Agreement version 1.1に準拠する。モデルはHugging Faceの
nvidia/Nemotron-3-Diarizationで公開されている。

