

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
Mistral Large 4(Le Chonk)をプレビュー公開 — 1Tパラメーター・49BアクティブのMoE、月末に重み公開へ
Mistral AIが2026年10月6日、最大・最強のモデルMistral Large 4(通称Le Chonk)の公開プレビューを発表した。1兆パラメーター・アクティブ49BのネイティブマルチモーダルMoEで、推論・指示追従・エージェント機能を単一モデルに統合する。プレビューAPIはMistral Studioで利用可能、重みは10月末の公開予定。サイバー・コーディングの一次情報ベンチマーク値を整理する。
Mistral AIは2026年10月6日(現地時間)、同社最大・最有能のモデル Mistral Large 4(ML4、通称 Le Chonk) の公開プレビューを開始した。1兆パラメーター・アクティブ49BのネイティブマルチモーダルMoE(Mixture-of-Experts)で、指示追従・推論・エージェント機能を単一モデルに統合するハイブリッド設計が特徴だ。プレビューAPIはMistral Studioで利用でき、重みは10月末の公開が予告されている。本稿は同社の公式発表ページで確認できる範囲に限定して整理する。
モデルの概要 — 仕様・提供形態・料金
- アーキテクチャ: 1兆パラメーター、アクティブ49BのMoE。ネイティブマルチモーダル入力に対応し、指示(instruct)と推論(reasoning)のハイブリッドで、エージェント機能を単一モデルに統合するとしている
- 提供形態: 現時点では公開プレビュー。プレビューAPIは同社の運営する欧州インフラ上のMistral Studioで提供され、重みは10月末に公開予定としている。アーキテクチャの詳細・追加ベンチマーク・ post-training 手法は重み公開に向けて後日開示される
- 料金(発表ページの表示値): 入力 1.36ドル/100万トークン、出力 4.18ドル/100万トークン
- 学習基盤: 欧州の自社データセンターにある NVIDIA Grace Blackwell GPU 3,800基 でゼロから学習したとしている。シリーズD(同社発表で30億ユーロ)で調達した資金を欧州データセンターの計算容量拡大に投じ、プレビュー版の背後にある強化学習(RL)実行は継続中で「飽和の兆しはない」としている
- 多言語: 学習データの相当割合が多言語で、EUの全公用語を含む 160超の言語 にネイティブ対応するとしている
- 位置づけ: 米欧のオープンウェイトモデルを大幅に上回り、中国勢を含む世界の最強オープンソースモデルと競合する水準と主張している(ベンダー主張)。サイバーセキュリティ・金融・法務などの企業ワークロードではオープンウェイトの中で最先端だとしている
コーディングとエージェント — ベンチマーク公称値
以下はいずれも同社発表ページに記載のベンダー公称値であり、独立評価ではない。
- コーディング: DeepSWE v1.1 61.7%、SWE-Atlas-QnA 59.4%、Terminal-Bench 4.0 28.3%。統合したCoding Agent Index 49.8% で、DeepSeek V4 Pro 0813やQwen3.8 Maxを上回るとしている
- 人間評価(Surge AIによる盲検評価): 専門アノテーターが5段階で採点し、ML4プレビューは 3.74 で5モデル中2位。Claude Opus 5(4.22)に次ぎ、Kimi K3(3.59)・GLM-5.3(3.60)・GLM-5.2(3.40)を上回ったとしている
- エージェント業務: Gmail・Google Sheets・Slack・Salesforce等657の業務ワークフローからなるAutomationBenchで 59.9%、長期の知識労働を評価するAA-Briefcaseで 1,393 Elo とし、いずれもDeepSeek V4 Pro等を上回るとしている
- 科学・数学: SciCode-Verifiedではオープンウェイトの中で最先端とし、Hartree–Fockシミュレーションのワンショット生成などを実演したとしている
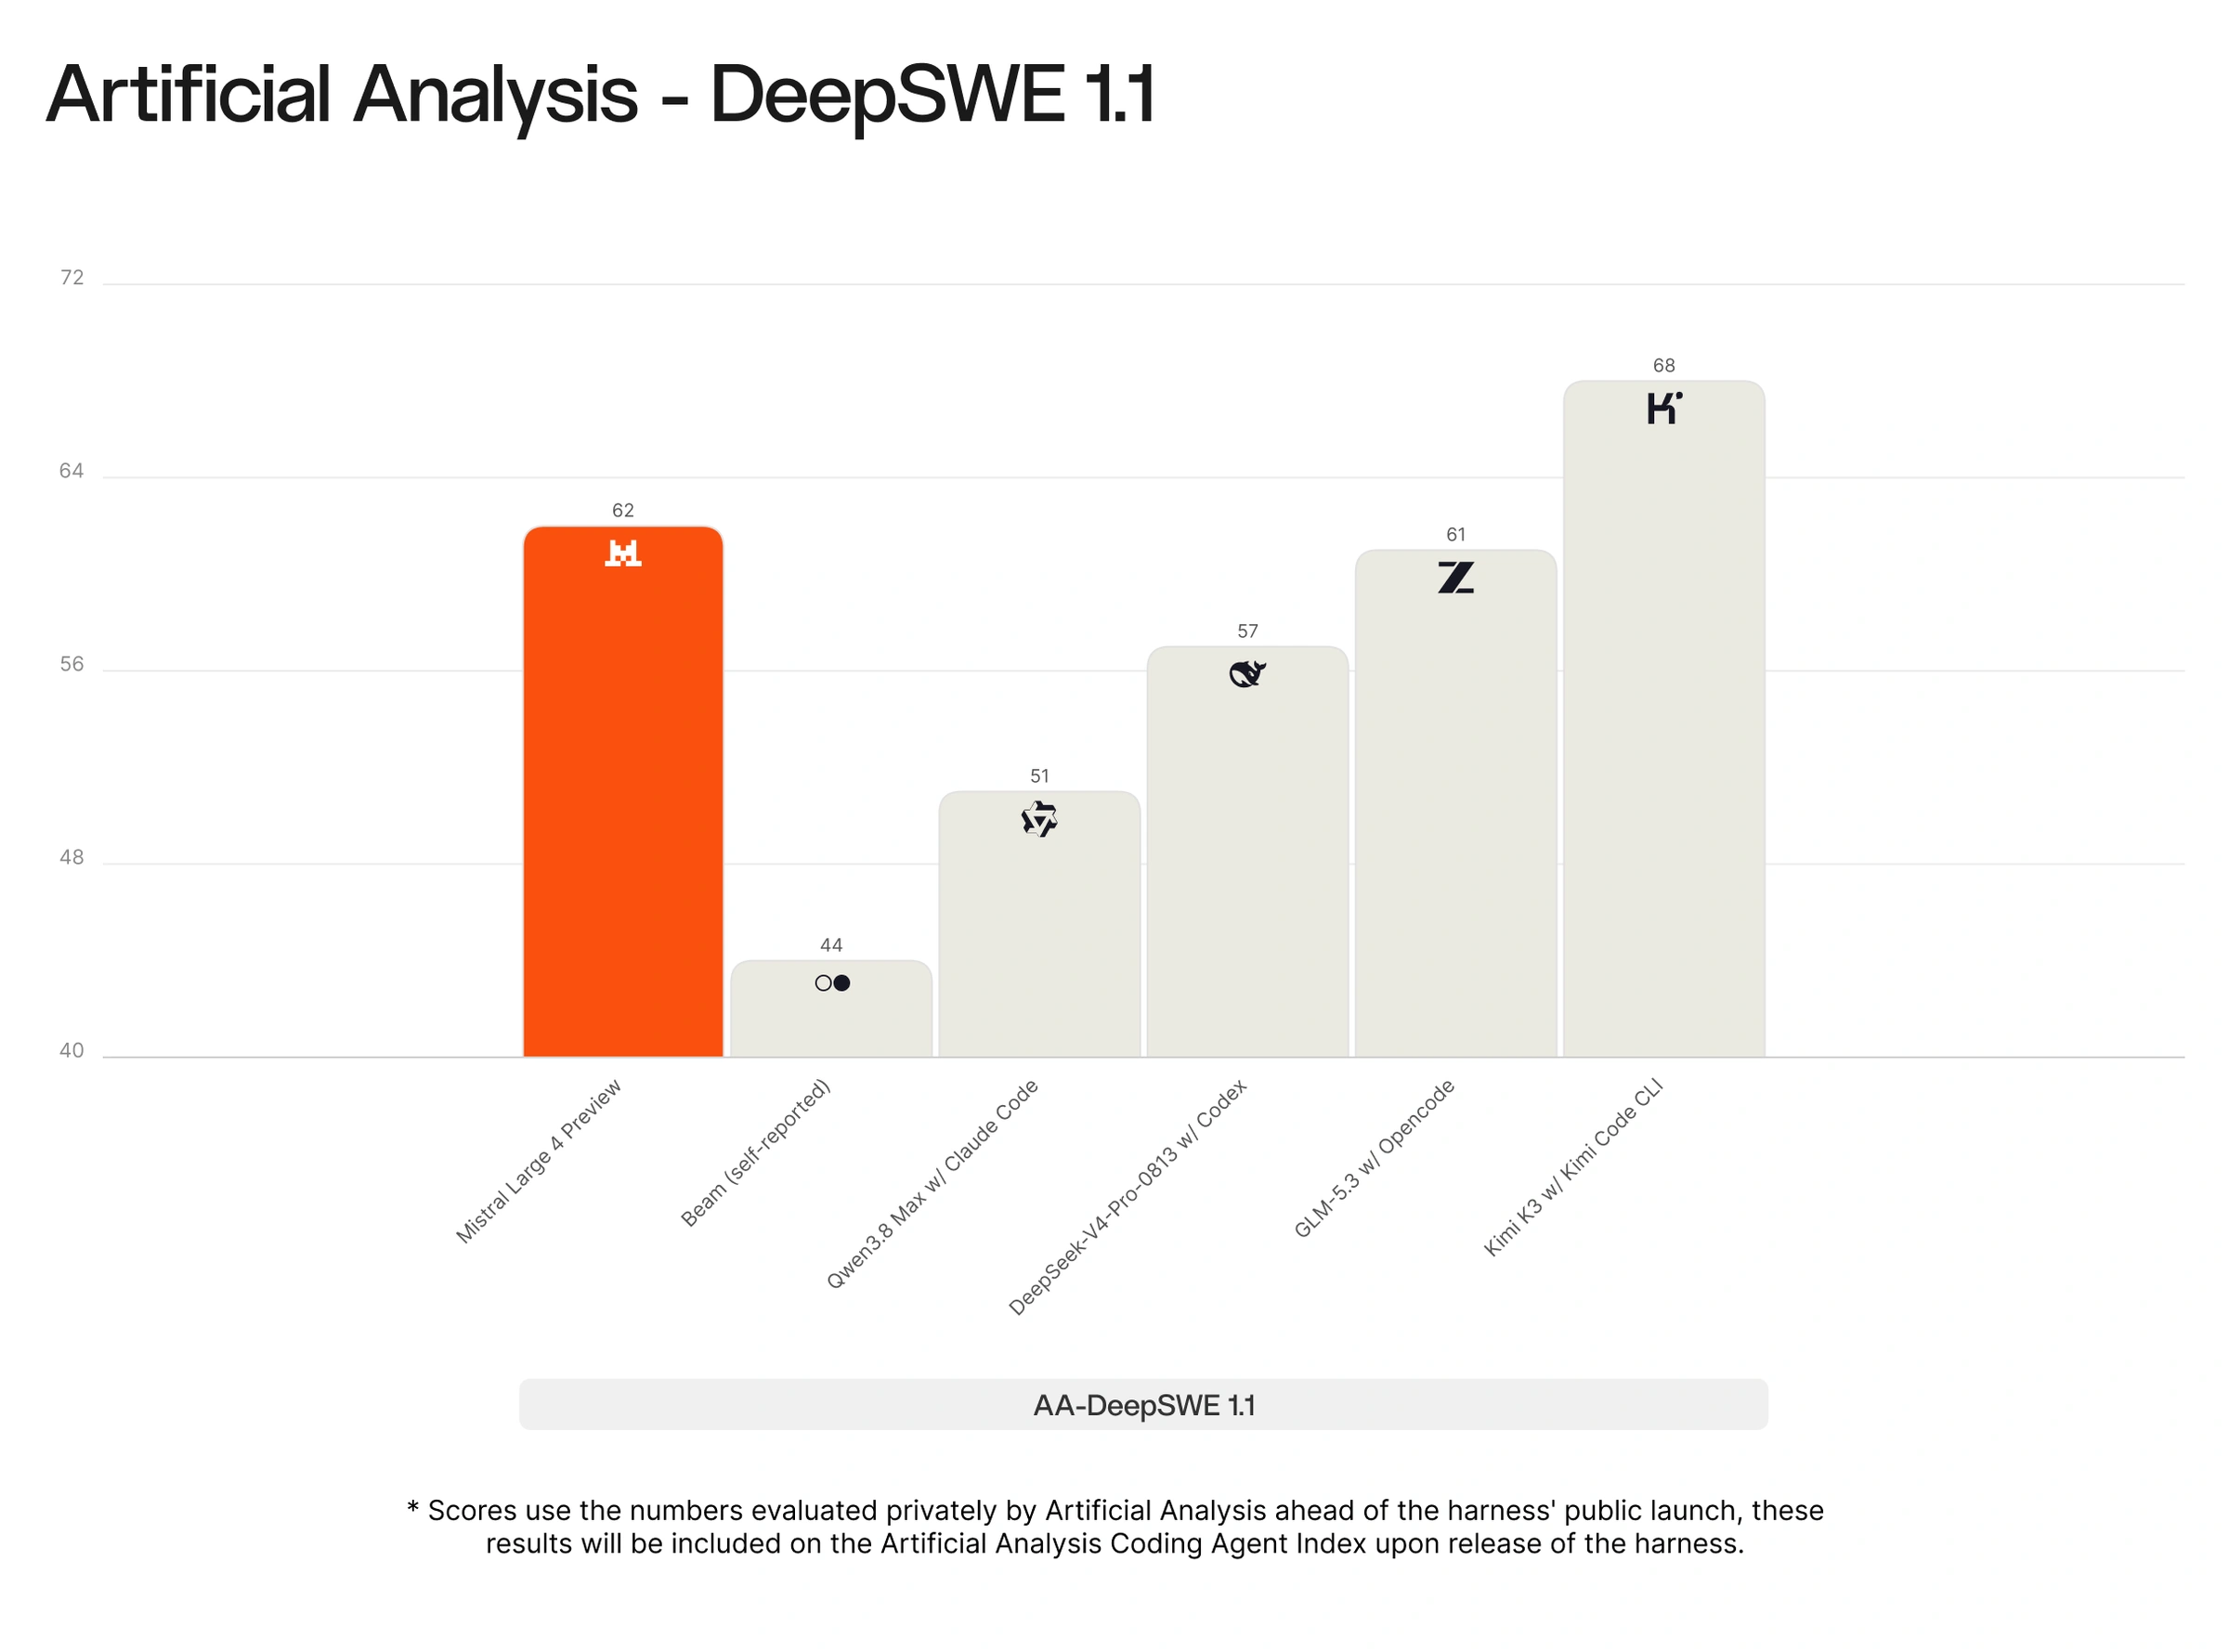
出典: Introducing Mistral Large 4 | Mistral
サイバーセキュリティ — ベンチマーク公称値と安全性の主張
- AA Cyber Index(Artificial Analysisの独立評価と同社が説明): 脆弱性の再現とパッチ適用を問うテストで 82% とし、全モデル中最高と主張している。Cybergym-E2EやCybench(セキュリティ競技由来の40課題)では 93% を解いたとし、オープンウェイトで最高級のスコアだとしている
- 拒否率をめぐる主張: 同テストではClaude Opus 5.5やGPT-6 Astraを含む一部のクローズドモデルがタスクを拒否してほぼ0点になると同社は説明し、正当な脆弱性研究やインシデント対応がプロバイダー側の拒否で止められる問題への対処として、オープンウェイトと自己展開の意義を訴えている(ベンダーの主張であり、本稿では事実確認できない)
- 攻撃耐性(ベンダー公称値): LakeraのB3 AI Security Benchmarkで攻撃の 93.3% を阻止、KORA Benchmarkで 1.691/2.0 とし、いずれも同社の測定でOSS最高水準だとしている。一方でJailbreakBench・StrongREJECT・AgentHarm由来のサイバー系有害プロンプトへの拒否率は全OSSモデルを上回るとしている
- レッドチーミング: 重み公開までの間、サイバーセキュリティのリーダー企業・審査済みパートナー・政府当局と実環境でのレッドチーミングを実施し、緩和されたモデレーションと拡張されたサイバー能力を持つ同一モデルへのアクセスを提供するとしている
- 法務・金融(第三者評価の報告): vals.aiによる代表的タスクの評価で法務・金融の双方でGPT-6-Astraを上回り、HarveyAIのLegal Agentベンチマークでは全オープンソースモデルを上回ったとしている(同社が報告する第三者評価の結果)
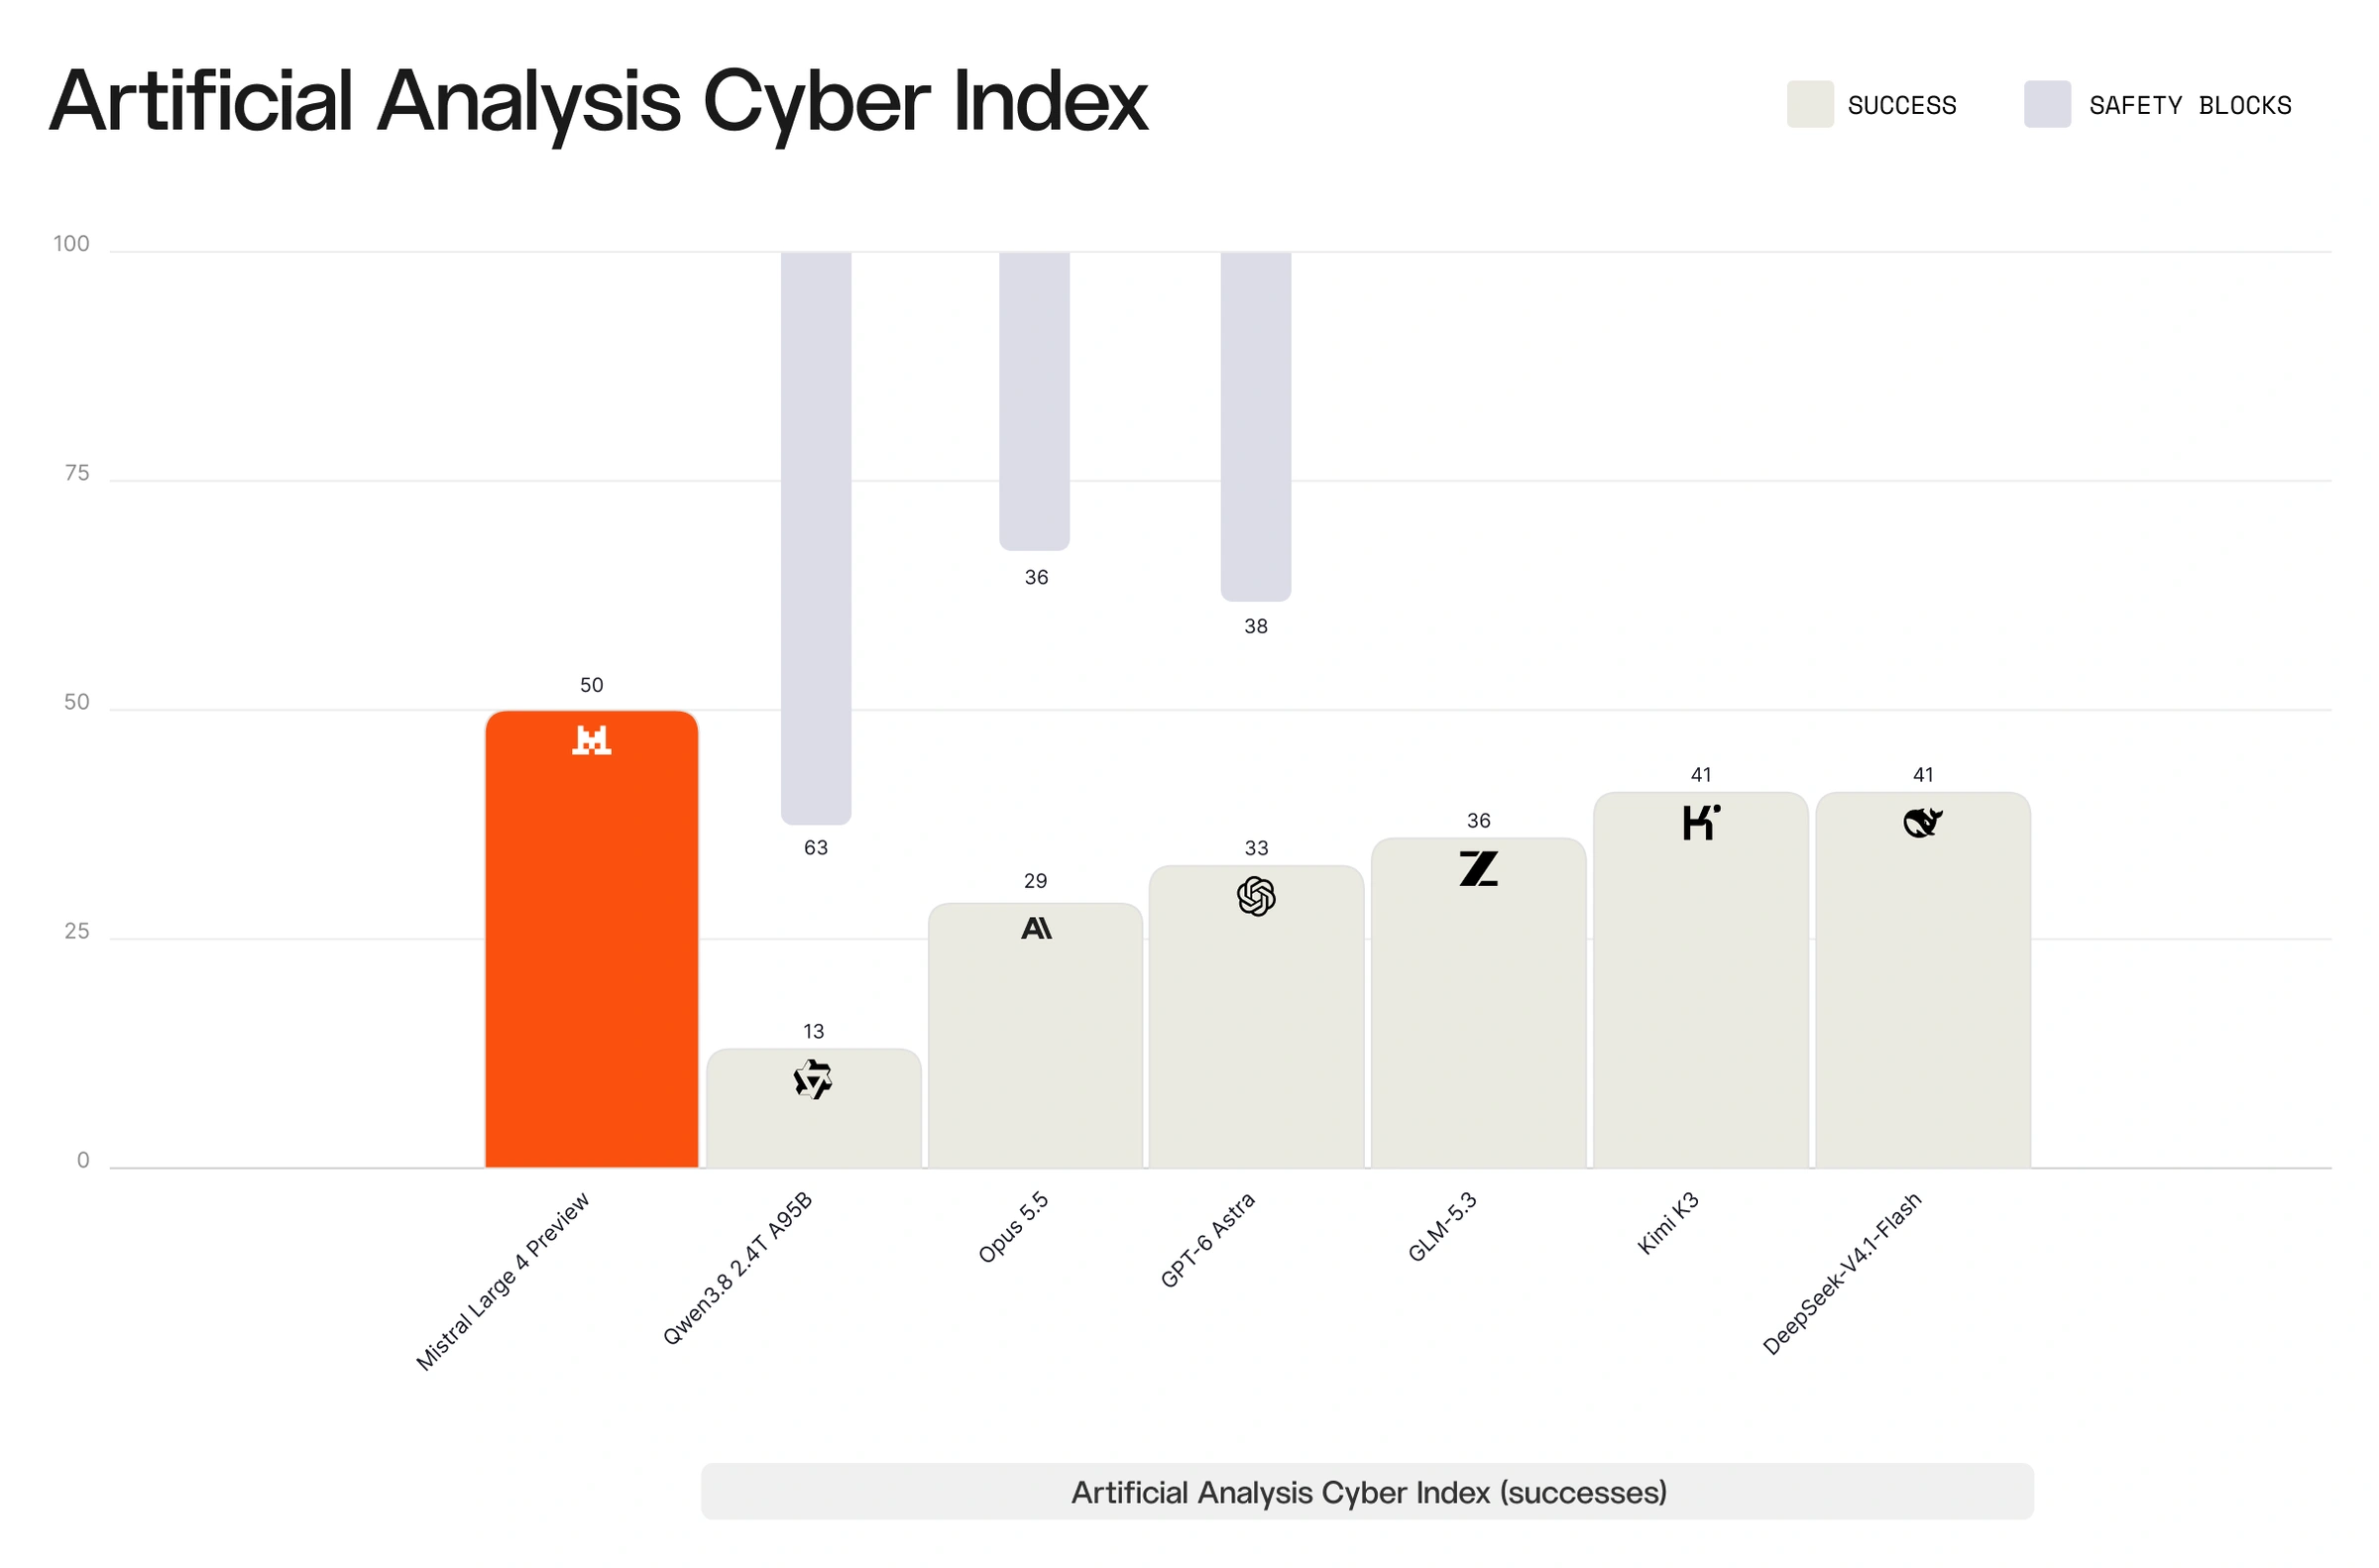
出典: Introducing Mistral Large 4 | Mistral
注意点 — プレビュー版でありRLは継続中
- 評価の性質: 本稿の数値はすべて同社発表ページの公称値で、独立した再現評価ではない。強化学習の実行が継続中で最終チェックポイント前に性能が変動しうるプレビュー版である点に留意が必要だ
- 未開示事項: アーキテクチャの詳細、追加ベンチマーク、post-training手法の詳細は重み公開時に開示予定とされ、現時点では確認できない
- 比較対象の限定: 「米欧のオープンウェイトで最先端」などの主張は同社の集計によるもので、対象モデルや時点の定義は発表ページの記載範囲に依存する
