NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / Cloudflare
Cloudflare、オープンな意思決定モデル「Clef」と「Clef-flash」を公開 — Workers AIで提供、Apache 2.0でオープンソース化
Qwenベースの27Bと9Bのマルチモーダル・ディシジョンモデル。状態と型付きの問いを1フォワードパスで確率判定し、Typesafe AIのJev APIと互換。Jev Decision Indexで首位と自称し、自社データで微調整できる強化学習基盤も同時に発表した。
Cloudflareは2026年10月1日、エージェントの判断処理に使う意思決定モデル「Clef」と軽量版「Clef-flash」を公開した。分類や振り分けのような「決める」処理を、型付きの出力と確率で安く・速く・安定的に返すモデルで、Workers AI上でホスト提供すると同時に、Hugging Face上でApache 2.0ライセンスとしてオープンソース化した。あわせて、利用者が自社データでClefを微調整できる新しい強化学習基盤も発表した。以下は同社公式ブログの発表内容の整理であり、性能数値はすべて同社自身の公開ベンチマーク値である。
意思決定モデルとは何か — LLMの非決定性と使い分け
- 定義: 意思決定モデルは、エージェントがどう振る舞うべきかを確率付きで分類するモデルだとしている。例として、カスタマーサポートの問い合わせを入力し、緊急度や担当チームの割り当てを返す用途を挙げている。
- LLMとの対比: 大規模言語モデル(LLM)は非決定的で、推論やテキスト・ツール呼び出しの生成といった open-ended な処理に向く。一方、意思決定モデルはワークフロー中の判断が必要な箇所に組み込み、境界のある構造化出力を安く・速く・一貫して返す位置づけだとしている。
- 背景: ここ数週間、Typesafe AIのJevやSystem Oneといった意思決定モデルが話題になっていたことに触れ、従来の分類モデルと異なり、分類カテゴリの追加のたびに再学習しなくても多様な入力に適用できる点を特徴としている。
- 入出力: 状態(テキスト、JSON、画像、動画)と型付きの問いのスキーマを入力し、各問いの各選択肢の確率を1フォワードパスで返す。自由形式のテキスト生成はなく、出力パースも不要だとしている。
2モデルの中身 — Qwenベースの27Bと9B、Jev API互換
- Clef: Qwen3.8-27Bをベースに後段学習した27Bのマルチモーダルモデル。高精度が要る判断向けの上位モデルと位置づけている。
- Clef-flash: Qwen3.5-9Bをベースに後段学習した9Bモデル。レイテンシが重要な判断向けの高速版としている。
- ホスト提供: どちらもWorkers AI上でホストされ、すぐに試用できるとしている。
- 互換性: Jevと同様の厳密に型付きの出力を返し、API互換のため既存のJev利用者は容易に置き換えて実験できるとしている。Hugging FaceのモデルカードではSystemOneとのAPI互換もうたっている。
- 公開: Hugging Face(Cloudflare/clef、Cloudflare/clef-flash)でApache 2.0ライセンスとして公開し、ローカル実行や実験に使えるとしている。
ベンチマークの主張 — Jev Decision Indexで首位と自称
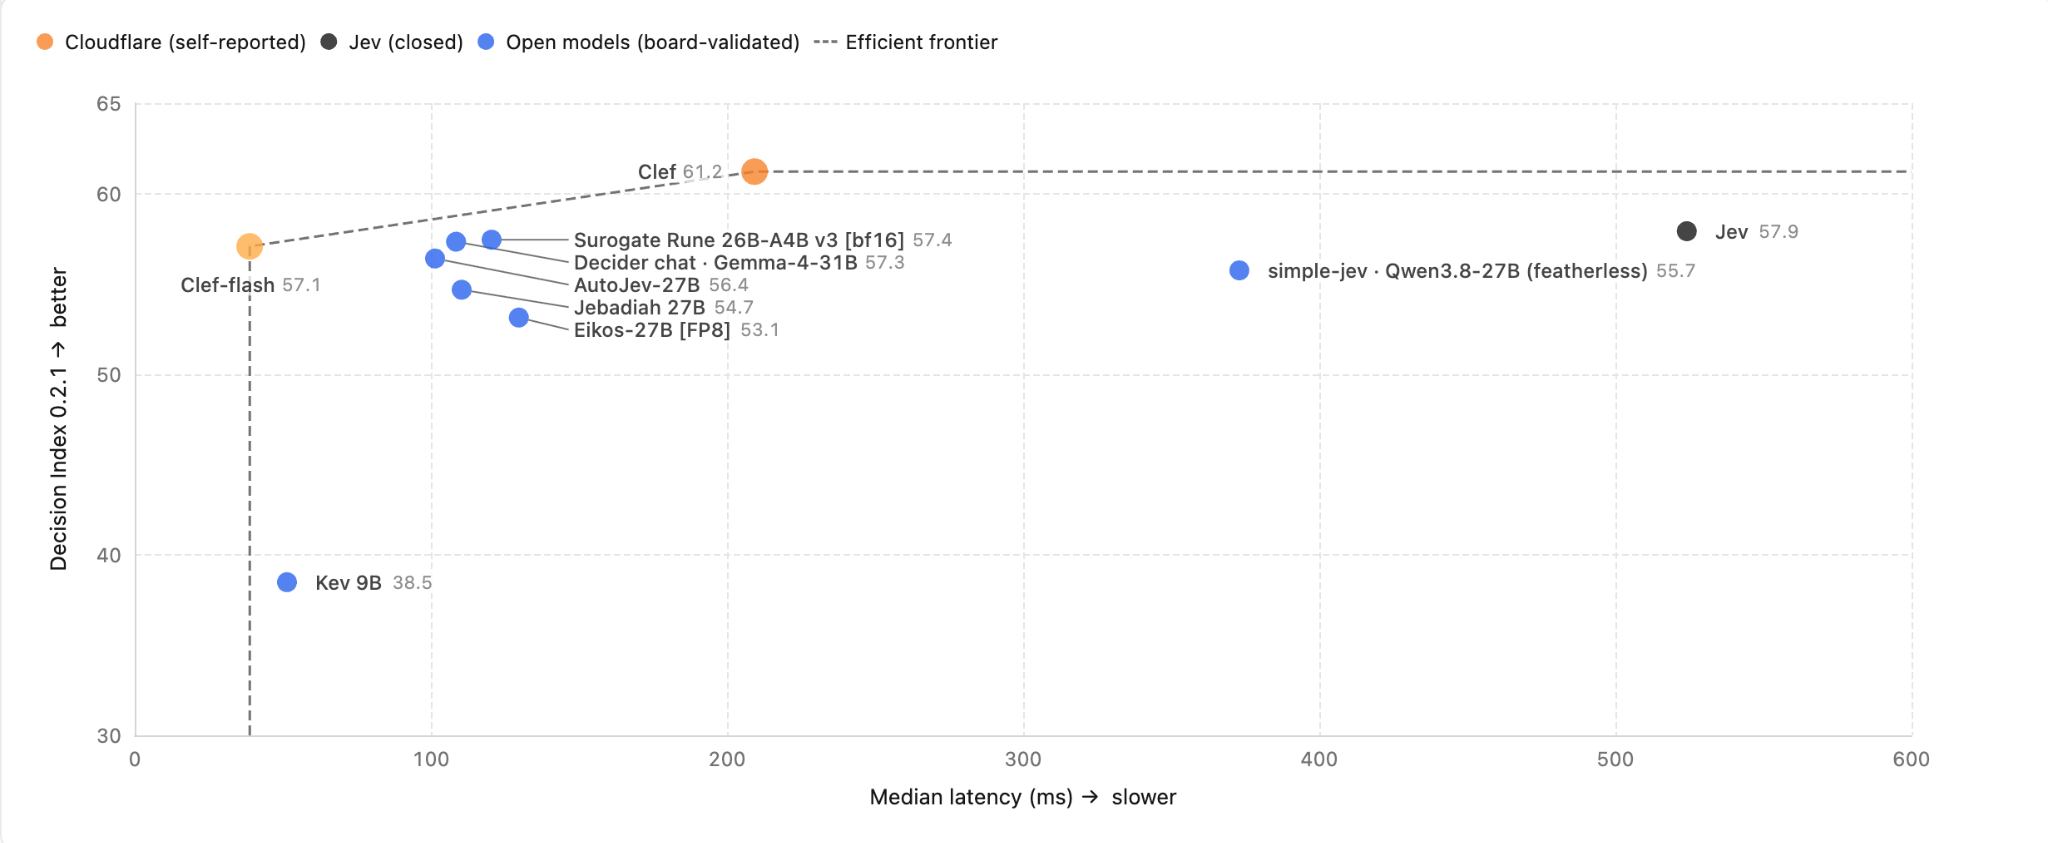
- 主張: Typesafe AIのJevが定義した評価群「Jev Decision Index」で、Clefが現時点で首位だとしている。全結果はライブのベンチマークデモサイトで確認できるとしている。
- 評価の内訳: BFCL、ToolRet、When2Call、CLINC150+OOS、BRIGHT、PhishNChips、家電ドメインの分類、ワークフロー評価など、意思決定に関わる複数の評価を自社で実施し、市場で人気のモデル群と比較した表を掲載している。
- 速度との関係: 精度とレイテンシの関係を示す比較チャートも掲載し、Clefが精度・速度の両面で有利な位置にあると主張している。下図がそのチャートである。
出典: Introducing Clef: our open-source decision models, and new RL fine-tuning platform — Cloudflare Blog
- 注意: いずれもベンダー自身による測定・選定の評価であり、独立した第三者検証ではない。導入判断の際は自社のタスクでの実測が必要だ。
強化学習基盤 — 自社データでの微調整とRLCD
- 新基盤: 顧客が自社データでClefを微調整できる強化学習(RL)基盤を同時に発表した。用途に合わせた調整を可能にする狙いだとしている。
- 学習手法: 「Reinforcement Learning for Calibrated Decisions(RLCD)」を副次的な最適化目標として開発したとしている。順序尺度の選択肢で隣接する選択への部分点、厳密なレコード出力への報酬、分布シフトを抑える参照ペナルティを組み合わせ、精度と汎化を高めるとしている。
- 位置づけ: 汎用のホストモデルで試し、必要に応じて自社データで絞り込む、という二段構えの利用を想定している。