NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / NVIDIA
NVIDIA、表データ特化の基盤モデル「Kumo Tabular」を公開 — 学習不要で分類・回帰を予測
ラベル付きの行をコンテキストに1回のフォワードパスで予測する表データ用ファウンデーションモデル。28M〜215Mの3サイズ、合成データのみで事前学習、商用利用可のOpenMDW-1.1。TabArenaなど4ベンチマークで1位としている。
NVIDIAは2026年9月29日、表データ向けのオープンファウンデーションモデル「Kumo Tabular」を公開した。NVIDIA Kumo Structuredモデルコレクションの一部で、ラベル付きの行を例示として与えると、新しい行のラベルを1回のフォワードパスで予測する。分類と回帰の両方に対応し、タスクごとの学習・ハイパーパラメータ調整・特徴量エンジニアリングを不要にするとしている。以下は同社の公開内容の整理であり、評価数値はすべてNVIDIA自身の報告値である。
仕組み — 列・行・コンテキストの3段階の注意機構
- 予測の流れ: ラベル付きのコンテキスト行と、予測したいクエリ行を渡すと、分類ではクラス確率、回帰では999分位数を返し、点予測と不確実性の推定が得られる仕組み。
- アーキテクチャ: 表の構造に合わせたTransformerで、列内での値の意味づけ(列注意)、行内の列同士の関係(行注意)、ラベル付き行とクエリ行の対応づけ(コンテキスト内学習)を組み合わせる。設計はTabICLやTabPFNで導入された方式を踏襲している。
- 効率の工夫: コンテキスト側はクエリを見ないためキーと値を一度だけ計算して再利用でき、クエリ行側はキャッシュを縮小するTest-GQAを使うとしている。
- 学習データ: 人工の表データのみで事前学習した。構造的因果モデル(SCM)から手順に沿って表を生成し、大半の行をラベル付きコンテキストとして残りの行の予測を学習する方式で、Small・Medium・Largeがそれぞれ約3,500万・7,100万・1億3,700万の人工表を見たとしている。
- 規模と使い方: Small・Medium・Largeの3サイズで28M〜215Mパラメータ。オープンソースの推論ライブラリ経由で利用し、初回利用時にHugging Faceから重みを取得する。
pandas.DataFrameから予測までの短いコードで動く。
評価結果 — 4ベンチマークで首位を報告(ベンダー公称値)
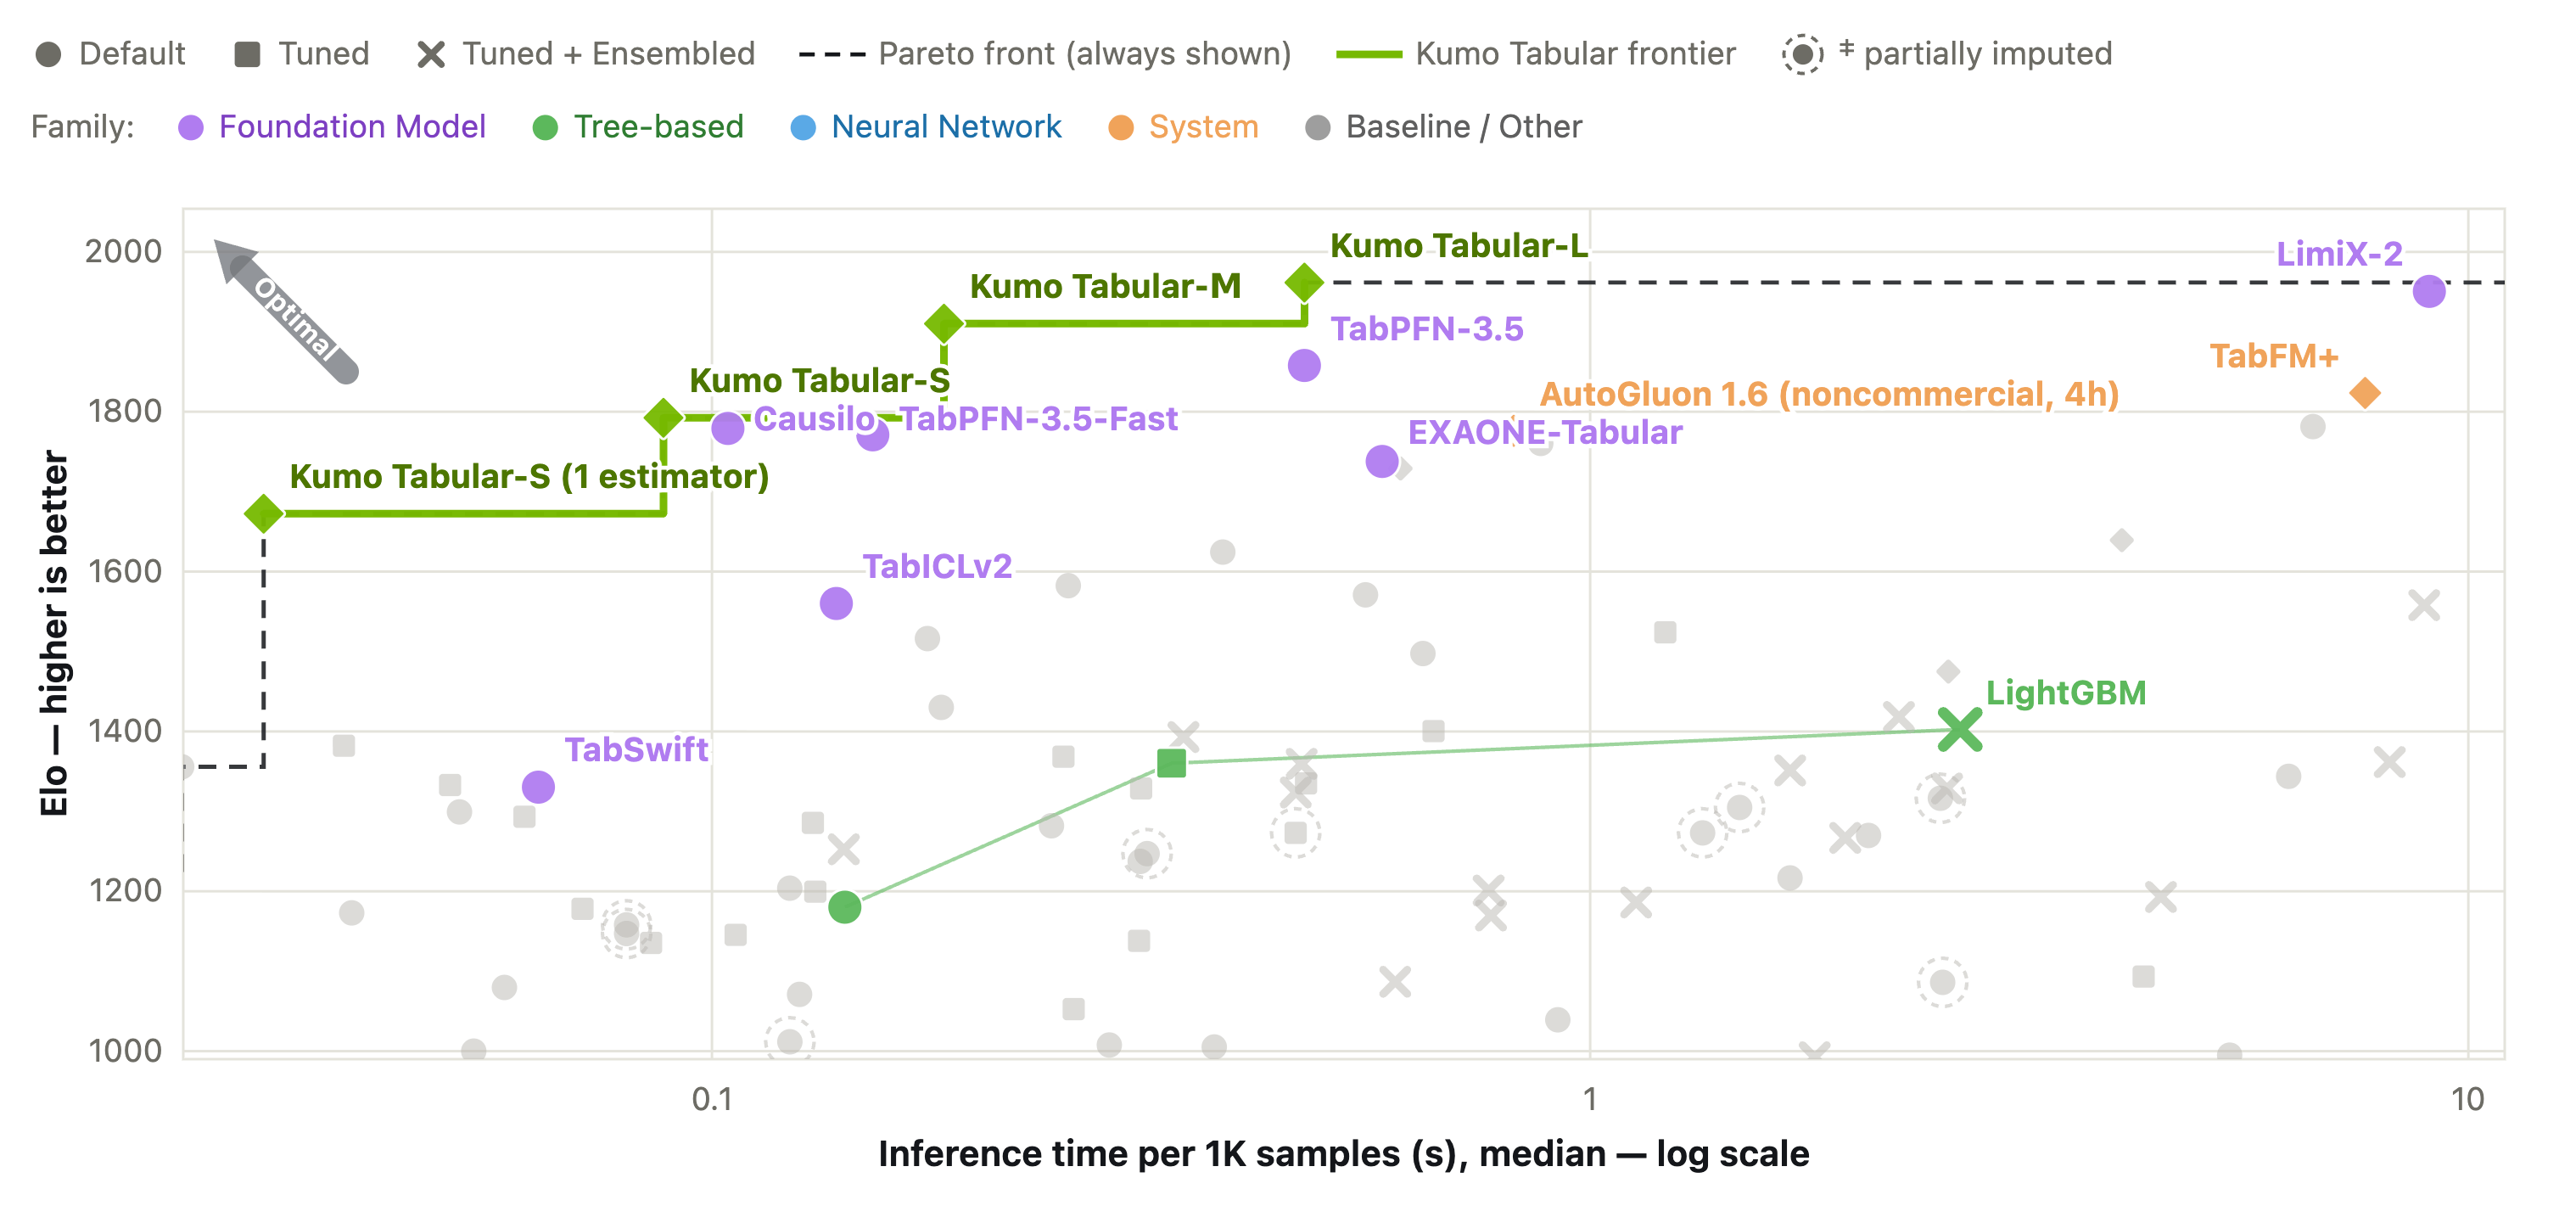 出典: NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction
- TabArena: 総合1位でELO 1950。同一条件(単一RTX 6000 Pro)の評価でLimiX-2の17倍の速度としている。3サイズすべてが精度-効率のパレートフロント上に新たな最先端を形成したという。
- BeyondArena: ELO 1418、Improvabilityスコア7.78%でリーダーボード1位としている。
- TALENT: 分類精度・分類log-loss・回帰RMSEのいずれも総合トップで、平均ランクはそれぞれ6.67・3.98・4.22としている。
- ScoringBench: 予測分布のベンチマークでLargeとMediumが平均ランク1位・2位としている。
- 読み方の注意: いずれもNVIDIAが既定設定で計測した自社報告値であり、特定の業務データでの順位や速度を保証するものではない。勾配ブースティングやAutoGluonとの比較は同社の評価設定下の結果である。
提供条件と制約 — 商用利用可、ただし適用範囲の確認が必要
- ライセンス: OpenMDW-1.1で公開され、商用利用が可能としている。モデルコードはGitHub、重みはHugging Faceで取得できる。
- 対応する入力: 数値列とカテゴリ列を直接扱う。テキスト・画像・タイムスタンプは同梱の前処理レシピで特徴量化する必要がある。
- クラスの上限: 1回のフォワードパスでの分類は最大10クラスまでで、それ以上のクラス数は誤り訂正出力符号で拡張する。
- コンテキスト長: 学習は最大6万行・100列までの表で行われており、学習範囲を大きく外れた表や、クエリ行とコンテキスト行の分布が異なる場合、精度が落ちる可能性があるとしている。
- 運用上の注意: 導入前には自前のホールドアウトデータで精度とキャリブレーションの検証が推奨されている。学習レシピと合成データ生成器は後日公開予定とされている。