NAW / COMPUTE 06
IMAGE: AI生成ビジュアル
COMPUTE / INFRASTRUCTURE
Ai2、GPUクラスタのスケジューラ刷新を公開 — 時間予算と階層フェアシェアで割当充足98%
アレン人工知能研究所(Ai2)は2026年10月9日(UTC)、GPUクラスタのスケジューリング刷新をHugging Faceブログで公開した。優先度方式からGPU時間予算・階層フェアシェア・タイムスライシング契約へ移行し、30日間の試行で割当時間の98%を提供し、デバッグジョブのp90待ち時間を2時間から30秒に短縮したとしている。いずれも同研究所の報告値である。
アレン人工知能研究所(Ai2)のAIインフラチームは2026年10月9日(協定世界時)、同研究所のGPUクラスタ向けにスケジューリング方式を刷新したことをHugging Faceブログで公開した(執筆Kyle Wiggers)。数千基のNVIDIA H100・B200・B300、88〜1024基規模のクラスタ、約150人の研究者を抱え、需要が供給の2〜3倍という状況下での取り組みである。本稿は同記事で確認できる範囲の整理で、数値はすべて同研究所の報告値である。
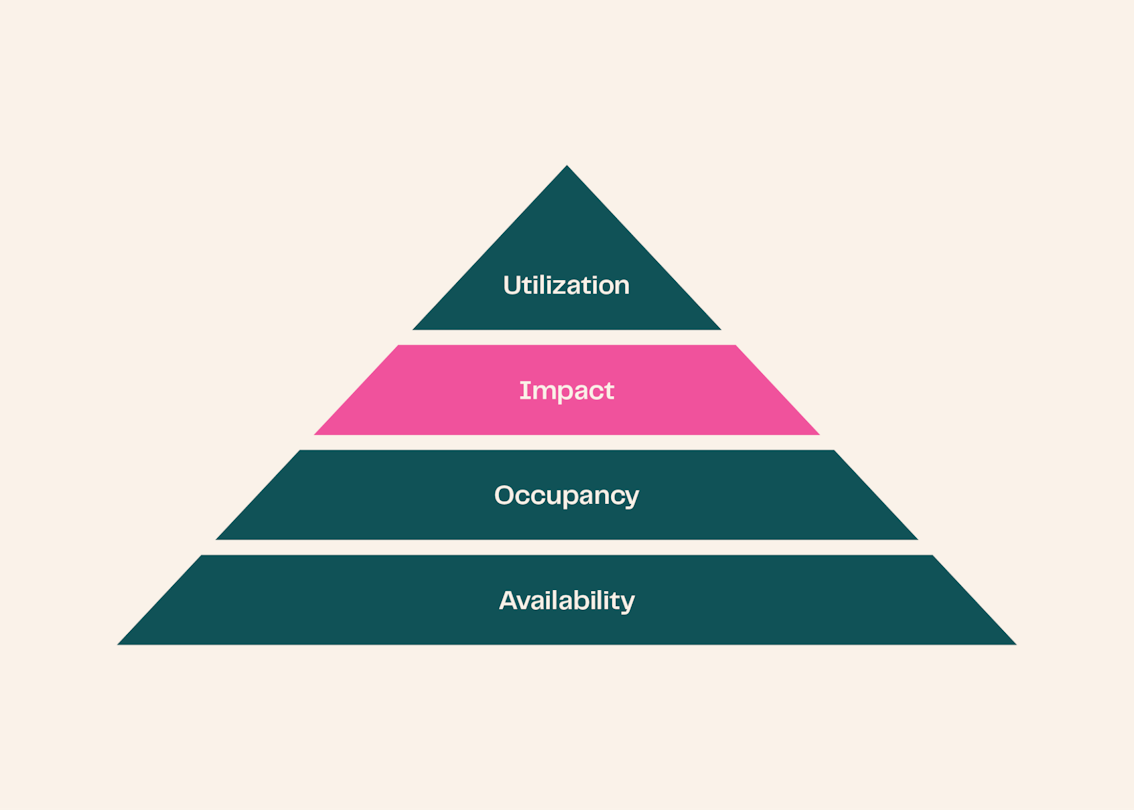
画像出典: Impactful scheduling for GPU clusters — Hugging Face(Ai2)
背景 — 需要が供給の2〜3倍、優先度方式の限界
- 規模: 数千基のH100・B200・B300を88〜1024基規模のクラスタに配置し、約150人の研究者が使う。提出済みワークロード基準で、常時利用可能量の2〜3倍の要求が滞留している。
- 旧方式: 優先度ベースのスケジューラで、プリエンプション(先取り)拒否の選択が可能だった。各チームにはプリエンプション保護ジョブの同時利用GPU数に上限があり、プリエンプション可のジョブは空きGPUを使えた。
- 問題: 重要度とGPU時間の対応付けが不透明になり、原因特定が遅れた。チームがGPU集合を占有する回避策に走り、GPUが遊休する事態も起きた。優先度の引き締めや手作業の割当では解決しなかったとしている。
- 考え方: 同チームはこの課題を「利用者が自分のジョブの価値を最もよく知る」という資源配分の問題と捉え、GPUそのものではなくGPU時間の配分へ発想を転換した。
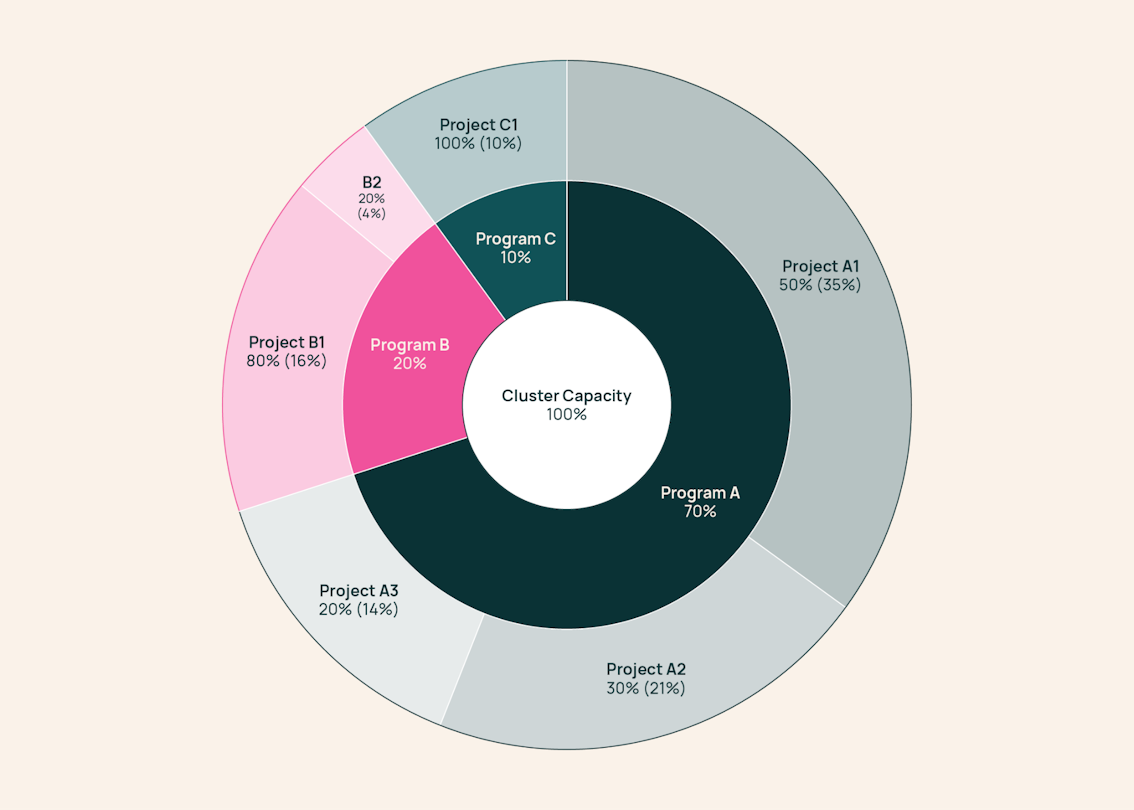
画像出典: Impactful scheduling for GPU clusters — Hugging Face(Ai2)
新方式 — 時間予算・階層フェアシェア・契約
- GPU時間予算: GPU時間の要求はすべて予算で裏付ける必要があり、予算なしの要求はプリエンプションから保護されない。旧方式の高優先度は無償で使えたため乱用されたが、新方式では「無償のものはない」としている。
- 階層フェアシェア: プログラム階層に沿ってGPU時間を比例配分し、7日間のスライディング窓で占有率を追跡する。過少利用の割当を過剰利用より先に配置し、週単位で割当時間を受け取れる設計としている。
- スケジューリング契約(タイムスライシング): クラスタ利用の条件として、ジョブは意味ある進捗に必要な最小実行時間を申告する。最小実行時間内はプリエンプションから保護され、超過後は自動で削除・再キューされ得る。不健全ホストの負荷排出や修復作業もしやすくなるとしている。
- 利用者の声: 研究者からは「計算資源が3割増えたように感じる」との声があったと紹介している(旧方式では枠を使い切れない時間帯の計算資源が失われていたが、新方式では後から割当超過のバーストで取り戻せるため)。
検証 — シミュレーションと30日試行の報告値
- 事前検証: 予算方式の導入前に小規模なシミュレータを構築し、投入スケジュールから先取りと割当判断を試した。手作りのテストデータでは、デバッグ用ジョブ(小数GPU・最小実行15分以下)のp90待ち時間が約6時間から約5分に減るという予測だった。
- 実測: 7月末からクラスタ単位で段階導入し、30日間の試行では、チームに owed(割当から需要で頭打ちした分)なGPU時間の98%を提供した。15件のチーム割当のうち13件が95%以上を受け取り、最悪でも90%だったとしている。
- デバッグ待ち時間: 実測ではデバッグジョブのp90待ち時間が2時間から30秒に減り、予測を上回ったとしている。クラスタ占有率は98%で安定を維持したとしている。
- 学習コスト: 段階導入のため初期はクラスタごとに挙動が異なり、旧用語(優先度など)が残ったことで混乱もあったと率直に記している。一方で、実験に必要なGPU量の議論が研究グループ間で活発になったとしている。