NAW / COMPUTE 06
IMAGE: AI生成ビジュアル
COMPUTE / Allen Institute for AI
Ai2、MoE学習基盤「Olmo-core 3」を公開 — 1兆パラメータ級のオープンな学習スタック
エキスパート常駐のDDP方式への刷新で、47BパラメータMoEの学習スループットが従来比約2.7倍に。エキスパート8→128でもスループット低下5%未満、1.2兆パラメータ構成で858 TFLOP/s/GPUを記録したとしている。
アレンAI研究所(Ai2)は2026年10月1日、大規模言語モデルの開発フレームワークの大幅刷新版「Olmo-core 3」を公開した。 mixture-of-experts(MoE)向けに再設計されたオープンな学習システムで、1兆パラメータ級へのスケーリングと計算効率の両立を狙う。次世代Olmoの中核基盤でもあり、ツールと学習インフラごと公開する方針の一環だ。以下は公式ブログの発表内容の整理であり、数値はすべて同研究所自身の公開ベンチマーク値である。
何が変わったのか — FSDPからエキスパート常駐のDDPへ
- 背景: MoEは入力ごとに一部のエキスパートだけを使うため効率的だが、モデル全体をGPUメモリに保持し、入力を適切なエキスパートへ振り分ける仕組みが必要になる。従来のOlmo-coreのMoE実装は完全シャーディングデータ並列(FSDP)で、学習のたびに重みを集約・再分散していた。
- 変更点: Olmo-core 3は分散データ並列(DDP)ベースに切り替え、エキスパートをGPUに常駐させ、関連データをエキスパート側へ送る方式にした。バッチごとの重みの集約・再分散を避ける設計だ。
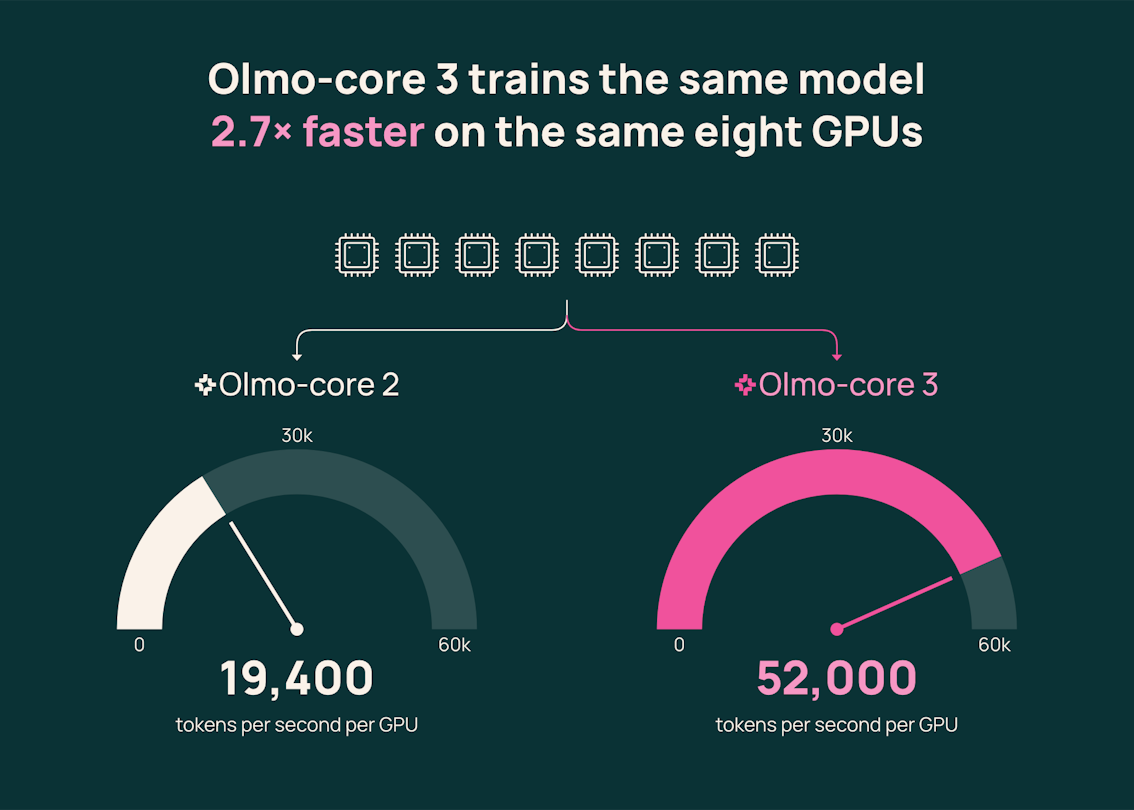
- 効果: 8基のNVIDIA B300での予備試験では、47BパラメータのMoEでGPU当たり毎秒52,000トークンを処理し、従来実装の19,400トークンから約2.7倍になったとしている。
- 位置づけ: 確立された選択肢としてNVIDIAのMegatron-Coreがあることに触れつつ、Olmoの基盤フレームワークに統合されたMoE学習スタックとして再設計したものだとしている。
スケーリングの中身 — エキスパート増量と3つの分散手法
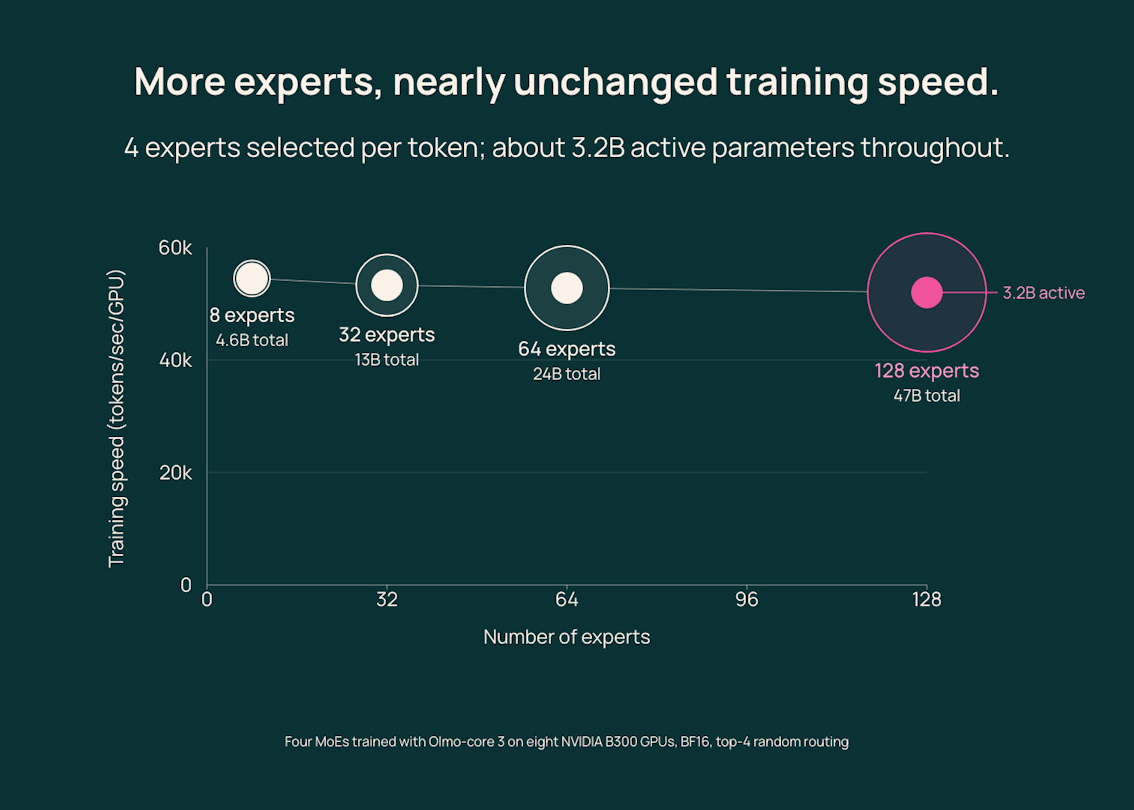
- エキスパート拡張: 1トークン当たりに使うエキスパートを4つに固定したまま、エキスパート数を8から128に増加。トークン当たりの活性パラメータを約3.2Bに保ちながら総パラメータは4.6Bから47Bに拡大し、学習スループットの低下は5%未満だったとしている。
- 分散の3手法: エキスパートをGPU群に分散するエキスパート並列、層を分割するパイプライン並列、オプティマイザ状態を分散保持する分散オプティマイザを組み合わせ、全GPUがモデル全体を保持せずに済むようにしている。
- 効率化の工夫: ルーティング済みデータを直接エキスパート入力バッファに置くrowwise expert parallelism、ルーティング情報をGPU上に保持するGPU-resident routing、多数の小さなエキスパート計算を束ねるgrouped GEMMを導入した。
- 低精度化: 低精度数値形式MXFP8に対応し、4基B300での制御ベンチマークでは基準のBF16比でスループットが約21%向上、ピーク活性メモリは103 GiBから95 GiBに減少したとしている。利得の多くはフィードフォワード計算とエキスパート間データ移動から来たという。
1兆パラメータ級の検証 — 858 TFLOP/s/GPUと2.38兆の到達試験
- 大規模構成: NVIDIA B300上で幅広い構成を検証し、512基GPU上の1.2兆パラメータ(トークン当たり活性58.36B)構成で、GPU当たり858 TFLOP/sの最高スループットを観測したとしている。システム性能の測定であり、学習モデルの品質評価ではないと明記している。
- 到達試験: エキスパート間通信の代替方式DeepEP v2の実験では、総パラメータ2.38兆の構成に到達した。短時間の容量試験であり、持続的な学習性能を示すものではないとしている。
- 学びの公開: 技術レポートには採用しなかった手法の知見も収録している。均衡ルーティングを促すスコアが改善しても実負荷は偏る「token gerrymandering」、エキスパートの学習率引き下げが改善につながらなかったこと、同じ行列形状でも入力値で計算時間が変わるため性能比較には入力値の一致が必要なこと、通信と計算の重ね合わせが逆に遅くなる場合があることなどを挙げている。
次世代Olmoと公開方針 — モデルとインフラの両輪オープン化
- 次世代Olmo: 次世代のOlmoはMoEアーキテクチャを採用し、同研究所として最も高性能で、最大のデータセットと最長のコンテキスト窓を目指すとしている。新スタックはその基盤になる。
- 完全オープン: 研究者や開発者が独自のMoE学習、異なるハードウェアへの適応、ルーティングや並列化の実験に使えるとしている。モデル重みだけでなく、インフラと学習判断も開くことでオープンなモデル開発を進める考えだ。
- 資料: 設計の詳細は技術レポートとGitHub(allenai/olmo-core)、データ・専門家・パイプライン並列の連携を解説するインタラクティブ資料で確認できる。