

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
TIIが音声認識モデル「Falcon-ASR」を公開 — 16億パラメーター、アラビア語WER 20.92%を報告
UAEのTechnology Innovation Instituteがアラビア語中心の音声認識モデルFalcon-ASRを2026年10月7日に発表した。6種のアラビア語試験で平均WER 20.92%、首長国方言の内部評価でWER 22.73%、英語7試験で平均WER 5.74%と報告している。
UAEのTechnology Innovation Institute(TII)は2026年10月7日、音声認識モデル「Falcon-ASR」を発表した。パラメーター数は16億で、アラビア語、とりわけ首長国(エミラーティ)方言に重点を置きつつ、英語・フランス語・スペイン語・ポルトガル語にも同一重みで対応するという。本稿はHugging Face上の公式ブログ発表で確認できる範囲に限定して整理する。いずれの数値もTIIチーム自身の報告であり、独立した第三者検証ではない。
モデルの位置づけと対応内容
- 規模と開発元: 16億パラメーターの音声認識モデル。アブダビのTIIが開発した
- 対応言語: アラビア語を中心に、英語・フランス語・スペイン語・ポルトガル語に対応。5言語すべて同一重みで動作し、言語フラグの指定は不要で、話された言語で書き起こしを出力するという
- 方言対応: 現代標準アラビア語(MSA)だけでなく、首長国方言や他の湾岸・地域方言、英語を学習データに含める。日常会話の方言形や言語切り替えの書き起こしを目指したものだ
- 単語タイムスタンプ: 書き起こし結果の各単語と音声中の位置を結びつける単語レベルのタイムスタンプに対応する
- 基盤: Falcon3-Audioの取り組みを土台とし、アーキテクチャと学習手法は論文「Competitive Audio-Language Models with Data-Efficient Single-Stage Training on Public Data」で説明されているという
- 利用形態: Hugging Faceのデモスペースで試用できる。API提供やネイティブアプリは計画中と案内されている。重みの公開有無やライセンス条件は今回の発表文からは確認できない
アラビア語評価の公称値(いずれもベンダー報告)
- 評価手順: ELM Research Centerが維持するOpen Universal Arabic ASR Leaderboardの手順に従い、6試験の等重み平均WERとCERで評価。数値が低いほど良い
- 平均WER 20.92%: 6種のアラビア語試験の平均で20.92%。参照した2026年9月30日時点のリーダーボード snapshot における最良の公開結果23.17%を2.25ポイント下回ったとしている。競合の数値は公開済みリーダーボードの平均値だという
- 評価条件の注意: 競合比較は特定時点のスナップショットに基づくベンダー側の集計であり、リーダーボードの更新や評価マニフェストの違いで結果は変わりうる
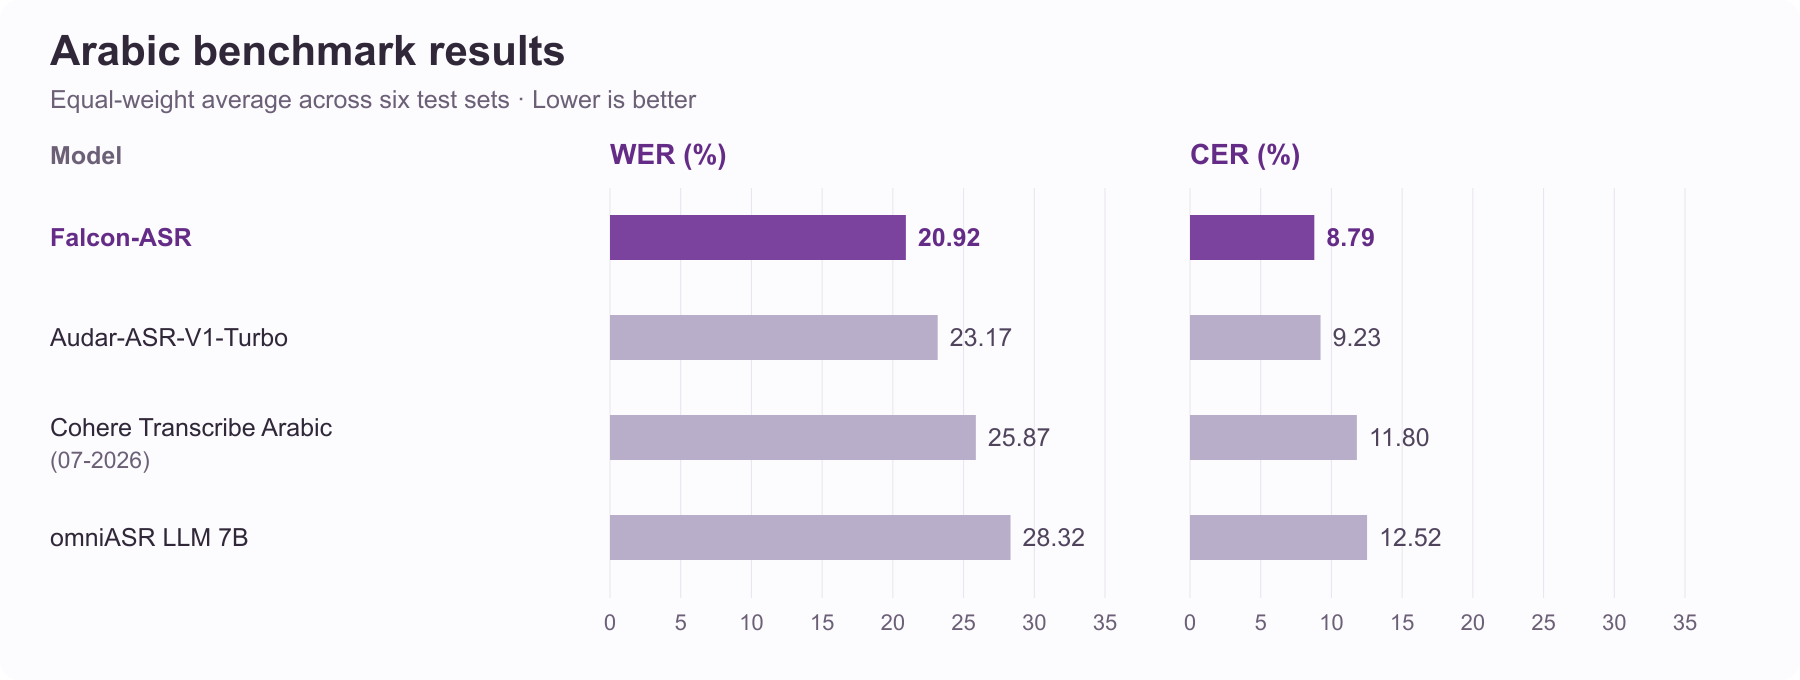
出典: Introducing Falcon ASR — Hugging Face(評価比較チャートの転載)
首長国方言・英語の評価と学習条件
- 首長国方言の内部評価: 公開データのCasablanca(UAEサブセット)に加え、TIIが用意した首長国・湾岸音声の内部評価を実施。人手検証の参照テキストで測り、WER 22.73%・CER 10.19%を記録したという
- 比較結果: 比較対象の中ではWER・CERとも最低で、次点のQwen3-OmniよりWERで4.07ポイント低いと報告している。公開UAEサブセット外の held-out 録音を含む内部評価であり、公開ベンチマークと同列には扱えない点に注意が必要だ
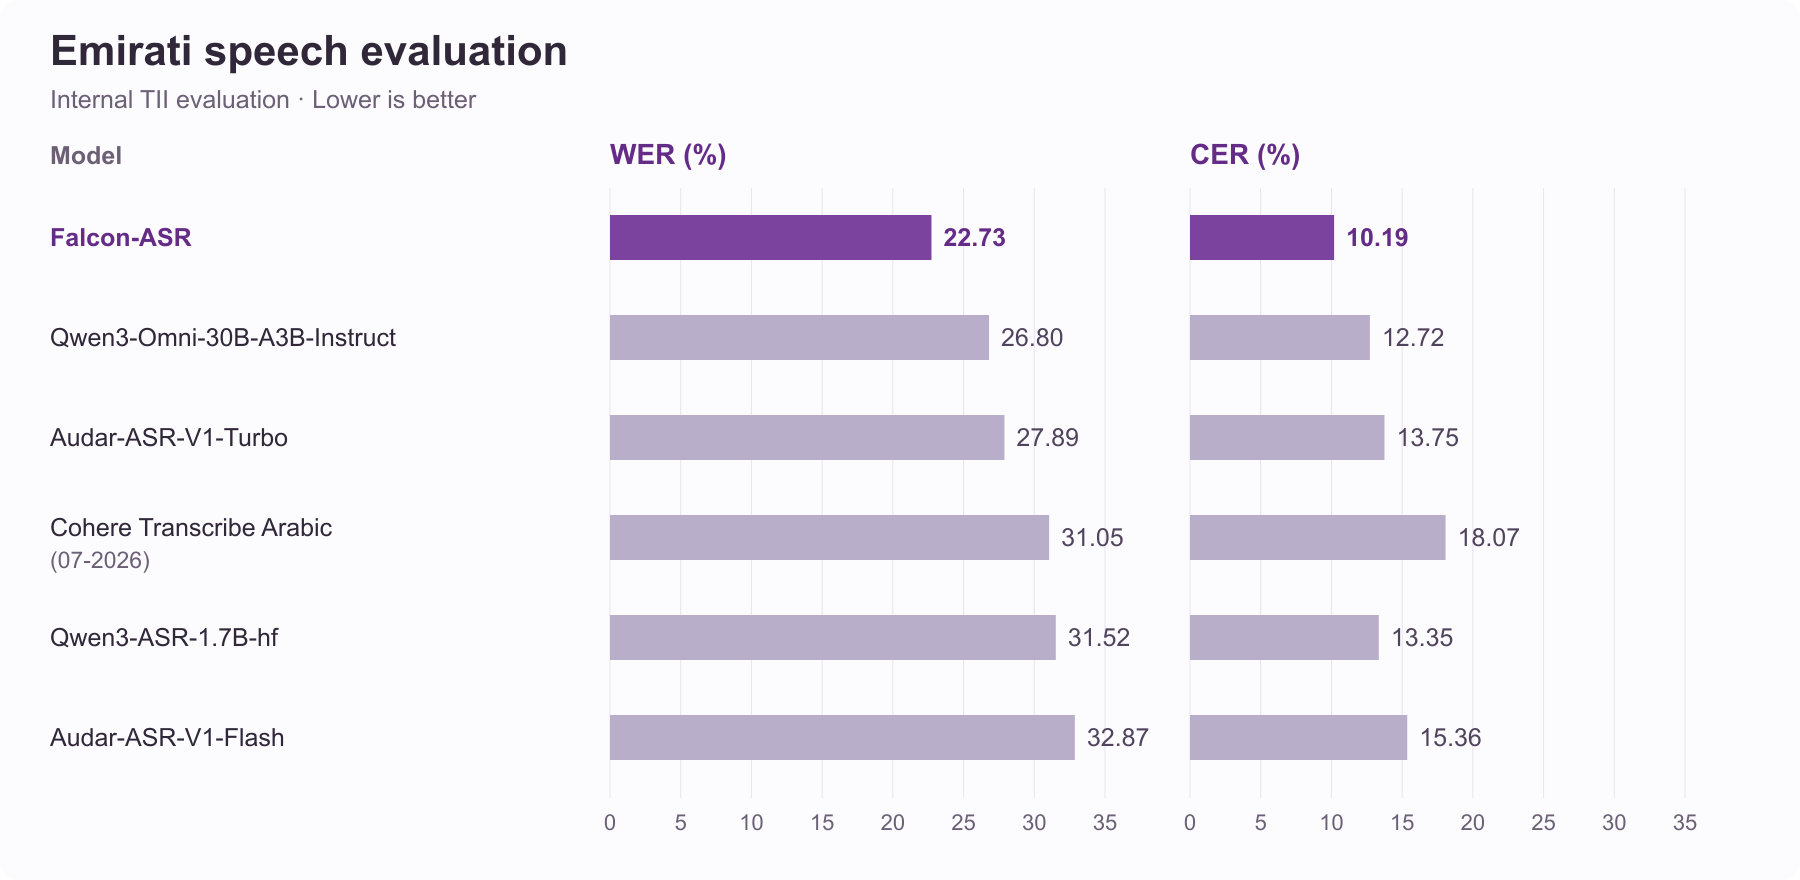
出典: Introducing Falcon ASR — Hugging Face(評価比較チャートの転載)
- 英語評価: Hugging Face Open ASR Leaderboardで使われる7種の公開英語試験で平均WER 5.74%と報告している
- 録音条件への頑健化: 背景雑音・重なり発話・音楽・残響・電話品質の効果、速度やピッチの変動を学習に含めた。首長国録音にも同様の処理を適用し、会議や通話など日常の録音条件への耐性を狙ったという
- 方言データの背景: 方言アラビア語はMSAより書き起こし資源が少なく、地域・話者・録音環境で変動が大きいことが課題として挙げられている
