

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
TIIが首長国方言特化モデル「Falcon-Emirati-7B」を公開 — 自前のAlyahベンチマークで84.83%
UAEのTechnology Innovation InstituteがFalcon-H1-Arabicを首長国(エミラーティ)方言に特化させたFalcon-Emirati-7Bを2026年10月6日に発表した。母語話者が収集した1,173問のAlyahベンチマークで84.83%を取り、比較対象の多言語・アラビア語モデルを上回ったと報告している。
UAEのTechnology Innovation Institute(TII)のチームは2026年10月6日、アラビア語の首長国(エミラーティ)方言に特化した7Bモデル「Falcon-Emirati-7B」を発表した。基盤は同研究所のアラビア語モデル群Falcon-H1-Arabicで、ニュースや教科書の現代標準アラビア語(MSA)ではなく、日常会話・諺・ナバティ詩などに現れる方言とその文化的文脈の理解を目指したものだ。本稿はHugging Face上の公式ブログ発表で確認できる範囲に限定して整理する。いずれの数値もベンダー報告であり、独立した第三者検証ではない。
基盤モデルと方言適応のアプローチ
- 基盤: Falcon-H1-Arabicの7Bバリアントを出発点に採用。7Bは方言のニュアンスを保持できる規模と学習・推論コストのバランスが最良と判断し、3Bでは文化的・言語的理解の深さが不足、34Bでは方言特化チャットモデルとしてのコストが見合わないと説明している
- 基盤アーキテクチャ: Falcon-H1はState Space Model(Mamba)とTransformer注意機構を各ブロック内で並列動作させて融合するハイブリッド構成で、長い系列への線形時間効率と長距離依存の精度を両立させた設計。モデル群は3B・7B・34Bの3規模、コンテキスト窓は最大128K〜256Kトークン
- データ戦略(3系統): (1) 首長国のWebサイト・フォーラムから収集した方言そのままの実在テキスト、(2) 首長国の文化・慣習・歴史に関するMSA資料(方言の書き方ではなく話題の背景知識を教える)、(3) 首長国語彙・文法の辞書と文体規則で制約した大量の合成データ
- 適応レシピの探索: 方言データの投入量・学習段階(継続事前学習・SFT・選好最適化)の配分、実在データと合成データの比率などをアブレーションで試行錯誤し、自動スコアと母語話者レビューを併用して選定したという
評価結果の公称値(いずれもベンダー報告)
- Alyahベンチマーク: 首長国方言能力の評価用に母語話者が手作業で収集した1,173問の多肢選択ベンチマーク。日常挨拶・作法から比喩表現・遺産知識・首長国詩までをカバーする。Falcon-Emirati-7Bは84.83%で、比較したアラビア語・多言語モデルをすべて上回ったとしている。なおFalcon-H1-Arabic系は土台のため比較対象から除外されている
- 規模と方言能力の関係: 一部の大型多言語モデルは小規模で方言対応のモデルを下回り、方言 proficiency は規模の副産物ではなく意図的な学習が必要という解釈を示している
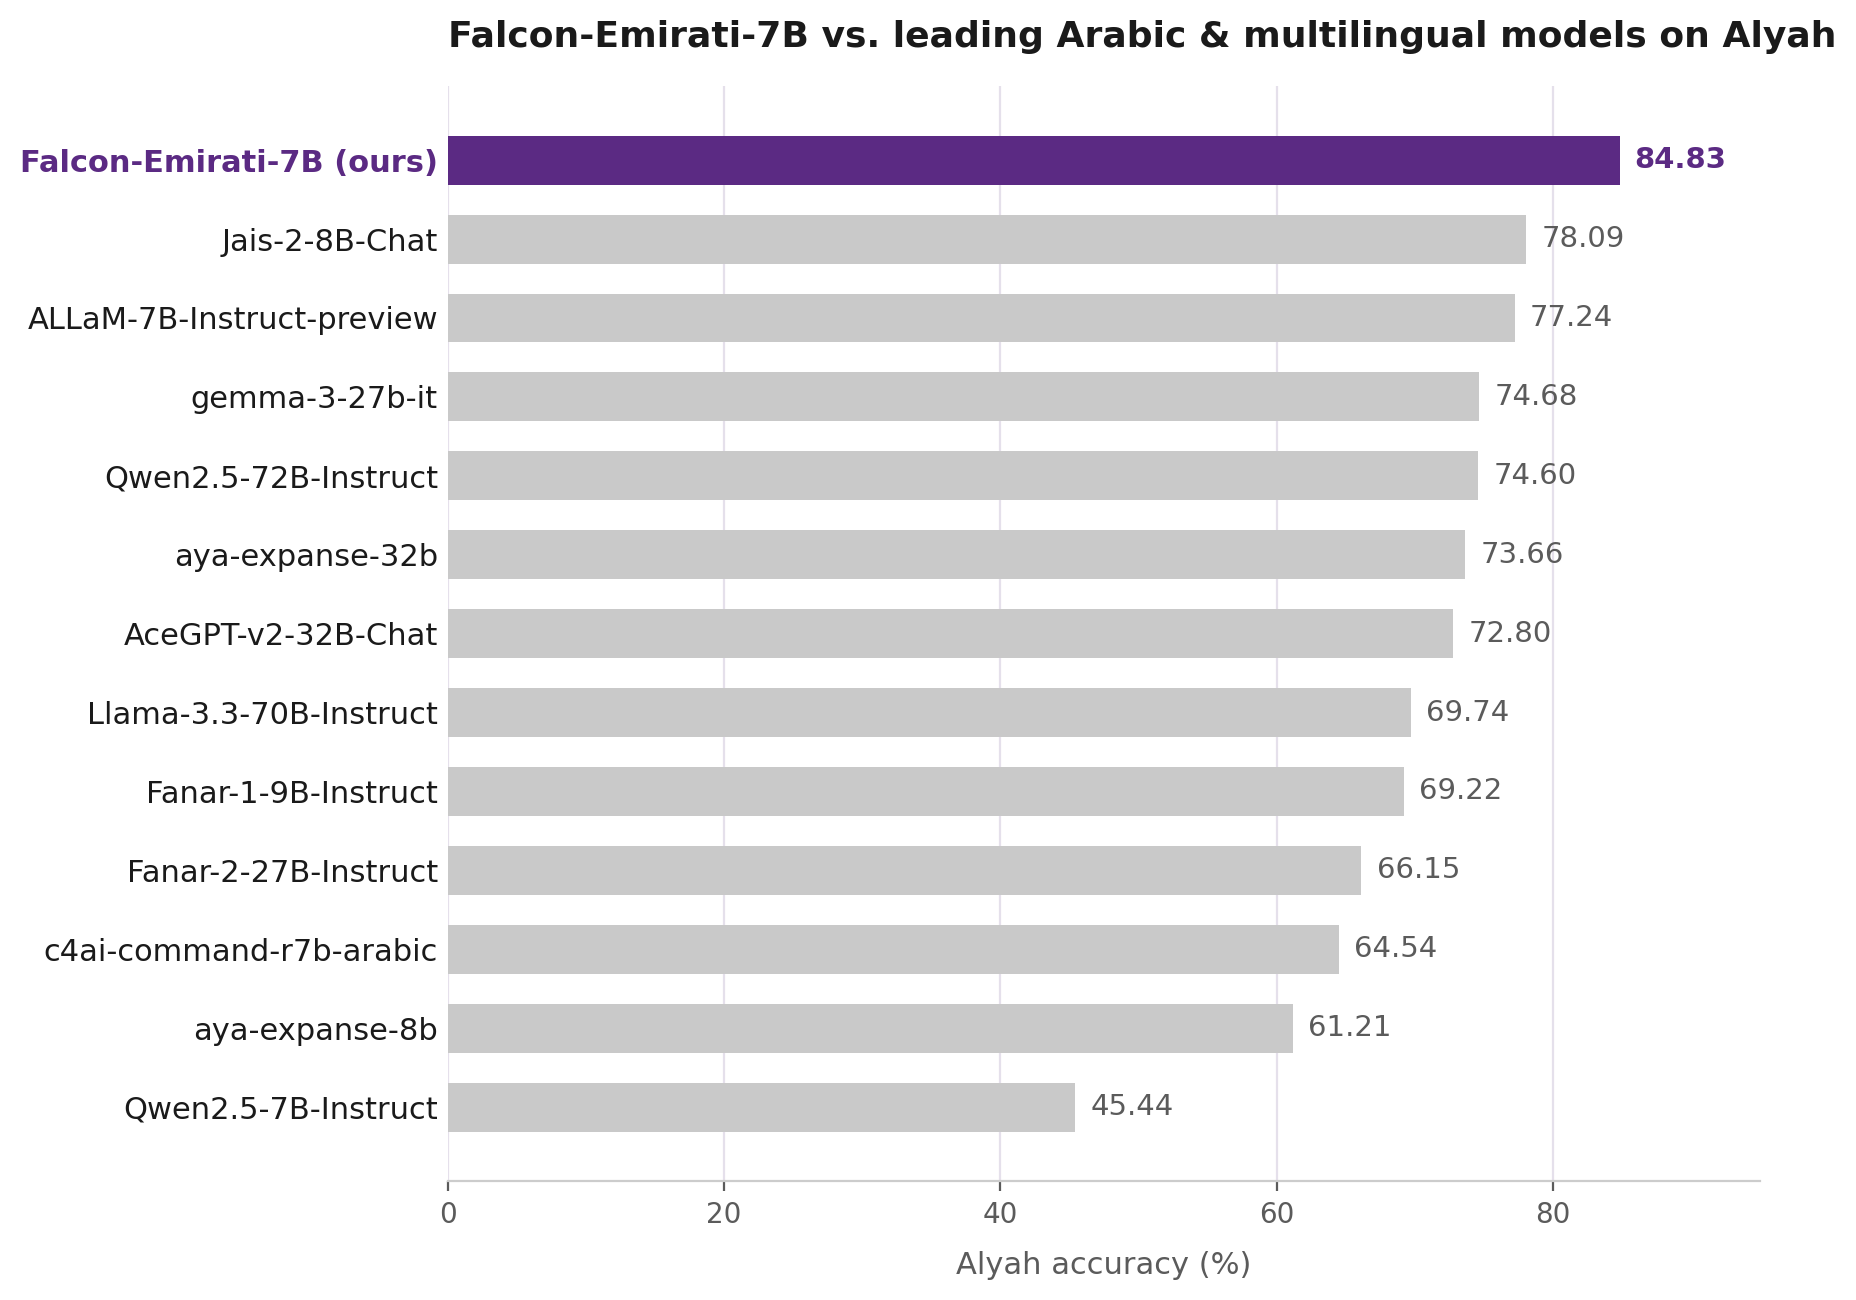
出典: Falcon-Emirati: When an LLM Learns the Dialect, the Culture, and the Nuance — Hugging Face(評価比較チャートの転載)
- LLM-as-Judge生成評価: Alyahの1,173問をオープンエンド生成で解かせ、Gemini 3.7 Flashを判定役に内容正確性と方言忠実度(MSAではなく首長国方言で答えたか)を採点。比較相手はALLaM-7B-Instruct-preview、gemma-3-27b-it、Jais-2-8B-Chat、Fanar-2-27B-Instruct
- 方言忠実度の差: 部分点スコアでFalcon-Emirati-7Bが0.52に対し、ALLaM 0.05、gemma-3-27b-it 0.03、Jais-2-8B-Chat 0.02、Fanar-2-27B-Instructはほぼ0.00。他モデルは内容を知りながらMSAで答える傾向が強いという。Fanar-2-27B-Instructは26.2%を回答拒否(他モデルは5%未満)し、正確性も0.27で最低だった
- ペアワイズ判定: カテゴリ別の直接対決でも詩・創造表現や言語・方言など方言色の強い分野でFalcon-Emirati-7Bの勝率が高く、挨拶・日常表現(MSAと重なりが大きい分野)では競合が互角以上という一貫した傾向
- 文化理解: UAE部分のArabCulture-Dialogue(283シナリオ、多肢選択)ではFalcon-Emirati-7Bが85.57%で、ALLaM-7B 83.39%、Jais-2-8B 73.79%、Fanar-2-27B 71.50%を上回ったと報告
利用形態と注意点
- 利用: Falcon-Emirati-7BはFalconのチャットプラットフォームで利用可能と案内されている。評価用データセット(tiiuae/alyah-emirati-benchmark)とArabCulture-DialogueはHugging Faceで公開されている
- 限界: 学習データのバイアスを反映しうること、稀な表現や局所的な言及では誤りやすいこと、方言・文化の正しさには母語話者でも意見が分かれる主観性があることを認め、機微・公式・高リスク用途の前に用途別の評価を推奨している
- 注意点: 本記事の性能数値はすべてTIIチーム自身の報告であり、重み公開の有無やライセンス条件は今回の発表文からは確認できない。導入判断はモデルカード等の公開後の確認が妥当