NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / NEW MODEL
TypeSafe AIが「System One Models」と初の決定モデル「Jev」を公開 — 文字列を捨て、型安全な判断を並列出力
TypeSafe AIは新しいモデルクラス「System One Models」と初の公開モデル「Jev」をアーリーアクセスで公開した。テキストを生成せず、型安全な構造化値と較正済み確率を70〜500msで並列返却する。入力0.042ドル/100万トークン、出力無料。独自ワークフロー評価の数値はベンダー公称値として扱う。
TypeSafe AIは新しいモデルクラス「System One Models」と、その初の公開モデル「Jev」をアーリーアクセスで公開した。名称はDaniel Kahnemanの『Thinking, Fast and Slow』における速い直感的な思考(System 1)に由来し、Jevの名はWilliam Stanley Jevonsにちなむ。チャット応答やコードのような文字列を生成するのではなく、ソフトウェア内部の自動判断に特化した「決定モデル」という位置づけだ。以下は同社の公式ブログで確認できる範囲の整理であり、性能の数値はすべて同社の主張として扱う。
System One Modelsとは — 文字列を捨てた決定モデル
- 入出力の形: 非構造データ(テキストなど)と構造化されたプログラム状態を入力し、事前に定義した型つきの構造化値と確率を出力する。出力後にパースや検証は不要としている
- サンプリング: トークンを逐次生成するのではなく、すべての出力を単一クエリで並列に生成する。ハードウェア効率が高い設計と説明されている
- 確信度: すべての出力に較正済みの確率と信頼度スコアを付随させる。「確信度が高いほど正答率が高い」関係を意図した設計で、確信度つきの分岐に使える
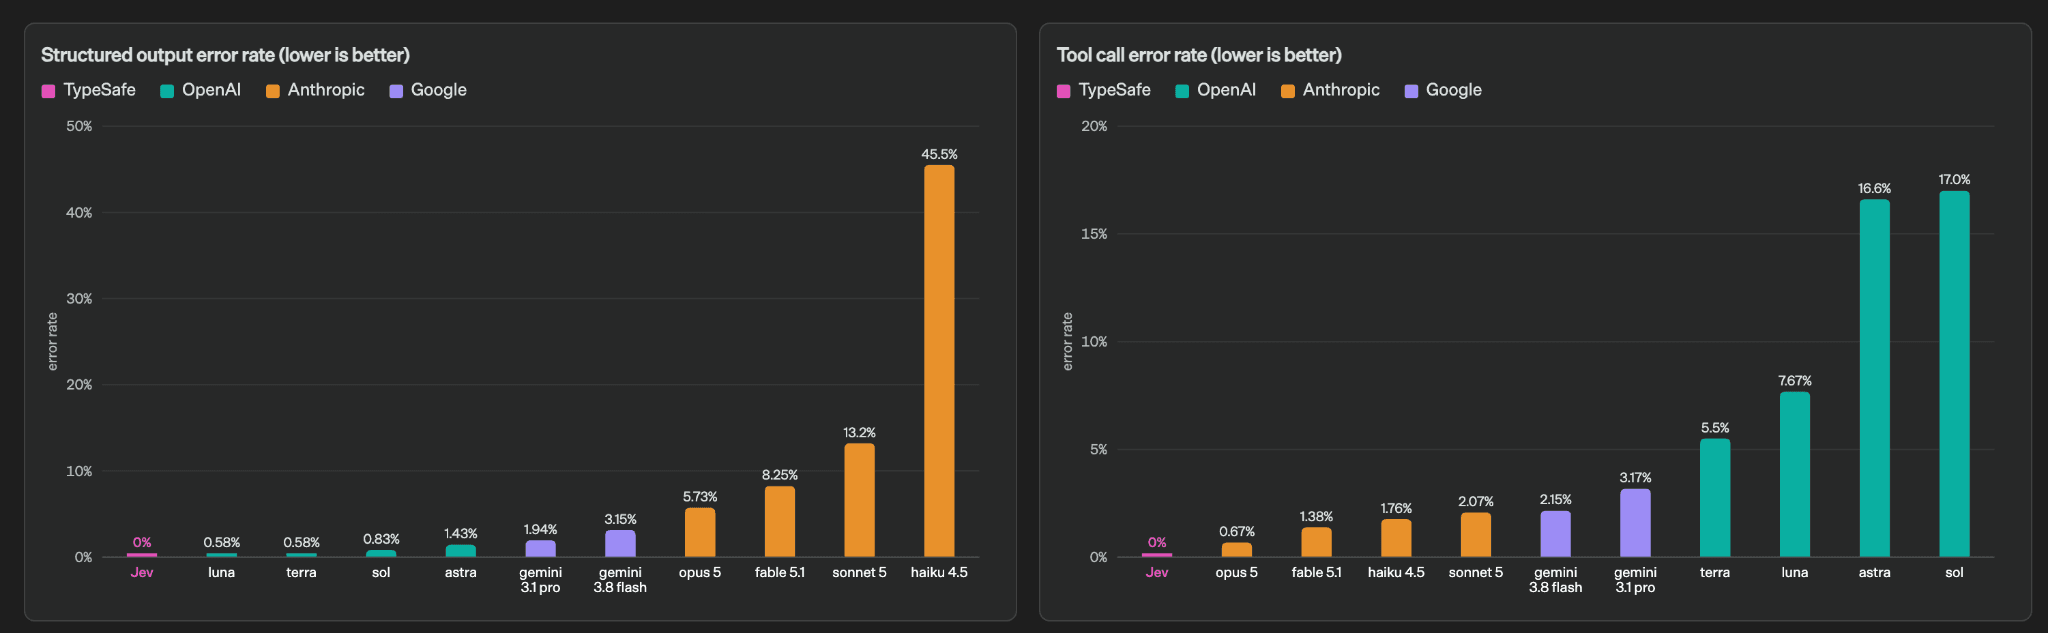
- ハルシネーション: 文字列生成をやめることで、ハルシネーションや型エラーを起こさない設計と主張している(同社の主張であり、独立した検証ではない)
- 学習: RLHFやRLVRではなく「RLCD(Reinforcement Learning for Calibrated Decisions、較正済み判断のための強化学習)」で最適化する。人間の好みや検証可能な報酬ではなく、認識的に正直な確率つき回答を目的関数に据えた点が違いとされる
- 用途: AIワークフロー内のファジーな分岐(分類・ルーティング・採点・抽出)、大規模データのmap-reduce、100ms級の応答が要るリアルタイム用途、LLM出力の検証・ガードレールなど
料金と速度 — 公称値の整理
- 料金: 入力トークンは0.042ドル/100万トークン(10億トークンあたり42ドル)。出力トークンは「計測するほど安くない」として無料
- 速度: エンドツーエンドの応答時間は70ms〜500msとしている。同程度のフロンティア級の知能をもつモデル比で40〜200倍高速という主張
- 比較表の前提: 同社は既存LLMの応答時間を3〜329秒(外部ベンチマークサイトの値へのリンクつき)と置き、人間相手には十分速いがコードに組み込むには律速になると説明している
- 注意: 上の倍率・料金の持続可能性について、同社自身が「長期で証明する必要がある」「評価は西海岸のノートPCから実行」といった限定条件を開示している。本記事では公称値として扱い、独立評価とは区別する
独自のワークフロー評価 — Pareto frontierの主張と限定条件
出典: Introducing System One Models & Jev - TypeSafe AI Blog
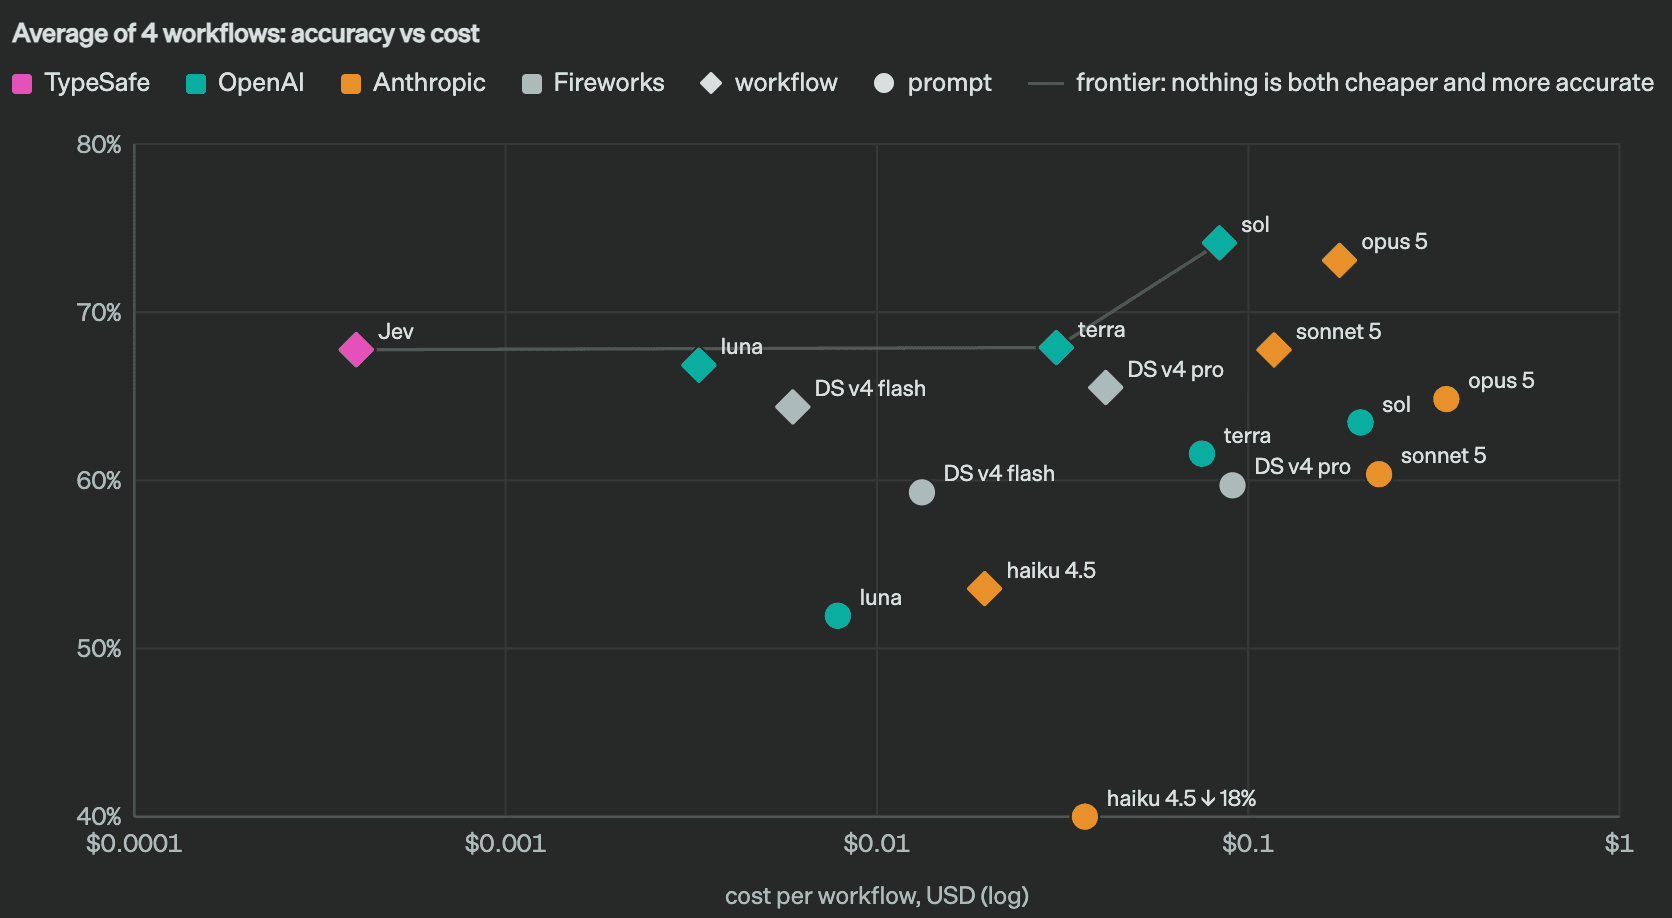
- 評価の作り方: 正解ラベルへの適合ではなく、正しい計算グラフ(コードで表されたワークフロー)を仮定し、外部の最大・最賢・最高価モデルの予測平均(GPT-6 AstraとFable 5.1の平均)との一致度を測る。全モデルが同一ワークフローで比較される
- 主張: 4つのワークフローでJevがほぼ2桁の範囲でPareto frontierを取るとしている。ホームページの「193.6倍高速・444.6倍安い」という数値の出所もこの評価で、同社自身「実世界の利得としては高めの側の数字」と注記している
- バイアスの開示: ワークフローは同社のモデル能力チームの作で訓練分布外とはしているが偏りの可能性を認めている。参照答えがOpenAIとAnthropicのモデルの平均のため、同社モデルとDeepSeek系には不利方向の偏りがあるとも記している
- 公開ベンチマークなし: 公開ベンチマークでの性能は意図的に出さない方針で、「公開ベンチマークに重みを置かない」「自分の用途の評価を作る」ことを推奨している。ベンチマークで先行していても強調しない立場としている
- 詳細: 全ワークフローの例・不一致・クエリ全文は同社の評価サイト(evals.typesafe.ai)で公開されている
出典: Introducing System One Models & Jev - TypeSafe AI Blog
デモと提供形態 — 注意点つきで読む
- Side-by-sideデモ: JevとGPT-5.6 Terra(既定のreasoning設定)の比較デモを公開している。クエリは簡略化され、入力が短めで同社に有利な条件と自ら注記している
- Doom・Wikiracing: 構造化されたゲーム状態に対する毎秒10クエリ級のリアルタイム判断(Doom)や、高分岐のリンク選択(Wikiracing)のデモを動画で公開している。Jevの選択肢の上限は255としている
- 提供: アーリーアクセスとして順次招待し、どこで機能しどこで不足するかのフィードバックを求めている
- データ: 訓練データは自作で、ユーザーデータでは訓練しないとしている