

NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / RESEARCH
LLMのブロック剪定をIsing最適化問題として解く — Multiverse ComputingがHugging Faceで解説、50%圧縮でMMLU約23ポイント差
Multiverse Computingは2026年9月21日、LLMのブロック除去を制約付き二値最適化(Ising glass)として定式化する手法をHugging Faceブログで解説した。Llama-3.3-70Bの50%圧縮で既存の最良手法にMMLUで約23ポイント差をつけたとする。コードはGitHubで公開されている。
Multiverse Computing(Antonio Tiene、Ali Hashemi、David Jansen、Roman Rausch)は2026年9月21日、大規模言語モデルのブロック除去(depth pruning)を制約付き二値最適化として定式化し、Ising spin glassとして解く手法をHugging Faceブログで解説した。対象論文は「LLM Compression by Block Removal with Constrained Binary Optimization」で、コードはGitHubで公開されている。以下は同ブログで確認できる範囲の整理であり、性能の数値は同記事の報告として扱う。
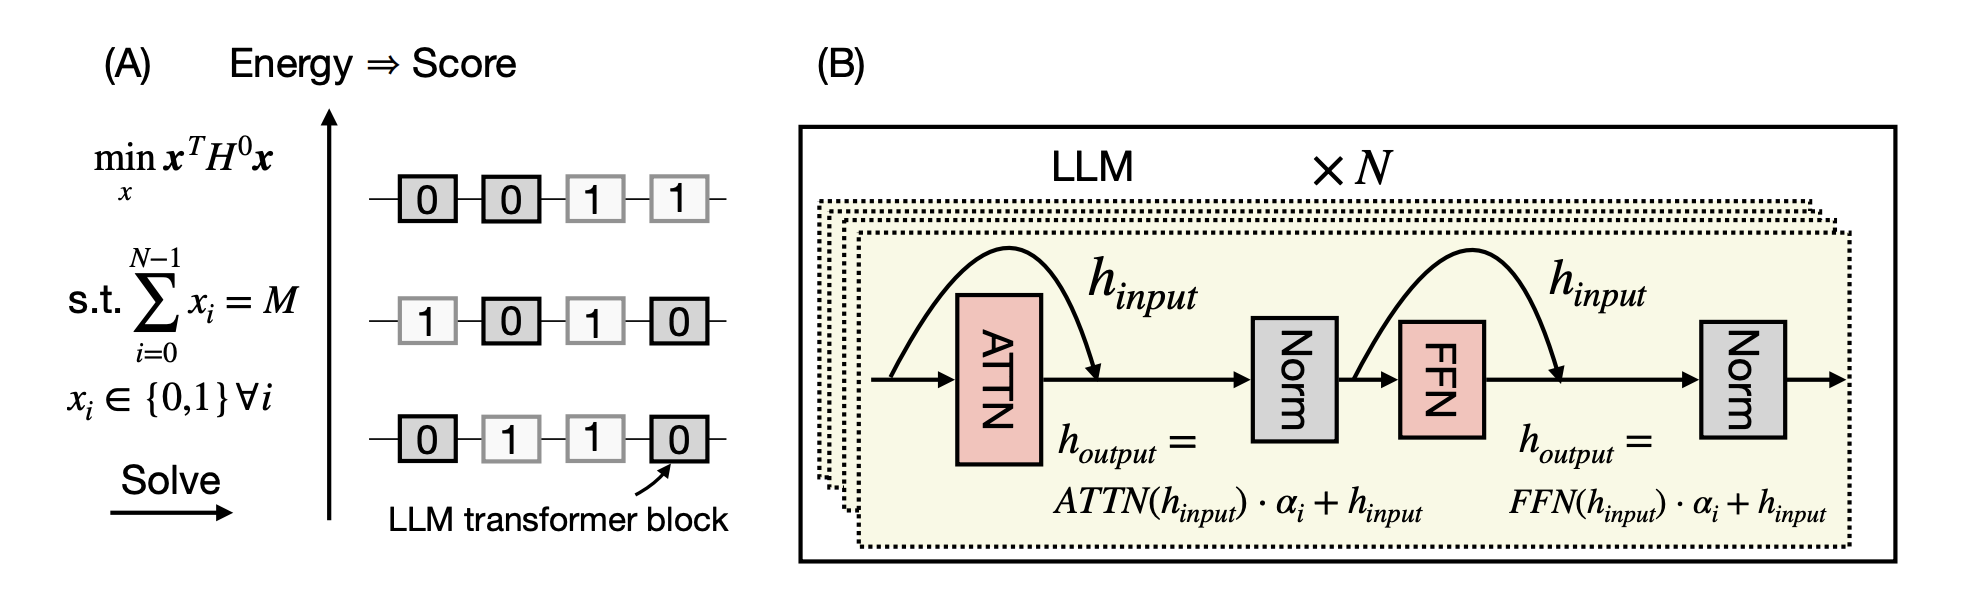
出典: Pruning LLMs Like a Physicist: Block Removal as an Ising Optimization Problem
発想 — ブロック選択をエネルギー最小化にする
- 問題設定: 各Transformerブロックに二値変数(0=保持、1=除去)を割り当て、N個中ちょうどM個を除去する組合せを選ぶ
- 定式化: 損失を二値変数について二次までTaylor展開し、Hessian行列を得る。対角成分が各ブロック単独の重要度、非対角成分がブロック間の結合(相互作用)に対応する
- 物理対応: この最適化はIsing glass(全結合スピン系で磁化=除去数を固定)に対応する。スピン系の低エネルギー状態が、剪定後モデルの高ベンチマーク得点に対応する関係が成立するとしている
- 既存手法との差: 各ブロックを独立に採点して削る手法は、物理の言葉では平均場近似にあたり、ブロック間の結合を捨てている。連続した一塊だけを削る方式は探索空間を大きく捨てている。深く削るほど結合の無視が響くと説明されている
- コスト: Hessianは小規模な較正データでの順伝播・逆伝播から一度だけ計算する。以降の候補評価は安価なエネルギー計算で済み、モデル実行やベンチマークは不要になる。Hessianは圧縮率Mによらず再利用できる
求解 — 厳密に解ける範囲とsolverの使い分け
- 厳密解: エネルギー計算が安いため、単一GPUで数百億構成までの全探索が可能としている。Llama-3.3-70Bの80ブロック中8個除去(約290億通り)で約2日を要した例が挙げられている
- solver: それを超える規模ではQUBO形に直し、量子アニーリング・QAOA・tabu search・分枝限定などの既存solverに渡す。オープンソースのtabu solverが検証可能な範囲で最低エネルギー状態に数秒で到達したとしている
- 基底状態は不要: 真の基底状態を見つける必要はなく、低エネルギーの良状態を数個速く得られれば十分という立場を取っている
- 励起状態の活用: エネルギーは品質の強い代理指標だが完全ではないため、最低エネルギー状態が最良モデルとは限らない。Hamiltonianが決まれば基底状態と低励起状態の読み出しはほぼ無料で、複数の高品質候補が得られる点を利点としている
- 具体例: Llama-3.1-8Bで16/32ブロック除去時、17番目の励起状態が初めて冒頭付近のブロック除去を提案し、軽い再訓練後に複数ベンチマークで基底状態を上回った。「最良の剪定は中後段の一塊」という通念への反証と位置づけている
結果 — 深い圧縮ほど差が開く報告
- 対象: Llama-3.1-8B-Instruct、Qwen3-14B、Llama-3.3-70B-Instructで既存の最先端ブロック除去ベースラインと比較している
- 深圧縮での差: Llama-3.3-70B-Instructの再訓練なし評価で、24/80除去までは同等だが、32/80と40/80で大きく引き離したとする。40/80(50%深度)では同手法がMMLUで77近辺を維持し、最強のベースラインは50台半ばに落ち、約23ポイントの差になったと報告している
- Qwen3-14B: 12/40除去でMMLUに約10ポイントの差をつけたとしている。軽い圧縮では同等で、深く切るほど結合の考慮が効くという説明と整合的としている
- 異種アーキテクチャ: Mamba2・attention・MoEを不均一に混ぜたNVIDIA-Nemotron-3-Nano-30B-A3B-FP8にも再訓練なしで適用し、MoE層2〜3層またはattention層2層の除去でAIME25とGPQAにおいてblock influenceを上回る構成を見つけたとしている。最良構成が励起状態だった点も共通していた
- 位置づけ: 量子化・低ランク/SVD圧縮・幅剪定・蒸留ベースの修復と組み合わせ可能で、 larger pipelineの一部として使う想定としている
限界と確認事項
- 数値の扱い: 上の性能差は同記事・同論文の報告であり、本サイトで独立に検証したものではない
- 再現: 手法の詳細(Taylor展開の導出、QUBO写像、solver比較、較正データのablation、全結果表)は論文全文とGitHubのコードを参照されたい
- 企業バイアス: 著者はMultiverse Computing所属で、solver技術は同社の領域と自ら記している。量子関連solverの有効性の主張は同社の立場を含むものとして読む必要がある