

NAW / PRODUCTS 03
IMAGE: AI生成ビジュアル
PRODUCTS / DEV TOOLS
Transformersがllama.cpp量子化(GGUF)を直接実行可能に — Apple Siliconでllama.cppに迫る速度
Hugging Faceは2026年9月22日、TransformersでGGUFチェックポイントを直接読み込み・実行できる対応を公開した。ggmlカーネルをkernels経由で再利用し、Qwen3.5系から対応。MacBook Pro M2 Maxでの測定では3種の量子化モデルでllama.cppに近い生成速度としている。
Hugging Faceは2026年9月22日、深層学習ライブラリTransformersでllama.cppの量子化フォーマットGGUFのチェックポイントを直接読み込み・実行できる対応を公開した。ローカル推論の定番であるllama.cppの資産(OllamaやLM Studio、Janなどに使われる量子化済みモデル)を、Python・PyTorchのTransformersワークフローの中でそのまま扱えるようにするものだ。以下は同記事で確認できる範囲の整理であり、速度の数値は同記事の主張として扱う。
何ができるか — GGUFの読み込みと提供方法
- 読み込み: Hub上のリポジトリIDとファイル名を
from_pretrained(model_id, gguf_file=filename)に渡すだけで読み込める。例としてunsloth/Qwen3.5-4B-GGUFのQwen3.5-4B-Q4_K_M.ggufが挙げられている - GGUFとは: llama.cppチームが開発した形式で、重みとメタデータ(トークナイザ情報やチャットテンプレートを含む)を1ファイルにまとめる。
Q4_K_Mなどの量子化バリアントで精度とメモリを交換できる - サイズ感: UnslothのQwen3.5-4BではBF16が8.42GB、Q6_Kが3.53GB、Q5_K_Mが3.14GB、Q4_K_Mが2.74GB。記事は
Q4_K_Mからの開始を推奨している - 配信:
transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"でOpenAI互換APIとして提供でき、JanやPiなどのクライアントから接続できる - 用途: PyTorchでの実験・中間活性の観察、既存評価ワークフローでの量子化モデルの品質測定、GGUF変換の妥当性検証、デコード手法の試作、逆量子化してのファインチューン(
GgufConfig(dequantize=True))が挙げられている - 位置づけ: 記事は「効率的なローカル推論が目的ならllama.cppが引き続き推奨」と明記している。今回の統合は開発者向けの利便性が目的だ
速度の工夫 — ggmlカーネル再利用とgenerate改善
- カーネル: ggmlのMetalカーネルを
kernelsライブラリ経由で配布・利用する。量子化重みの読み取り(ggml-quantization)、正規化融合(ggml-norm)、フラッシュアテンション(ggml-attn)、Qwen3.5/3.8系の線形注意層向け(ggml-gated-delta-net)に、MoEのエキスパート選択用に独自実装のtopkを組み合わせる - generate改善: カーネル以外の生成ループ側も手当てし、これはGGUFに限らず全Transformersモデルに効くとしている。具体的には不要なアテンションマスクの早期除去(PR #48814)と、停止判定の非同期化(PR #47975)でCPUとGPUの重なりを改善した
- llama.cpp比較(同記事の測定): MacBook Pro M2 Max・32GB統合メモリ・macOS 26.6・PyTorch 2.12.1・kernels 0.17.0で、128トークン生成の速度を3種のチェックポイントで比較。Qwen3.5-4B(Q4_K_M)でTransformers 70.4 tok/sに対しllama.cpp 71.8±0.4、Qwen3.8-27B(UD-Q4_K_M)で15.9に対し13.4±0.9、Qwen3.5-35B-A3BのMoE(UD-IQ4_XS)で60.2に対し61.3±0.5としている
- 条件の違いに注意: Transformers側はプリフィルを含む
generateの最良値、llama.cpp側はデコードのみのllama-bench(tg128)の平均値と、測定条件は同一ではない。記事自身も「同一条件を示唆しない」と断っているため、数値は参考範囲として扱われたい
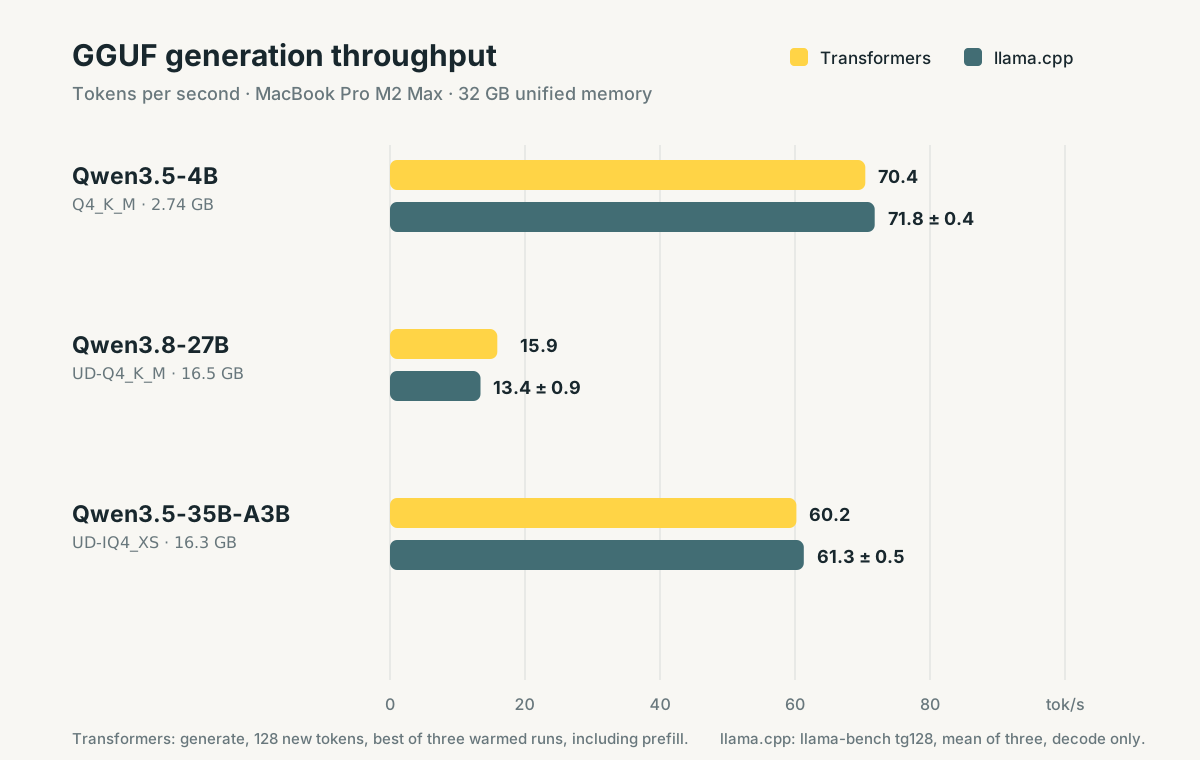
出典・画像提供: Transformers now runs llama.cpp quants — Hugging Face Blog(測定条件: MacBook Pro M2 Max・32GB、Transformersはプリフィル含む・llama.cppはデコードのみ)
制約と今後 — MPS限定・対応アーキテクチャは拡張予定
- MPS限定: パックされた重みのまま推論する高速パスは当面Apple Silicon(MPS)のみ。他デバイスでは逆量子化して読み込む従来方式になる
- バッチ: パディングなし入力向けの最適化が中心で、パディング付きバッチは性能が落ちる場合がある。MPSでの
generate_batch拡張が課題とされている - 対応範囲: パックローダーが扱うのは現時点でQwen3.5のdense・MoEアーキテクチャと互換性のあるQwen3.8チェックポイント。他アーキテクチャは比較的素直に追加できるとして段階的に対応予定で、使いたいGGUFモデルがあればissueでの要望を求めている
- 要件: Apple Silicon Mac、対応PyTorch(通常は最新2リリース)、最新Transformers(次回リリースまではmainブランチ)と互換性のある
kernelsが必要。対応カーネルが取得できない場合は警告の上でsdpaにフォールバックする - 先の狙い: llama.cpp未対応の新アーキテクチャや研究モデルにもggmlの性能を持ち込むこと、さらにテキスト生成以外(視覚・音声・マルチモーダル)への応用も視野に入れている。ただし各アーキテクチャには個別の統合と検証が必要としている
