

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
Xiaomi MiMoが「MiMo-V2.6」シリーズを公開・オープンソース化 — ProがAA知能指数46点、RLの全工程も再現可能に
XiaomiのMiMoチームは2026年9月22日、大規模強化学習で鍛えた「MiMo-V2.6」シリーズ(Pro / Flash / Distill-Qwen-9B)をオープンソースとして公開した。ベンダー発表によればProはArtificial Analysis Intelligence Indexで46点を獲得し、Kimi K3やQwen3.8 Maxを上回る公開モデル最上位としている。技術レポート・学習環境・RLコードも同時公開され、第三者が再現・検証できる構成になっている。
XiaomiのMiMoチームは2026年9月22日、公式ドキュメントのニュース欄で**「MiMo-V2.6」シリーズの正式リリースとオープンソース化**を発表した。検証可能な複雑タスクを土台に強化学習(RL)の計算量を拡張し、反復的な探索とフィードバックで知能の境界を広げる「再帰的自己改善(RSI)」路線の一歩と位置づけている。重みはHugging Faceの公式コレクションで公開済みである。
シリーズ構成 — Pro / Flash / Distill-Qwen-9Bの3モデル
- 2つのネイティブ・フルマルチモーダルモデル: シリーズの中核は Pro と Flash。コード・汎用・視覚・サイバーなど複数分野のマルチタスク訓練体系で学習されている。
- Hugging Faceでの公開実態(HF APIで確認): コレクション
XiaomiMiMo/mimo-v26に3リポジトリが登録され、2026年9月21日付で更新されている。MiMo-V2.6-Pro-RL(約524Bパラメータ)、MiMo-V2.6-Flash-RL(約159Bパラメータ)、MiMo-V2.6-Distill-Qwen-9B(約9.4Bパラメータ、image-text-to-text)。 - 蒸留モデル:
Distill-Qwen-9BはRL軌跡からの蒸留モデルで、SFTベースラインに対する改善が11ベンチマーク全体で確認されたとしている(ベンダー発表)。 - API: V2.5シリーズと同一価格を維持。ProにはOpen Platform上で最大20倍の推論速度をうたう UltraSpeedモード が用意されている。
性能の主張 — AA指数46点とエージェント系ベンチマーク
- Artificial Analysis Intelligence Index: ベンダー発表によれば MiMo-V2.6-Proは46点 を獲得し、Kimi K3とQwen3.8 Maxを上回って「現時点で最強のオープンソースモデル」としている。一方、最強のクローズドモデルであるClaude Fable 5.1とGPT-6 Astraとは依然ギャップがあることも明記している(いずれもベンダー公称値であり、独立評価ではない)。
- エージェント系ベンチマーク: 大規模マルチタスクRLの結果、Proは大半のエージェントベンチマークで Claude Opus 5やGPT-5.6 Solに匹敵 し、FlashはMiMo-V2.5-Proを全面的に上回ったとしている(ベンダー発表)。
- 分布外汎化の指標: 長距離ソフトウェア工学の評価基準 DeepSWE v1.1 で、Flashは約48.8→65.7(約17点改善)、Proは約58.4→72.6(約14点改善)としている(ベンダー発表)。
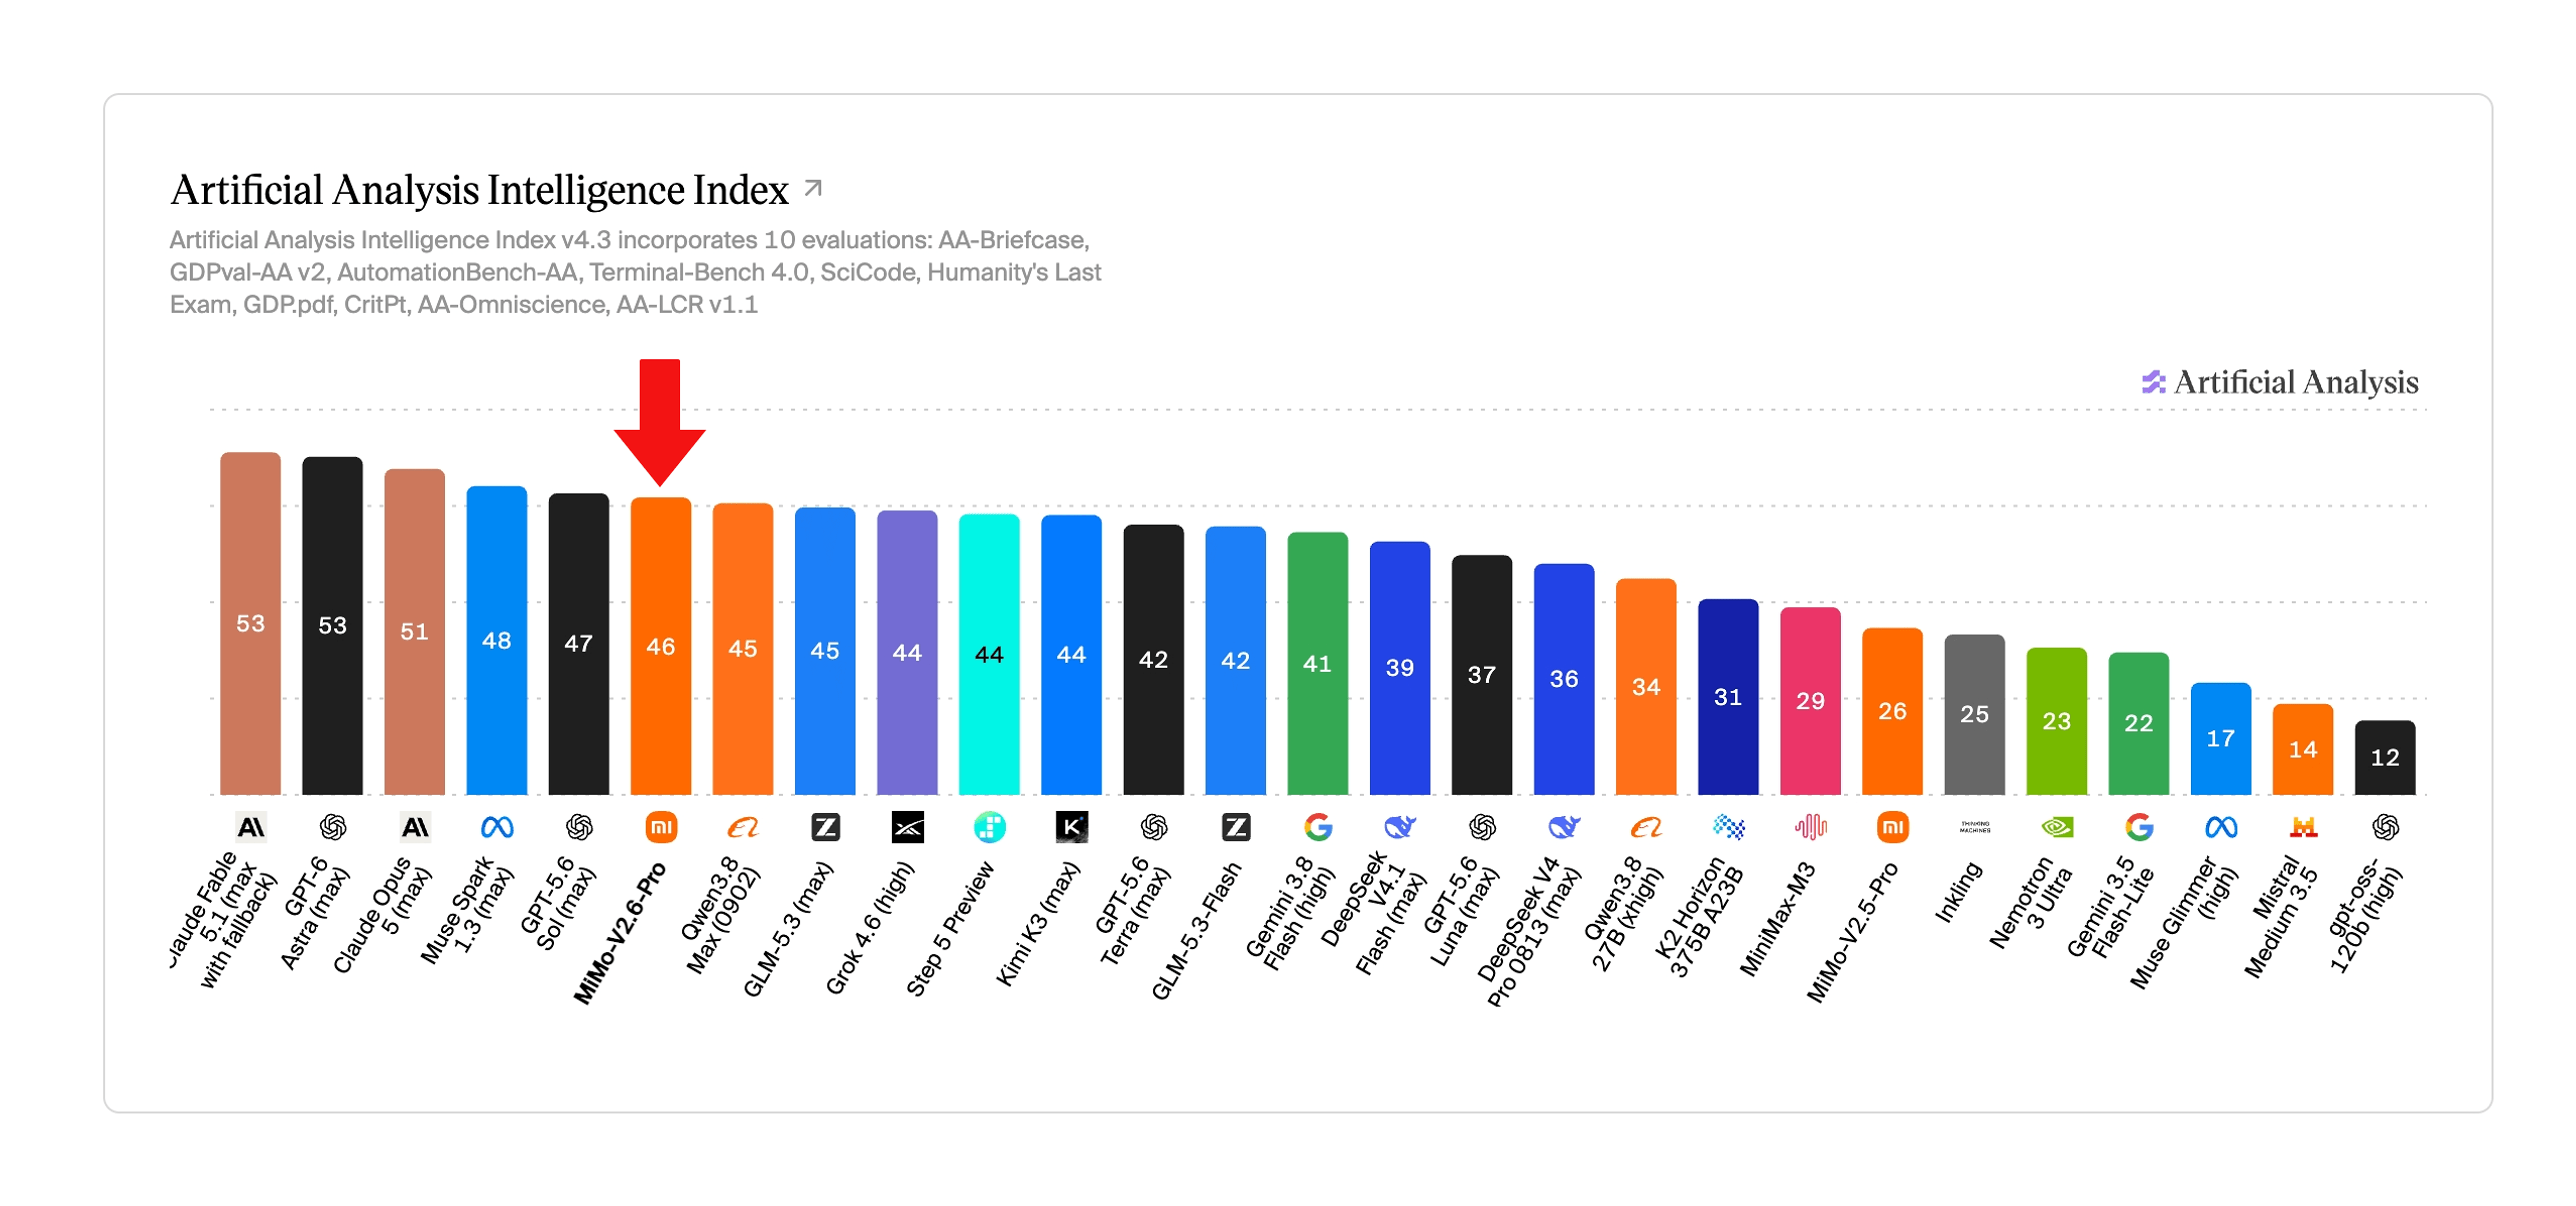
出典: MiMo-V2.6: Scaling Up Reinforcement Learning for Self-Improvement — Xiaomi MiMo
RL訓練の中身 — 6日間の公開訓練と再現用リソース
- 公開Live訓練: FlashとProはそれぞれ30ステップ、累計約75万trajectoryを6日弱で実行。訓練費用はFlash約85万ドル、Pro約262万ドルと開示されている。
- スケール拡張の3軸: (1) 大バッチ・完全非同期(更新あたり1,568サンプル、1Mコンテキスト、ステップあたり3.5〜3.7Bトークン)、(2) 多タスク・複雑環境(複数Harness統合)、(3) Grader計算量の拡充(Group内相対比較による報酬信号)。
- 安定化の工夫: MoEルーターの凍結によるエキスパート負荷ドリフト抑制、報酬設計・敵対的評価・異常検知・検証器の相互検証を含むReward Hacking対策、マルチエージェントRL向けの統一trajectory表現とペナルティ機構。
- 再現性の確保: 技術レポート全文、訓練環境、RLコード、システムプロンプト・ツール・コンテキスト管理を分離したミニマルなmini-harnessをオープンソース化し、第三者が再現・検証できる形にしている。
- 応用機能: 3D空間推論・マルチモーダル知覚・コンピュータ操作(CUA)を統合し、3Dオープンワールドゲーム生成、Blenderでの3Dモデリング、具身シミュレーション環境での多視点カメラ入力による制御、デザイン評価のDesign Arena(ProがClaude Opus 5・GPT-5.6 Sol級と主張)などを挙げている。
