NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / Research
Google DeepMindらが「Dream-RSI」を公開 — 履歴を“夢”の世界に変え、エージェントの探索政策を自己改善
探索の履歴(discovery tree)をそのまま再生シミュレータ化し、代替の探索政策を数千候補・実行コストゼロで“夢”の中で評価。8課題で固定探索を上回り、Lassoでは最大162倍の呼び出し削減を報告。
Google、Google DeepMind、メリーランド大学カレッジパーク校、バージニア大学の研究チームは2026年、技術レポート**「Dream-RSI: Recursive Self-Improvement through Evolving Worlds(進化する世界による再帰的自己改善)」**を公式プロジェクトページで公開した。エージェントの探索履歴を「夢を見るための世界」に変え、探索政策そのものをオフラインで改善し続ける手法で、アルゴリズム開発・数理最適化・GPUカーネル開発の8課題で固定探索に対する効率改善を報告している。
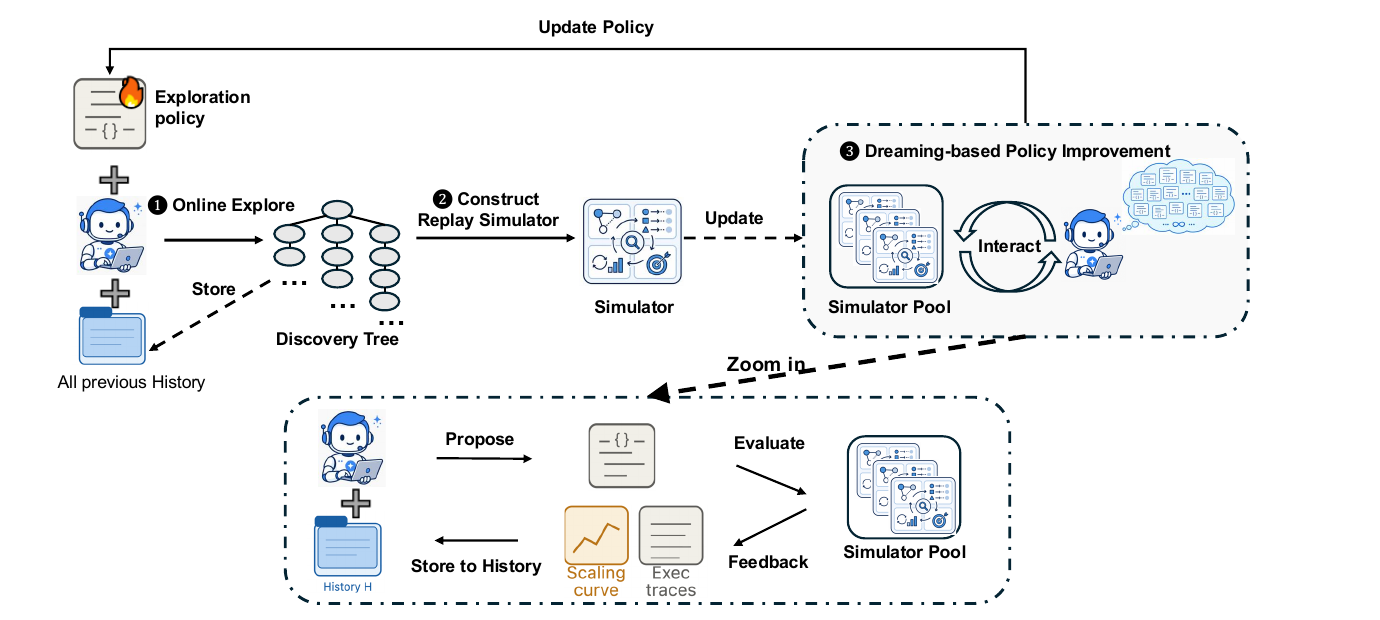 出典: Dream-RSI · Recursive Self-Improvement through Evolving Worlds
発想 — 履歴はすでにシミュレータである
- 再帰的自己改善のボトルネックは、どこを分岐・並列・打ち切るかという「探索(exploration)」の政策であり、依然として人手で書かれた固定物のままだと問題提起する
- 終了した探索実行は単なるテキストではなく、実行結果を伴う探索決定の構造化された木(discovery tree)であり、代替政策は同じ木を別の順序でたどるだけで評価できる
- 結果はすべて記録済みのため、数千の候補政策をゼロ実行コストでスクリーニングし、勝者だけを本物のオンライン展開に回す
- 従来研究が履歴をプロンプト用コンテキストやファインチューン用データとして読んでいたのに対し、木として読めば「近似ではない厳密な」シミュレータになると主張する
- 限界も明示されている。夢が見られるのは履歴が到達した探索空間の範囲内だけで、だからこそ一度きりではなくループ(再帰)にする必要がある
仕組み — 探索・保存・夢・更新のループ
- Explore(探索): 現行政策がコーディングエージェントを導き、発見木を拡張して実行トレースを記録する
- Store(保存): その木が再利用可能なシミュレータプールになる。オンライン展開のコストはここでのみ支払う
- Dream(夢): 政策開発エージェントが探索政策の改訂版を書き、履歴全体に対するリプレイで採点する。候補集合に現行政策を含むため、出荷版のスコアが置き換え前より悪化しない設計だ
- Update(更新): 勝った政策をオンラインに再展開し、新しい発見木を記録してプールを拡大する。より多くの世界で夢を見た政策は、単一実行の運に適合した政策を上回り、到達できなかった世界を持ち帰る
- 基盤のコーディングエージェント自体は変えず、探索を明示的・プログラム可能にする軽量なオーケストレーション層として実装する
評価 — 3領域・8課題での報告値
- 比較対象はRecursive Fixed Explorationで、エージェント・評価器・初期条件・ラウンド毎予算を同一にし、探索政策だけを固定した統制ベースライン。初回ラウンドは同一政策から始める
- GPUカーネル開発(KernelBench系4課題): VGG16とLayerNormでは同等性能に到達するまでの生成数が2.43倍・1.79倍少なく、ConvDivとConvMaxでは同等予算で2.09倍・1.44倍高い性能と報告
- アルゴリズム開発(Lasso正則化パス): SimpleTESに対する発見エージェント呼び出し数が最大162倍少なく、固定探索に対しては1.7倍削減と報告
- 数理最適化: Sum DiffやCircle Packingで最良値を更新しつつ、SimpleTESの51,200生成に対し1,000未満の生成で達成したとしている
- いずれもベンダー(報告者)公称値であり、独立した再現・第三者評価はこれからだ。数値の解釈には評価プロトコルや予算定義の違いに留意が必要である