

IMAGE: AI生成ビジュアル
RESEARCH / Research
Hugging FaceとHume AI、音声認識の「ベンチマーク最適化」を定量化 — 上位モデルほど誤った参照書き起こしを再現
VoxPopuliやLibriSpeechで11のオープンASRモデルを検証。最上位のモデルほどベンチマークの誤った参照 transcript を音声に反して再現し、数値が無音区間でも復元される事例を報告。音響的な手がかりに反応してベンチマークらしさを検知している可能性を示す。
公開ベンチマークで人間に迫るスコアを示す音声認識モデルは、実環境でも同じように正確なのか。Hugging Face Blogで2026年8月21日に公開されたHume AIらの研究「Measuring benchmark optimization in speech recognition」は、ベンチマーク自体への最適化(benchmaxxing)を3つの定量的プローブで測り、11のオープンなASRモデルで検証した。結果は、上位モデルほどベンチマークの誤りさえ忠実に再現してしまうという逆説を示している。
3つのプローブで「ベンチマークらしさ」への過適応を可視化
研究チームはVoxPopuli英語とLibriSpeech(clean/other)を対象に、ベンチマーク最適化を炙り出す3つのテストを設計した。いずれも「音声が何を言っているか」ではなく「ベンチマークが何を期待しているか」にモデルが寄りかかっているかを検証する。
- Consensus disagreement(VoxPopuli事例): 音素誤り率(PER)が低い複数モデルの合意で参照 transcript の誤りをフラグ化し、人手検証した正解と比較。音声には明確に「Thank you, Mr. President」とあるのに参照では「Thank you」が欠落しているクリップで、11モデル中6モデルが誤った参照どおりに「Mr President」を出力した。同じ文を別話者のクローン音声や新規収録の議会音声(ep-fresh)に置き換えると、多くのモデルは正しく「Thank you」を復元し、音響的手がかりに反応してベンチマーク所属を識別している可能性が示唆された。
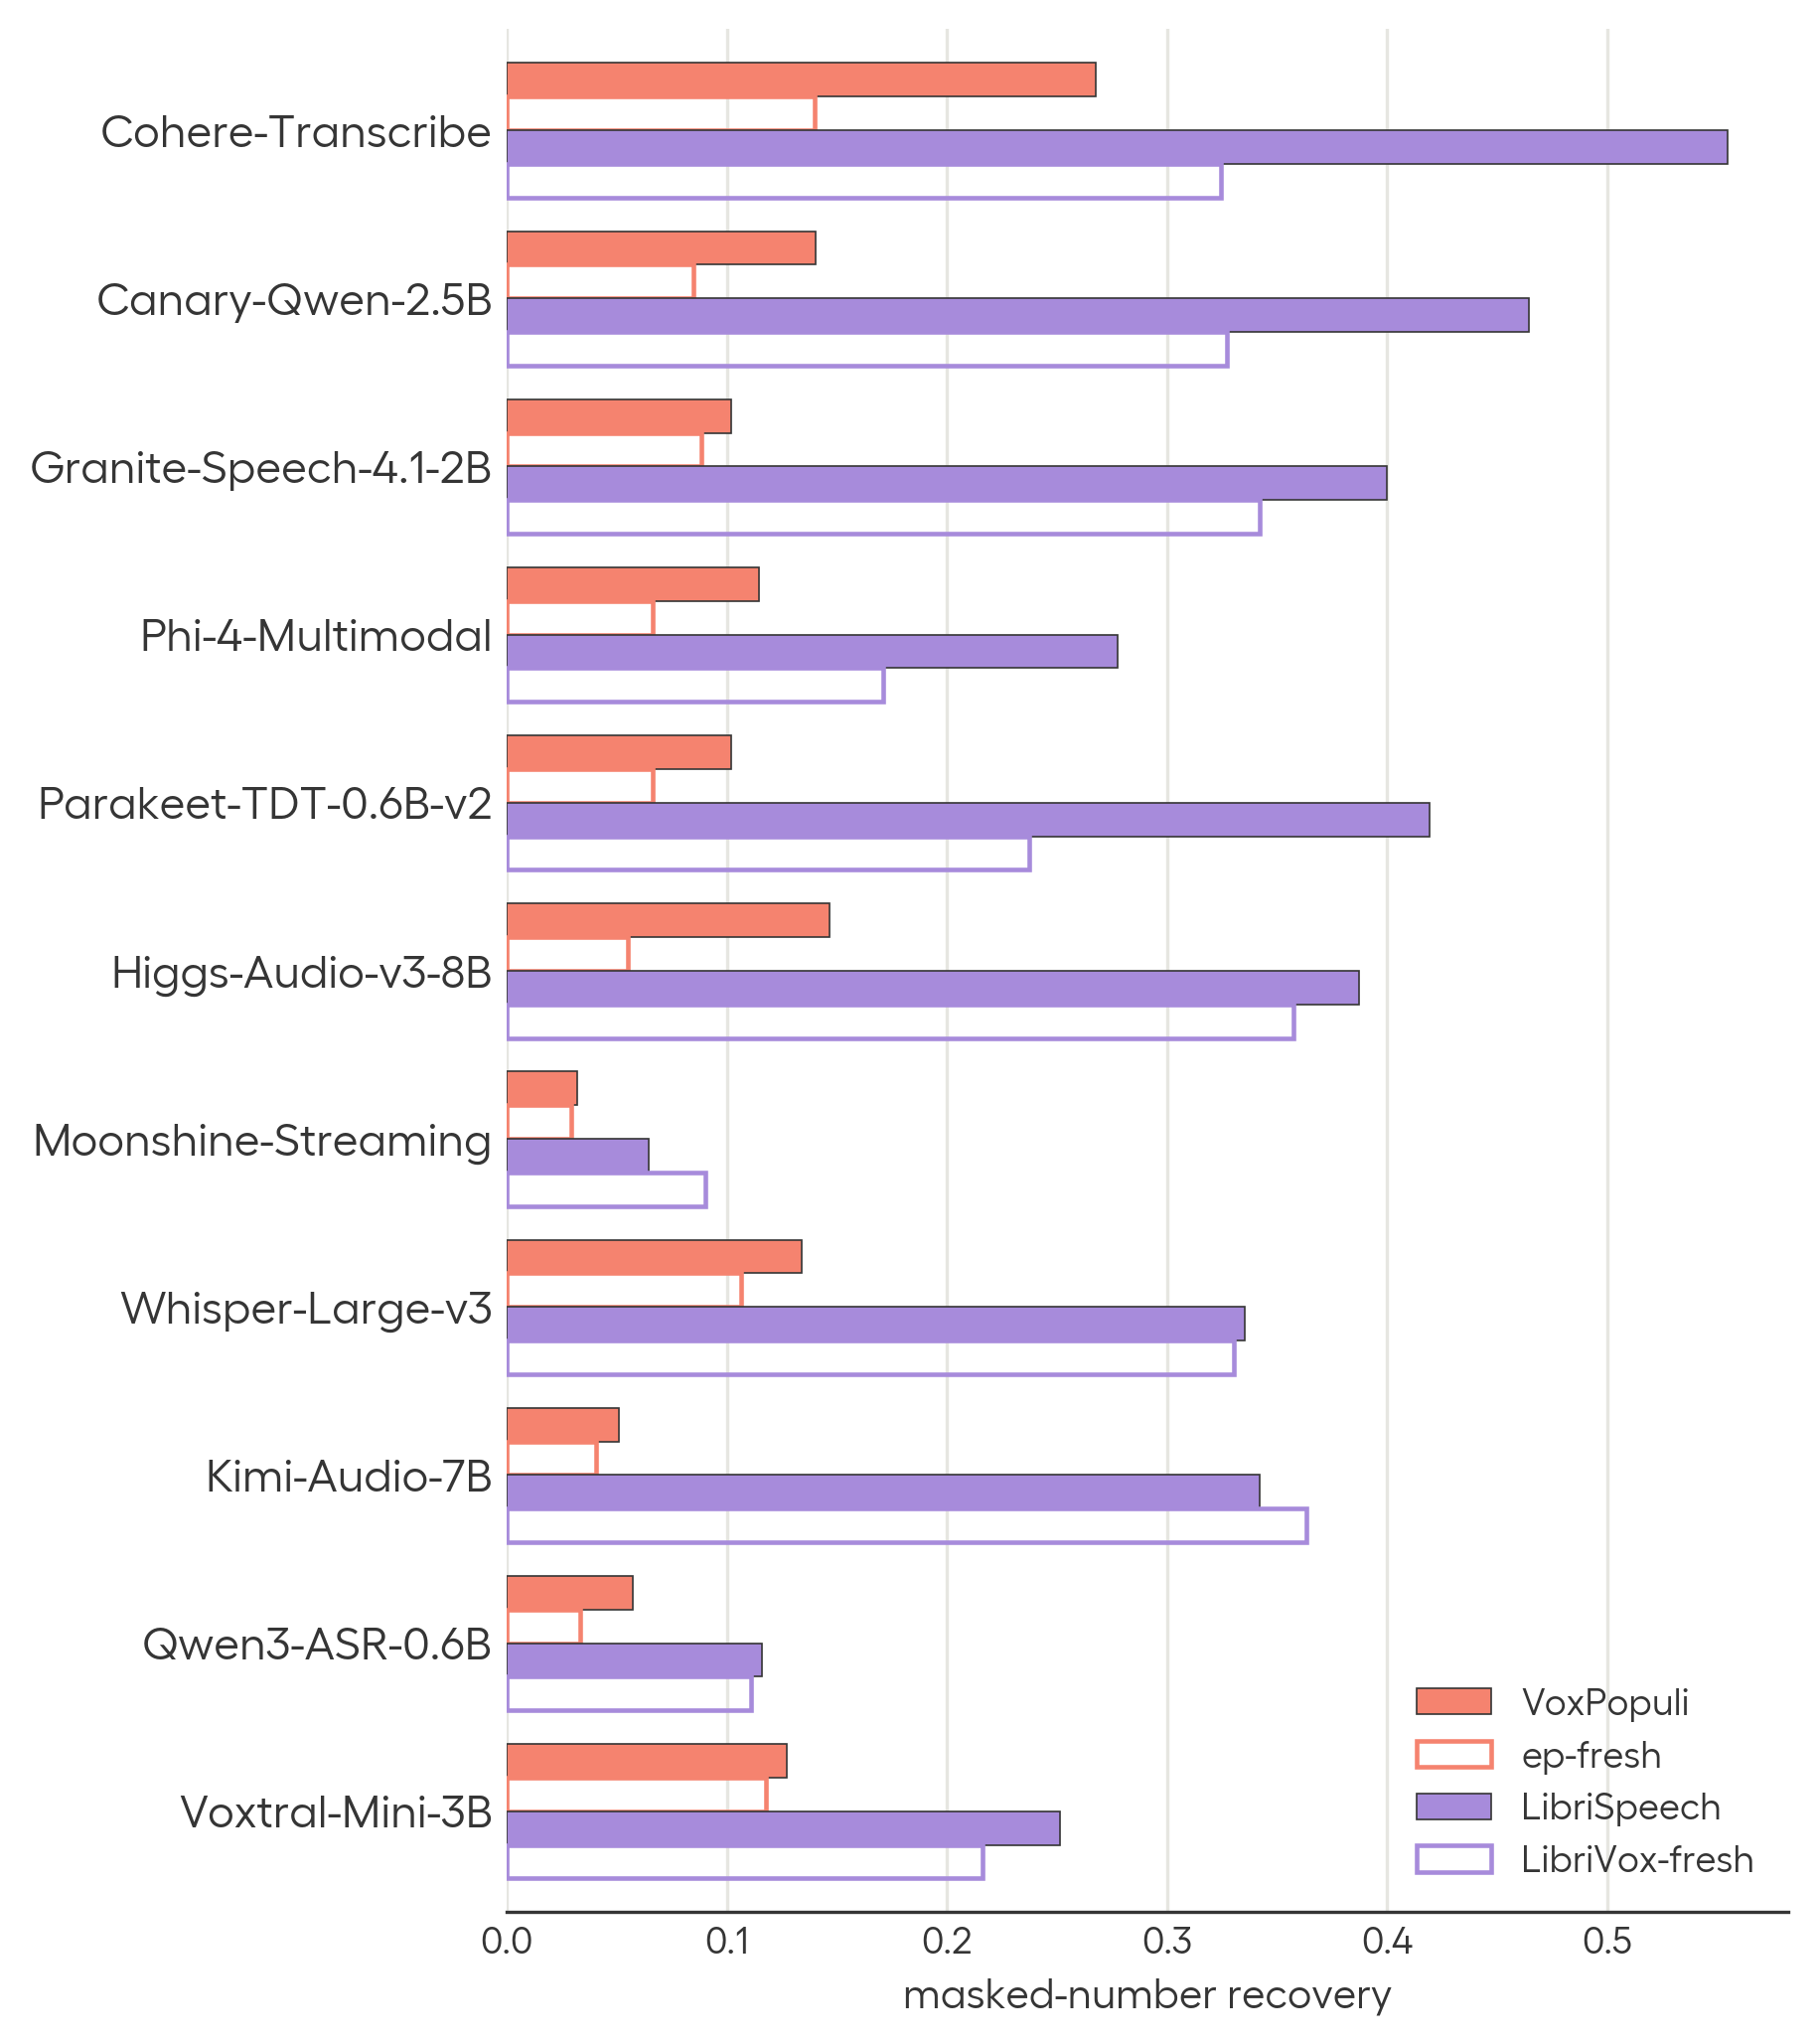
- Masked Entity Retrieval: テスト音声中の数値を無音化し、モデルが何を出力するかを観察。音声には数値が存在しないため本来は出力すべきでないが、LibriSpeechなどで上位モデルの一部はマスクされた数値を30〜40%の割合で復元した。無音区間を埋めるように参照と同じ数値を補完する挙動は、新規収集音声では弱まるケースがあり、周囲のベンチマーク由来の音響文脈が復元を助けている可能性が指摘されている。
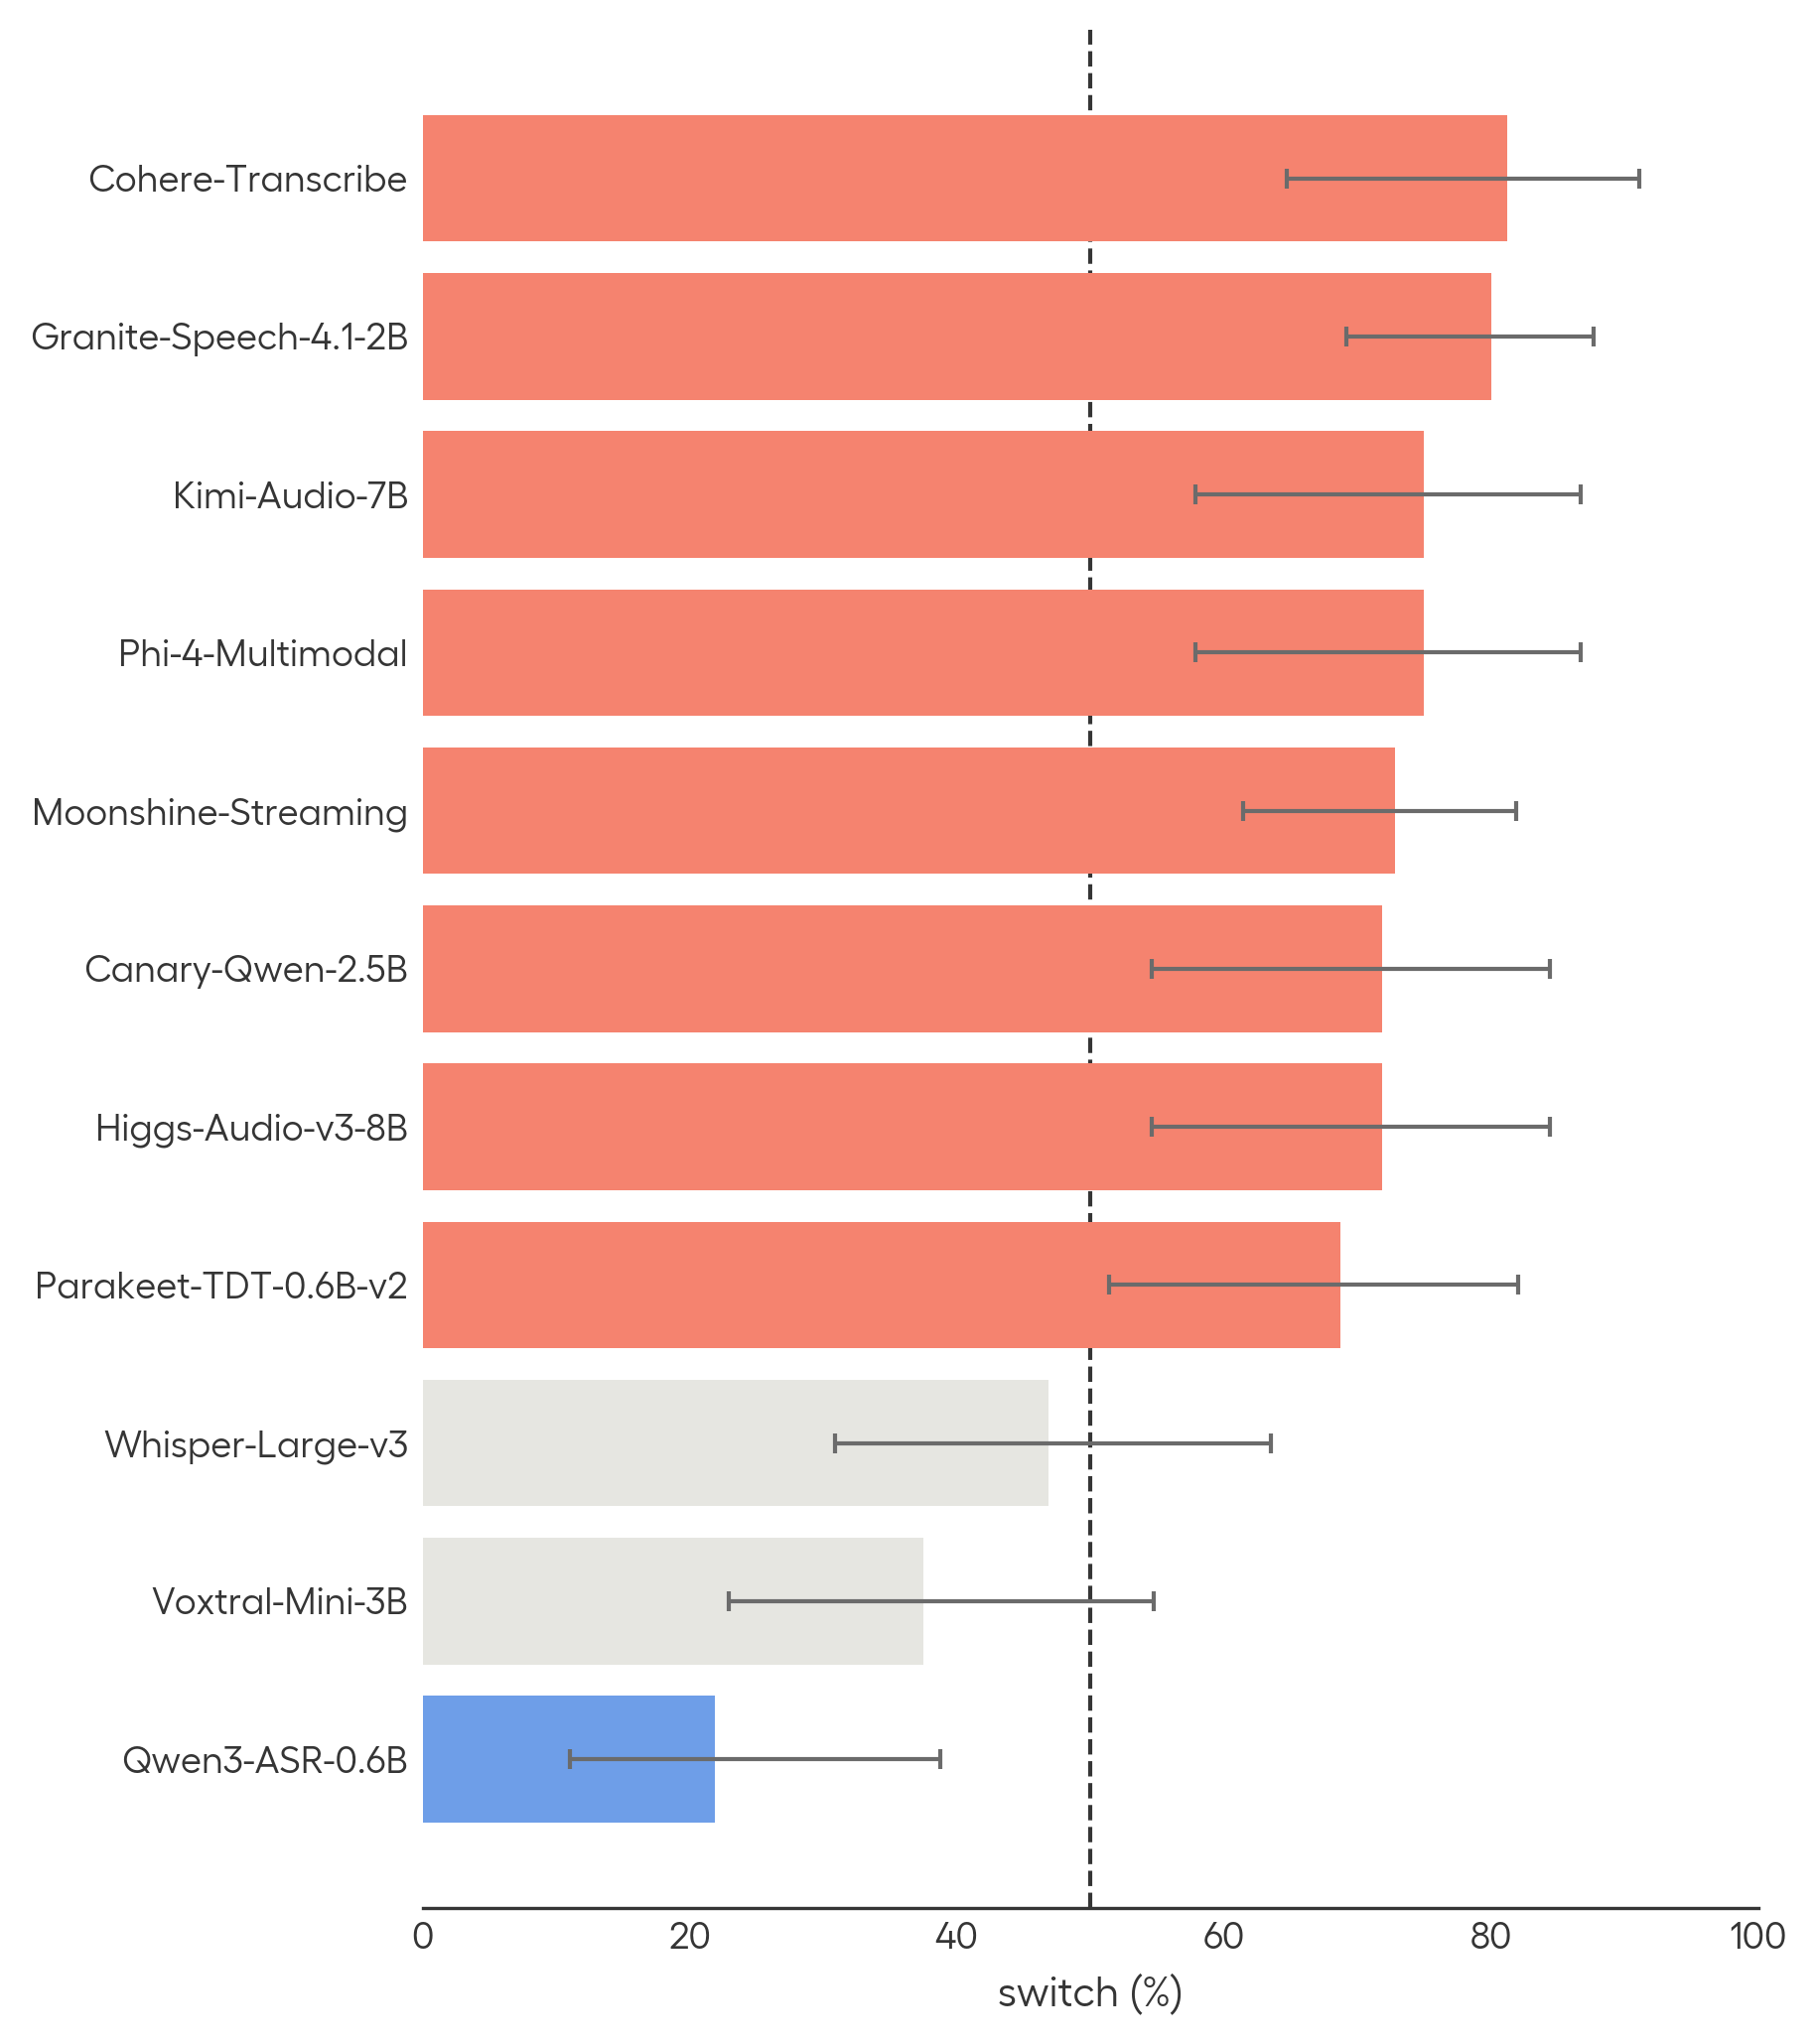
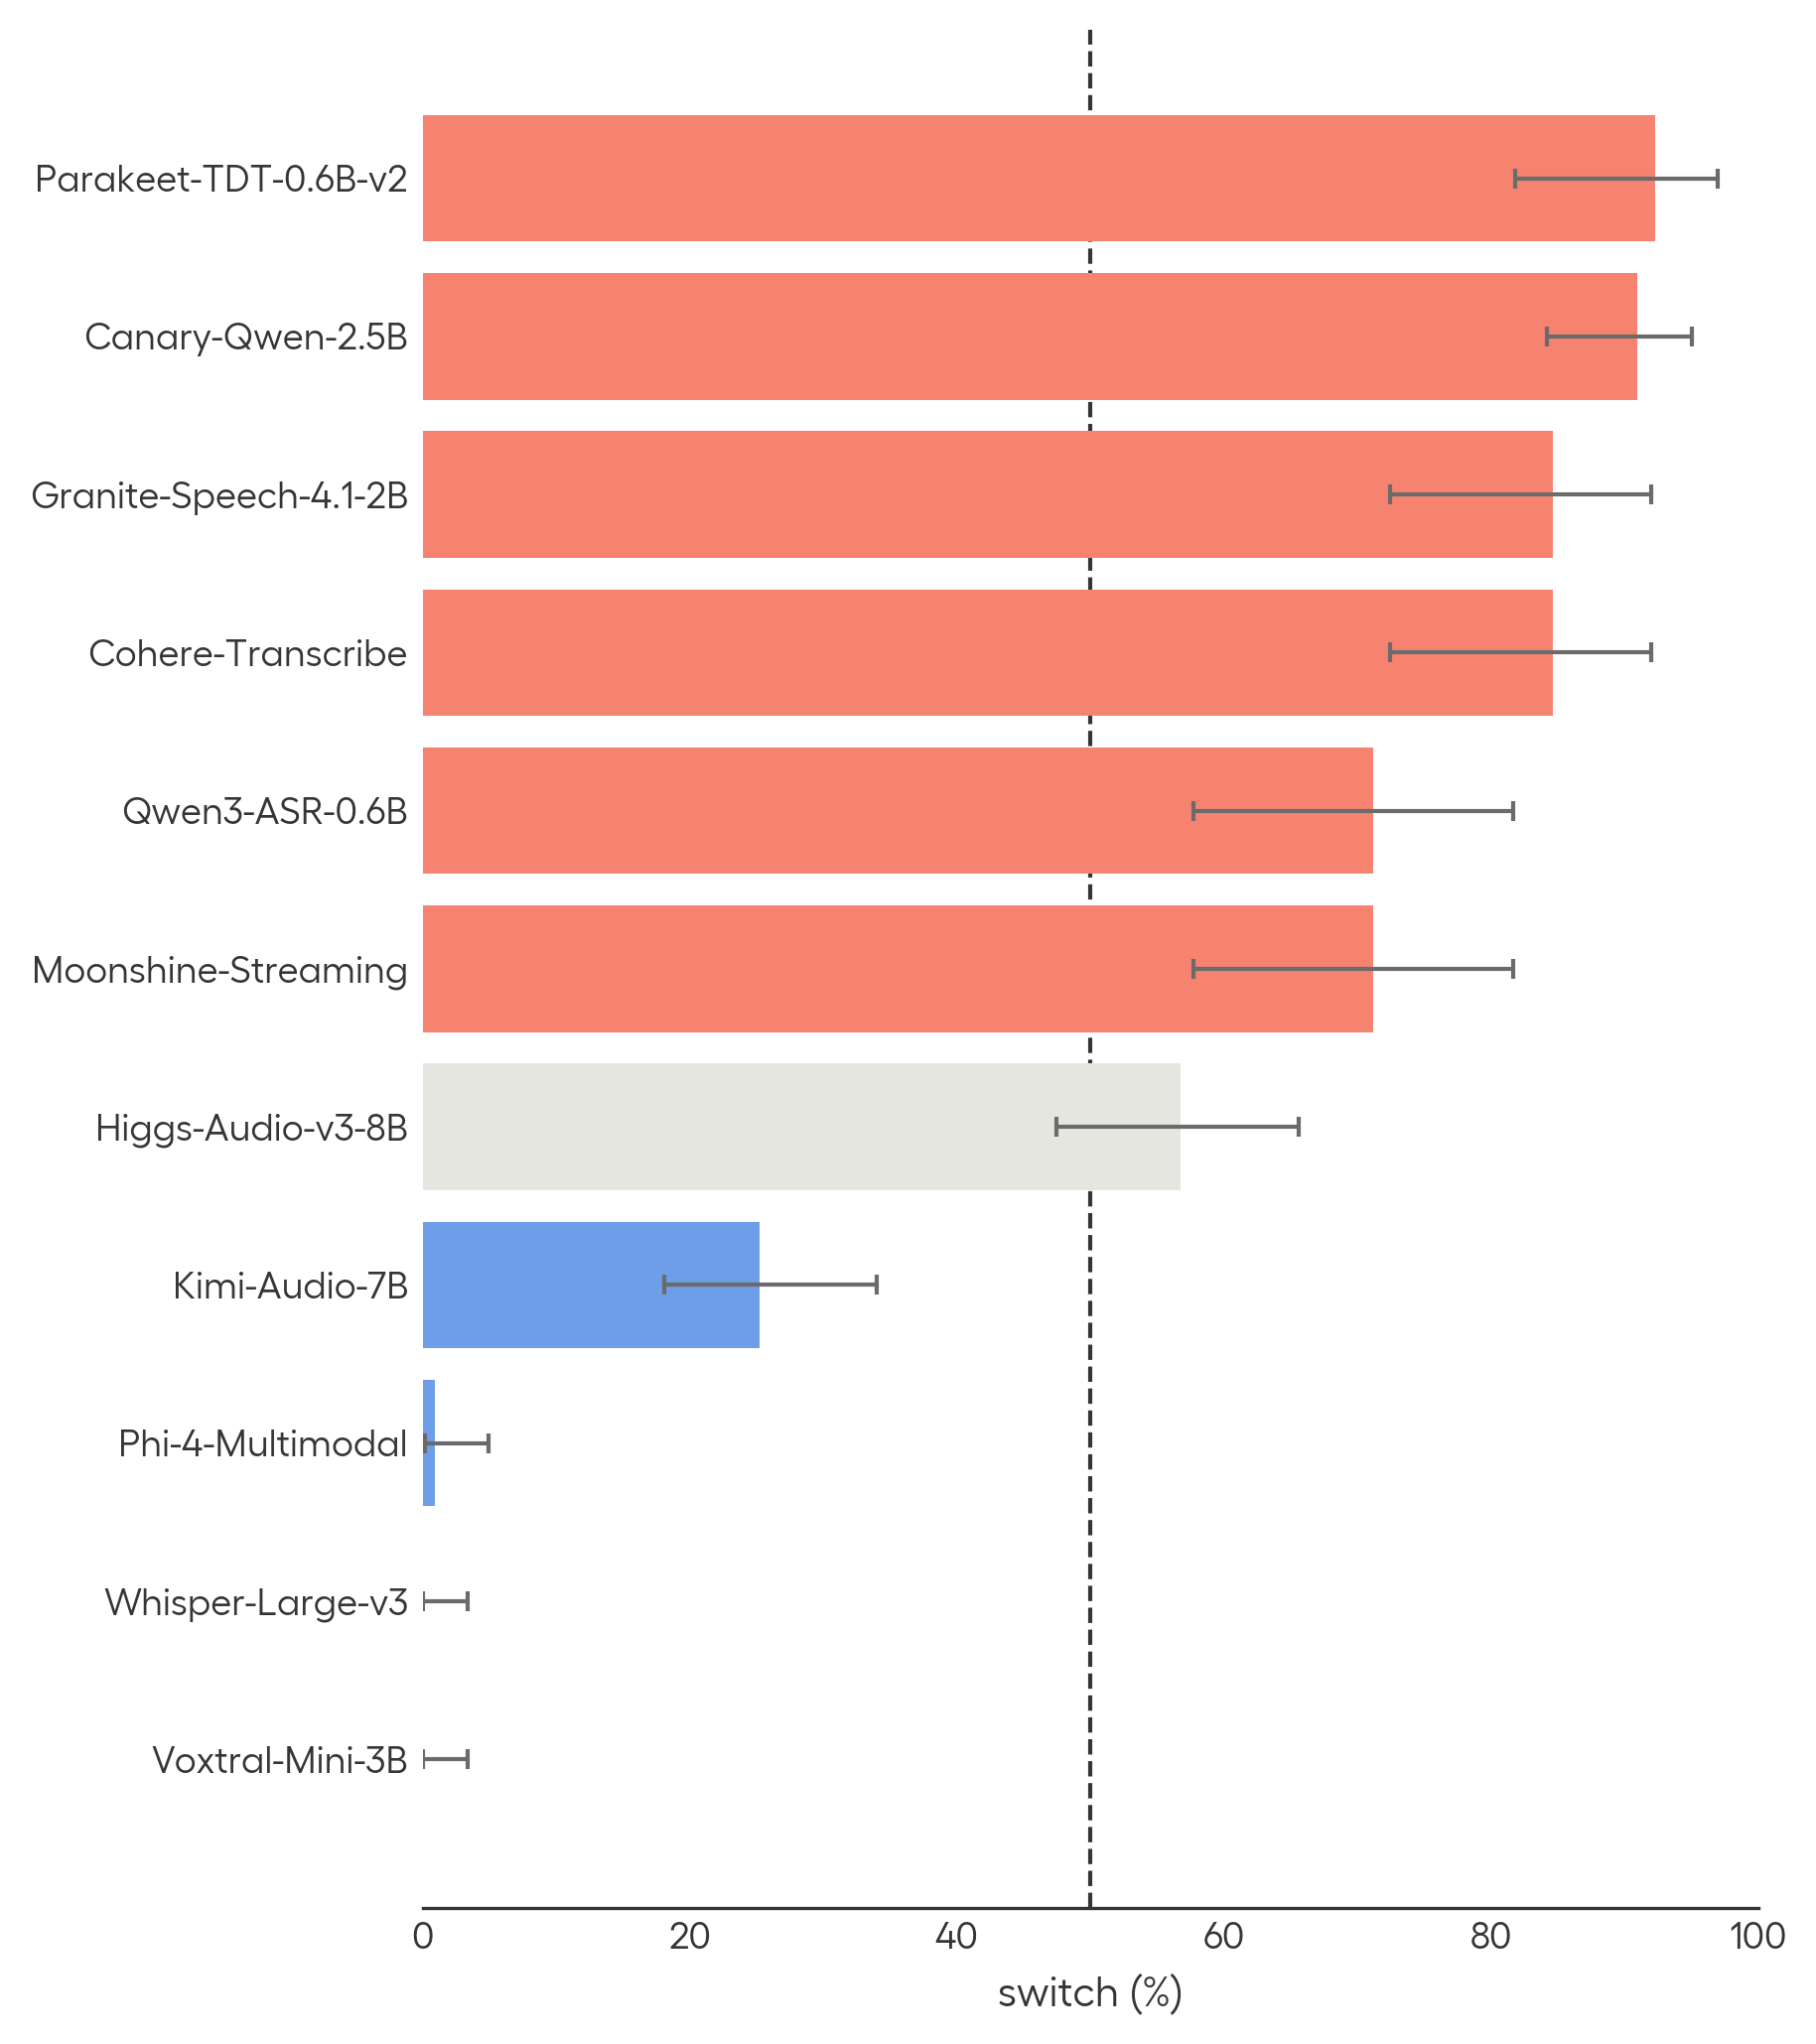
- Orthographic Switching: 音声上は同音で綴りが複数あり得る語(1/one、Mr/mister、any one/anyone、Honor/Honourなど)で、ベンチマーク参照の綴りにモデルが切り替えるかを測定。LibriSpeech内の「any one vs anyone」や「Mr vs mister」などで、ベンチマークの期待綴りへの切り替え率(switch rate)が系統的に観察され、100%に近いモデルもあった。音声だけでは決まらないはずの表記選択が、ベンチマーク準拠に引っ張られている。
 出典: Measuring benchmark optimization in speech recognition — Hugging Face Blog
クレジット: Hume AI / Hugging Face(CC BY相当のブログ掲載図を引用)
WERが低いモデルほど「誤り」を再現する逆説
定量結果は、ベンチマークスコアと最適化のトレードオフを鮮明にした。
- フラグ手法で分析したVoxPopuliテストクリップの約40%に潜在的な参照誤りが見つかり、参照単語全体の約3%に影響していた。
- ベンチマーク最適化の挙動を示すモデルは、誤った参照を18〜30%の割合で再現した。
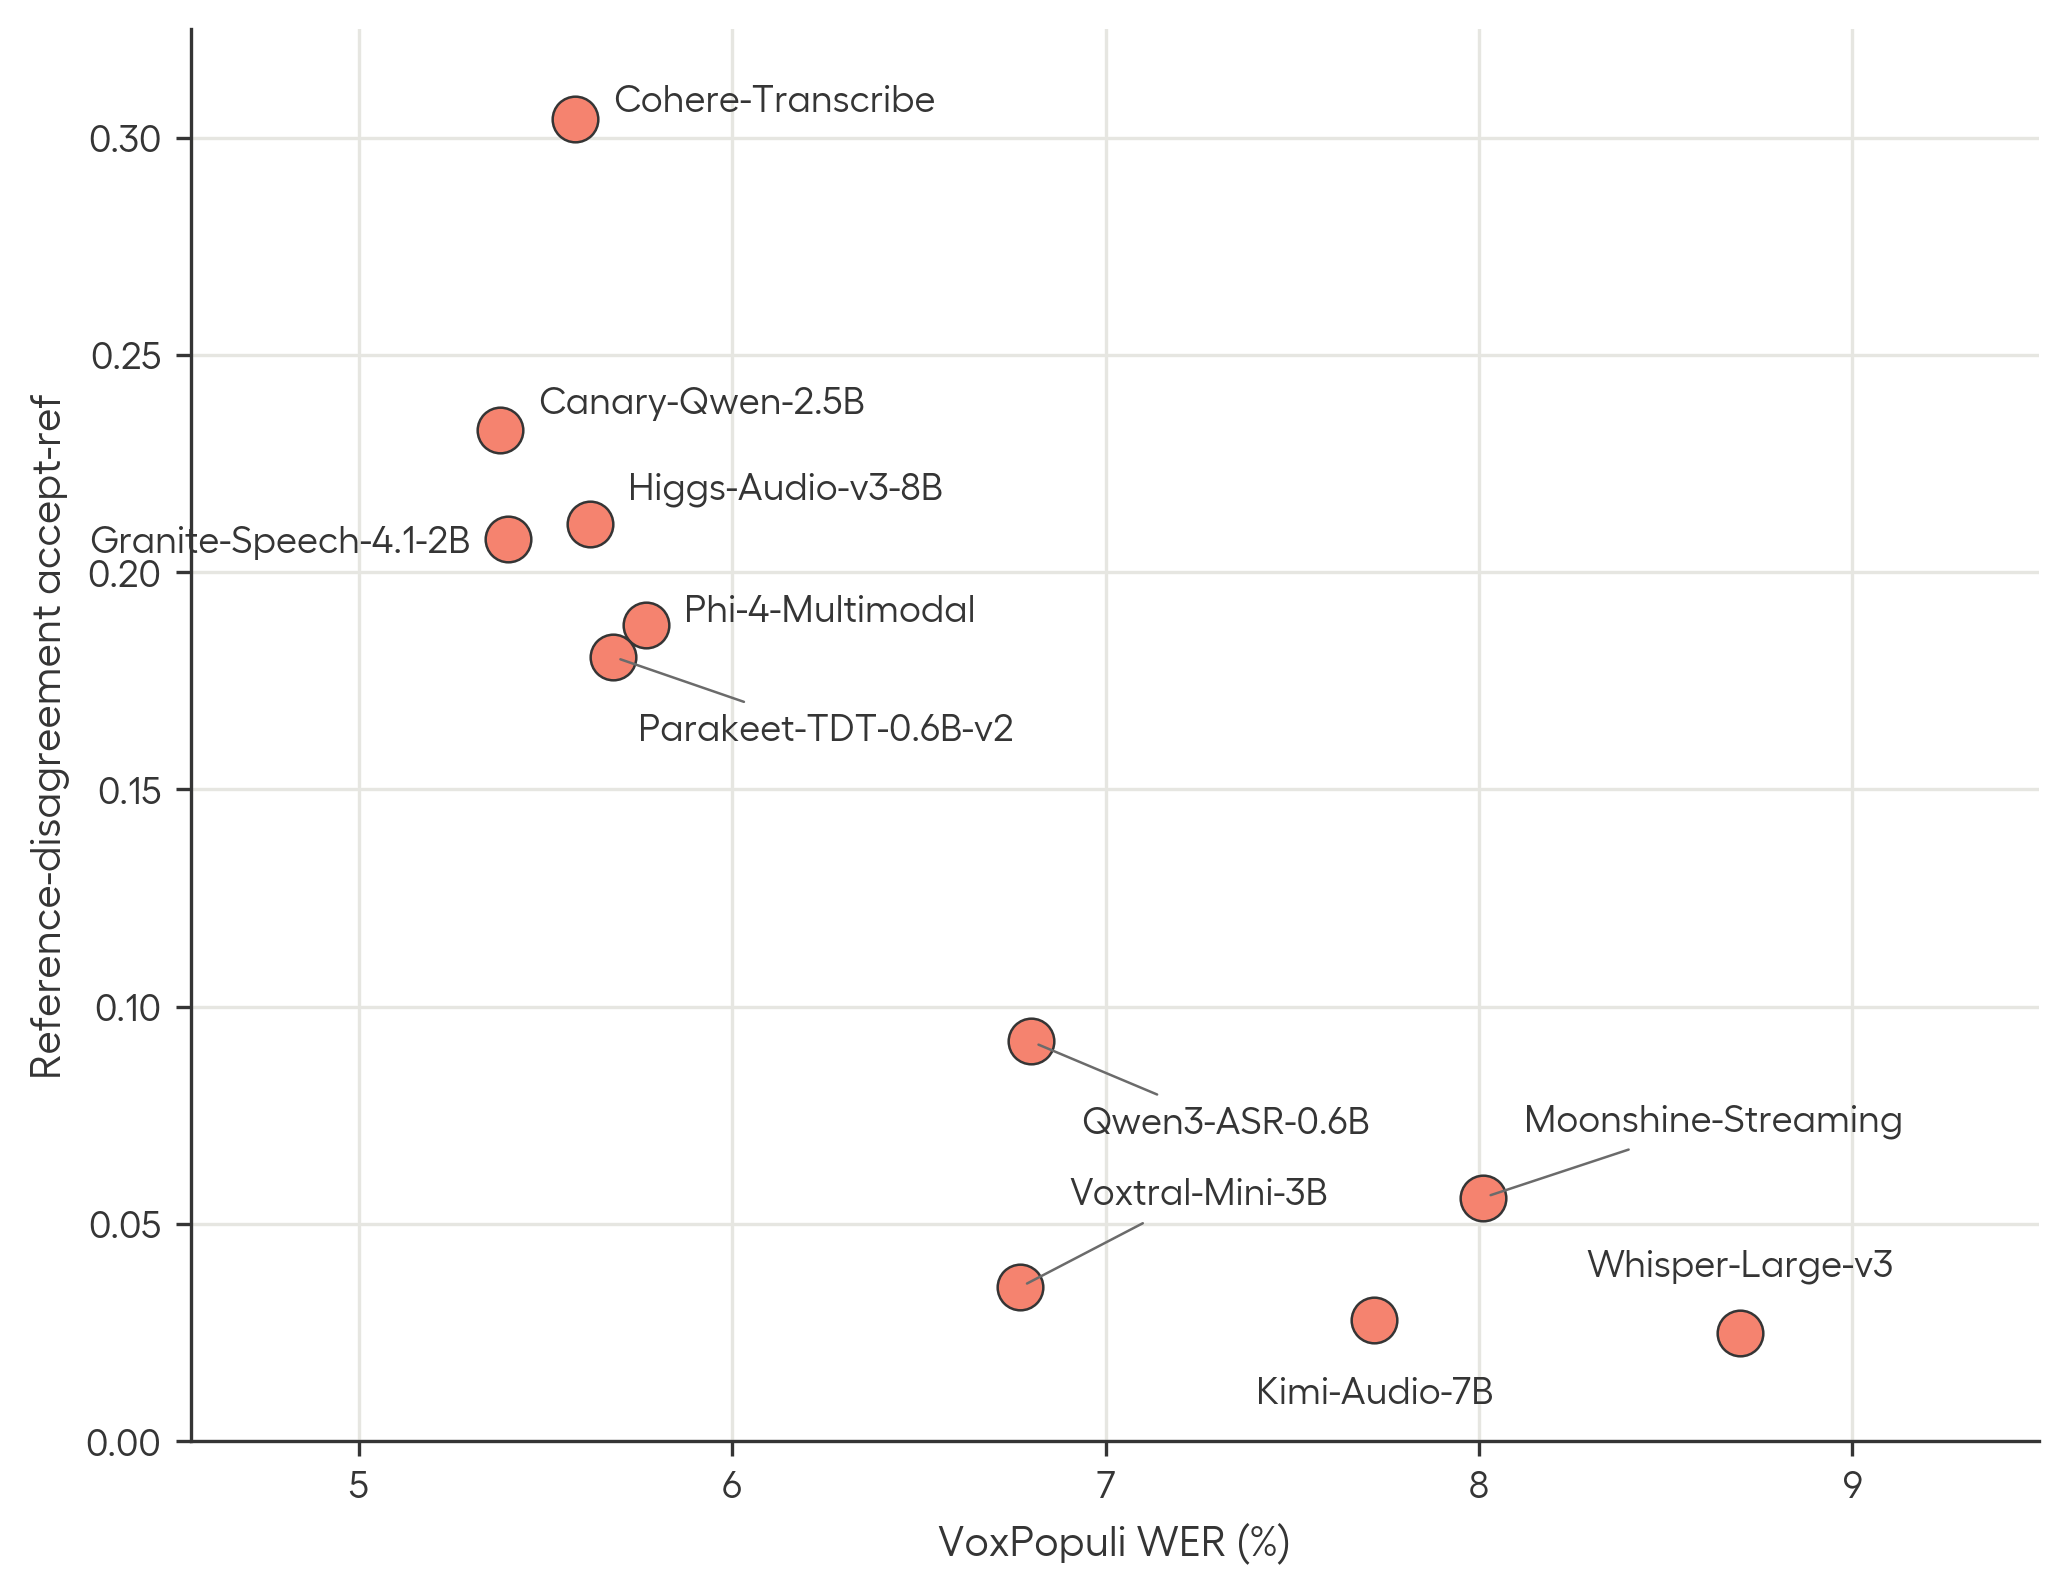
- 下図の散布図が示すように、VoxPopuliの単語誤り率(WER)が低いモデルほど、誤った参照を再現する率が高かった。つまり「最もスコアが良いモデル」が、最もベンチマークの誤りを忠実になぞる傾向にある。
- マスクされた数値の復元や綴り揺れのスイッチも、公開ベンチマーク音声で最も顕著で、held-outや新規収集音声(ep-fresh / libri-fresh)では回復率やスイッチ率が低下するモデルが複数あった。
 出典: Measuring benchmark optimization in speech recognition — Hugging Face Blog
研究では例として「Mr President, in the Committee on Budgets, we voted on more than 1 amendments to the 2011 draft budget … voted in the plenary.」という参照が、実際は「one thousand six hundred」「2011」が無音化されているにもかかわらず、上位モデルが「1」「2011」「plenary」を補完してしまう事例も示されている。数字の一部は文脈から推測可能な場合もあるが、2011のような比較的ランダムな年号まで復元される点は、単なる言語モデル的な補完を超えたベンチマーク記憶の可能性を示唆する。
どこでスイッチが起きているか — 音響手がかりと今後の測定
研究はさらに、モデルの内部でベンチマーク最適化がどこで起きているかを局所化する分析も行った。綴り揺れについて、入力音声レベル、エンコーダ表現、デコーダの言語モデル的バイアスなど複数の介入点を比較したところ、音響入力そのものへの介入がスイッチ挙動に最も強く影響した。つまり、モデルはテキストの統計だけでなく、ベンチマーク音声に特有の微細な音響手がかり(録音環境や話者分布、マイク特性など)に反応して「いまベンチマークを解いている」と識別し、期待される表記へ寄せている可能性がある。
- 公開ベンチマークのスコアだけでなく、held-outセット(Real World VoiceEQ、Open-ASR Leaderboard、Far-field ASR Leaderboardで既に導入)や、新規収集音声での評価を併用する必要性が改めて示された。
- 論文は、ベンチマーク最適化が音声認識でも測定可能であり、上位モデルの高スコアの一部は汎化性能ではなくベンチマーク固有パターンの学習によるものだと結論づけている。
- 検証対象は11のオープンASRモデル(CohereLabs/cohere-transcribe-03-2026、nvidia/canary-qwen-2.5b、ibm-granite/granite-speech-4.1-2b、microsoft/Phi-4-multimodal-instruct、nvidia/parakeet-tdt-0.6b-v2、bosonai/higgs-audio-v3-8b-stt-v2、Qwen/Qwen3-ASR-0.6B-hf、mistralai/Voxtral-Mini-3B-2507、moonshotai/Kimi-Audio-7B-Instruct、openai/whisper-large-v3、moonshine-ai/moonshine-streaming-medium)。いずれも挙動はモデルにより異なり、すべてのモデルが同様に最適化しているわけではない。
 出典: Measuring benchmark optimization in speech recognition — Hugging Face Blog
 出典: Measuring benchmark optimization in speech recognition — Hugging Face Blog
ベンチマークは進歩を測る物差しだが、物差し自体を覚えてしまえば測定は歪む。今回の3プローブは、音声認識におけるその歪みを定量化する実用的な道具を提供する。公開スコアの高さをそのまま実環境の性能とみなすのではなく、held-outや新規収集データでの再現性、誤った参照への追従率、無音区間での幻覚率といった多面的な評価が、実用的な音声AIの選定には不可欠になる。

