

IMAGE: AI生成ビジュアル
RESEARCH / RESEARCH
Alibaba Accio、実業務を再現するエージェント用ベンチマーク「RealReplicaBench」公開 — 107タスクで最上位モデルも完遂率は約62%
Alibaba InternationalのAccioチームが、EC出品・物流手配・文書作成など実際の業務サービスを高忠実度で複製した環境上で、AIエージェントが長期の業務ワークフローを最後まで完遂できるかを測るベンチマーク「RealReplicaBench」を公開した。107タスク(CLI 53・ブラウザ 28・ファイル 16・API/MCP 10)を2つのハーネス(OpenClaw/Accio)×12モデルファミリーで評価した結果、最も成績の良かったClaude Opus 5でも完遂率は56.1%(OpenClaw)/61.7%(Accio)で、全モデルが6割以下の水準に留まった。
AIエージェントの評価基準が「質問に正しく答える」ことから「実務を最後までやり遂げる」ことへ移りつつある。そうした流れの中で、Alibaba InternationalのAccioチーム(电商向けAIエージェントプラットフォームAccio Workを開発)が、実際の業務サービスを高忠実度で再現した環境上でエージェントの長期ワークフロー完遂能力を測るベンチマーク「RealReplicaBench」を公開した。EC出品、出荷・物流の手配、サプライヤー調査、文書やスプレッドシートの作成といった業務を、SaaSや業務システムのローカルレプリカ環境で完遂できるかを一貫して評価する。
ベンチマークと結果はGitHubリポジトリ(バージョンv1.3.1)で公開されており、ライブリーダーボードも運用中だ。以下、公開資料(2026-08-17確認)に基づいて概要をまとめる。
107タスクの構成と評価方法
- タスク構成: 全107タスク=CLI操作53、ブラウザ操作28、ファイル・文書16、API/MCP連携10。モダリティ別ではテキストのみ65、ブラウザ+テキスト20、視覚情報必須22
- 再現環境: 実際のSaaS・EC・メッセージング・文書・業務システムを模した14のモックサービス(replica service)をローカルで起動。本番アカウントなしで「状態を持った」操作(状態遷移・拒否応答を含む)が再現される
- 採点方式: タスクごとにフレッシュなコンテナで実行し、決定論的またはLLM支援の検証器が「最終成果物」と「モック環境の状態変化」を確認する。全部の検証チェックを通過して初めてpassと判定される
- 再現性の取り決め: タスクセット・タスク定義・ハーネス・実行時イメージ(OpenClaw 2026.5.22ベースのピン留め済みDockerイメージ)の4点を固定して比較する仕組みを明文化。採点ジャッジはgemini-3.1-pro-previewで、各モデルはプロバイダ既定の思考(reasoning)設定で実行された
- ライセンス: ハーネス・Pythonパッケージ・モックサービスはApache License 2.0、タスクセット(タスク定義・ワークスペース・検証器・ルーブリック)はCC BY 4.0。商用利用可
結果:12モデルファミリー×2ハーネス
公開されたリファレンス結果は、OpenClaw/Accioの2つのハーネスそれぞれで同じ12モデルファミリーを評価したものだ。ただしスコアはAccio管理の評価エンドポイントによる測定であり、独立した第三者評価ではない点に注意が必要だ。
- OpenClawハーネス: 🥇 Claude Opus 5=60/107(56.1%)、🥈 Claude Opus 4.8=55/107(51.4%)、🥉 GPT-5.6 Sol=53/107(49.5%)。GPT-5.5(47.7%)、Gemini 3.6 Flash(44.9%)、Qwen 3.8 Max(43.9%)、DeepSeek V4 Flash(43.0%)と続く
- Accioハーネス: 🥇 Claude Opus 5=66/107(61.7%)、🥈 Claude Opus 4.8=59/107(55.1%)、🥉 Claude Opus 4.7・Qwen 3.8 Max=56/107(52.3%)で並ぶ。GPT-5.6 Sol(51.4%)、Gemini 3.6 Flash/GLM 5.2/DeepSeek V4 Flash(各46.7%)と続く
- 水準感: 最上位でもタスク完遂率は約62%で、全モデルが6割以下の水準。回答型ベンチマークで高得点を出すフロンティアモデルでも、複数ステップの業務を「最後まで」完遂するのは容易ではないことを示す
- 実行コストの差: タスクあたりの平均トークン数には大きな開きがあり、DeepSeek V4 FlashはOpenClawハーネスで平均137.8ステップ・約1,104万トークンと突出して高い一方、GPT-5.6 Solは28.6ステップ・約209万トークン。効率面でもモデル差が明確だ
- 補足: Qwen系はターン間で思考内容(reasoning_content)を保持しないと結果が変わるとの注意事項も明記されており、利用時は公式ドキュメントの確認が推奨される
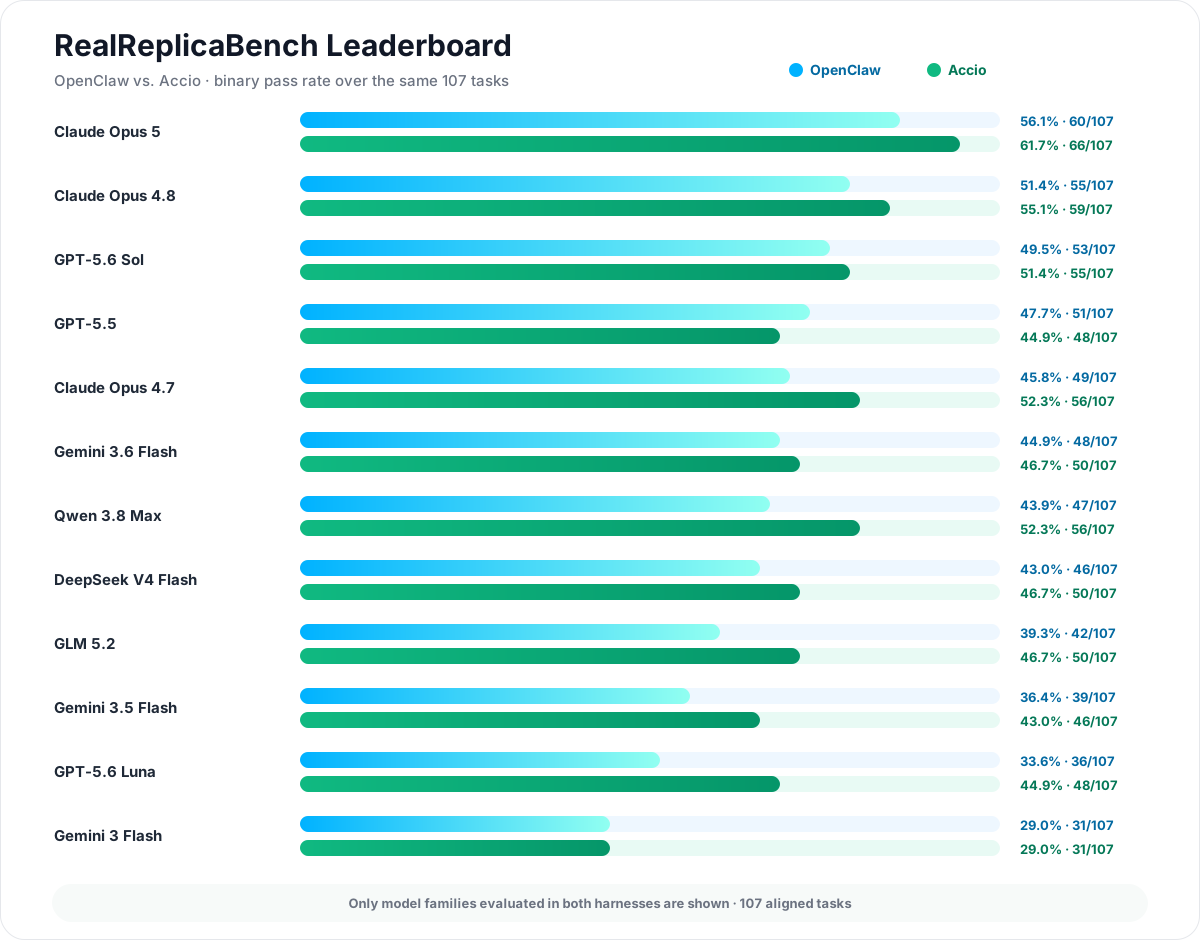
画像出典: GitHub: Accio-org/RealReplicaBench(README掲載のリファレンスリーダーボード)(Apache 2.0・CC BY 4.0、2026-08-17確認)
「回答」から「業務完了」へ:評価の転換点
- 設計思想: 「業務について質問に答える」のではなく「業務を実行して成果物と環境の状態変化を生み出す」ことを検証する。途中で失敗しても部分点(capacity)は記録されるが、完遂判定は全チェック通過が条件で、曖昧な「まあできた」を認めない
- 長期間・状態を持つ評価: 実際の業務は複数システムをまたぎ状態が変化していくため、既存のワンショット型ベンチマークでは捉えきれない部分を、状態を持つレプリカ環境で評価する
- エコシステム戦略: 固定タスクセットはモデルが飽和しデータに混入するため、新しいモックサービスのコントリビューションを募集し、登録済みモック14種を順次タスクセットに昇格させる運用を取る。Accioチームは「ベンチマークは腐敗する(decay)」と明言している
- 文脈: エージェントの実業務投入が進む中、同種の長期・状態を持つ評価基盤(例: ビジネス向けのBusiness Arenaなど)も同チームが公開しており、エージェント評価の「実務完遂」へのシフトが続いている
出典: GitHub: Accio-org/RealReplicaBench(README・v1.3.1)、RealReplicaBenchライブリーダーボード(2026-08-17確認)。
