

NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / Forecasting Research Institute
FRI、AI進歩予測の精度検証を公開 — ベンチマークの進歩を専門家もスーパーフォーキャスターも大幅に過小評価
Forecasting Research Instituteは2026年9月22日、2022年半ば以降に収集したAI進歩予測の精度を検証するレポートを公開した。IMO金メダル級性能は専門家中央値の予測より5年早く到達するなど、ベンチマークでは過小評価が顕著。一方で自動運転の普及予測など過大評価の例もあり、同研究所は手法上のバイアスにも注意を促している。
Forecasting Research Institute(FRI)は2026年9月22日(米国時間)、同研究所が2022年半ば以降に収集してきたAI進歩予測の的中度を検証するレポート「How Accurate Have AI Progress Forecasts Been So Far?」を公開した。専門家とスーパーフォーキャスター(実績のある汎用予測者)の中央値予測を、ベンチマーク性能・普及・影響・地政学ガバナンスの4領域で照合した内容で、AI予測の精度をめぐる連続企画の第1回と位置づけられている。以下は同レポートの公開内容の整理である。
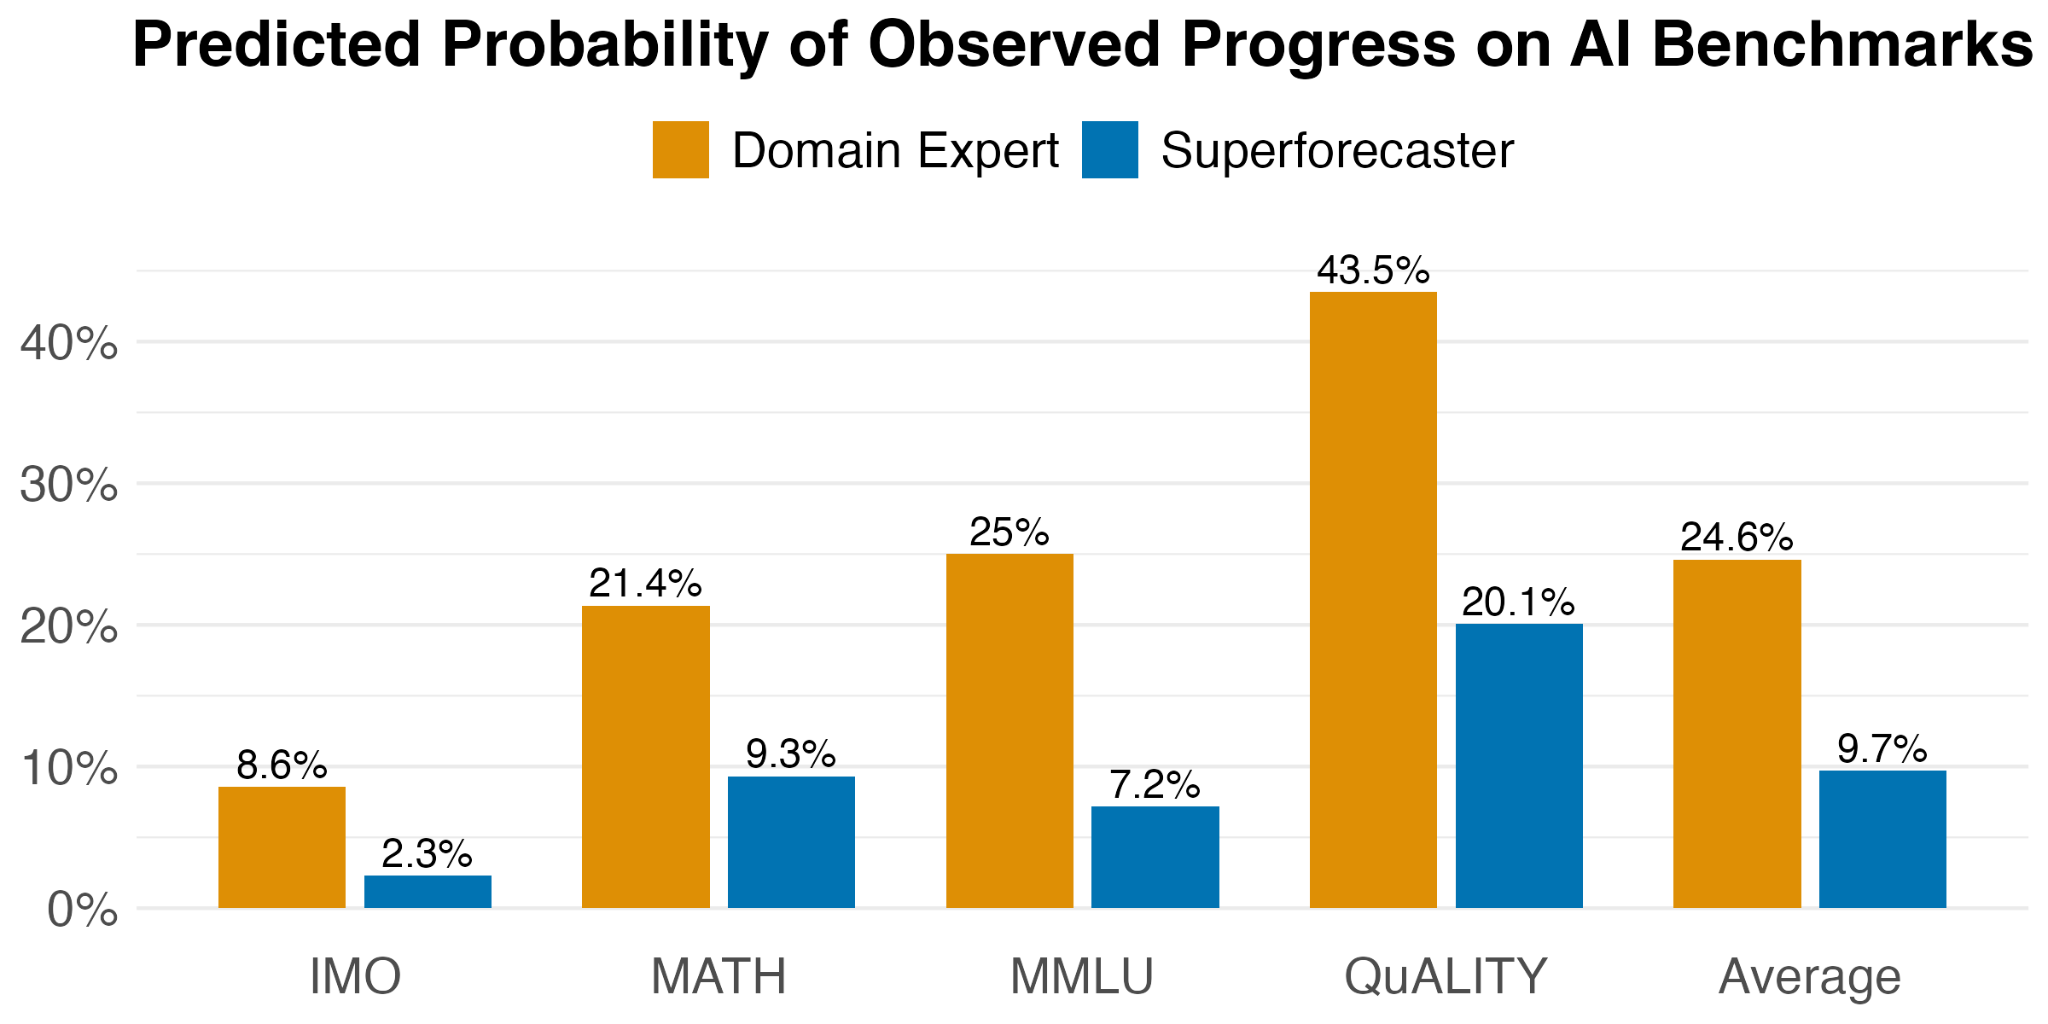
出典: How Accurate Have AI Progress Forecasts Been So Far?(Forecasting Research Institute)
ベンチマーク予測 — 過小評価が一貫した傾向
- 2022年のXPT: Existential Risk Persuasion Tournament(2022年6〜10月収集)では、MATH・MMLU・QuALITY・IMO金メダルの4指標の観測結果に対し、スーパーフォーキャスターは平均9.7%、専門家は平均24.6%の確率しか割り当てていなかった
- IMO金メダル級: 2025年7月に達成されたIMO金メダル級性能は、専門家中央値の予測(2030年)より5年早く、スーパーフォーキャスター中央値の予測(2035年)より10年早かった
- バイオ・サイバー系: 2024年11月〜2025年2月収集の調査では、トップウイルス学者チームに匹敵する時期の中央値予測が専門家2030年・スーパーフォーキャスター2034年だったのに対し、実際には2025年4月時点で到達していた可能性が高いとしている
- 直近のLEAPでも同様: 2025年末に確定したFrontierMath Tier 1〜3の中央値予測は専門家31%・スーパーフォーキャスター30%に対し、実績は40.7%。2026年末確定のLiveCodeBench Pro(Hard)は中央値予測が14%・12%のところ、2026年5月時点の最先端性能はすでに53.8%だった
- 比較的正確だった例: 中国モデルのEpoch Capabilities Indexに関する短期予測など、正確に近い軌道にある設問もあるとしている
普及・収益予測 — 過小評価が目立つ一方、過大評価の例も
- 企業収益の過小評価: 2026年末時点のAI重点企業の最高ARR(年間経常収益)の中央値予測は、AI専門家200億ドル・経済学者160億ドル・スーパーフォーキャスター250億ドルだったが、2026年9月22日時点の現値は1000億ドル程度の可能性が高いとしている
- 2社合算の売上予測: AnthropicとOpenAIの合算年換算収益について、2026年夏のLEAP調査の中央値予測は専門家700億ドル・スーパーフォーキャスター900億ドルで、現値とみられる1400億ドルを大きく下回る
- 過大評価の例: 中堅LLMが非専門家をどこまで支援できるかの無作為化比較試験では、予測(専門家22.5%・ウイルス学者40%・スーパーフォーキャスター16.2%)が実績(5.2%)を上回った。2027年の米ライドシェアに占める自動運転の割合も、専門家中央値7.3%に対しLLM投影は2.5%で、過大評価の軌道にあるとしている
- 精度が高い領域: 米国の電力に占めるAIの割合やハイパースケールデータセンター容量の予測は、LLM投影と概ね近い水準にある
手法と限界 — 中間検証のバイアスを明示
- 対象: 2022年半ば〜2026年8月のXPT、AI敵対的協働、LLMバイオリスク、Active Site RCT予測、AIサイバーリスク、AIの経済効果、LEAPの各研究が対象
- 予測者: 初期LEAPの専門家339名(計算機科学者76名、AI業界76名、経済学者68名、AI政策研究者119名)などで、政策立案者が助言を求める層を意図して集めたと説明している
- 構造的バイアス: 実績値が中央値予測の閾値を超えた時点で過小評価が判明する一方、過大評価は確定日を過ぎないと確認できないため、中間時点の検証は過小評価を見つけやすい構造があると同レポート自身が明記している
- 暫定性: 未確定の設問にはGPT-5.5(高推論)による投影を2026年8月に実施して比較しており、性質上より投機的だとしている。次回は予測精度の改善策を扱う予定
- 留意点: Millennium Prize問題(Navier-Stokes問題)をOpenAIの内部モデルが解いた可能性にも触れているが、確定基準を満たすかは不明としており、本サイトでも断定しない
