

NAW / MODELS 01
IMAGE: AI生成ビジュアル
MODELS / MODELS
Googleが「EmbeddingGemma 2」を公開 — 740Mパラメーターのマルチモーダル埋め込みモデルをApache 2.0で提供
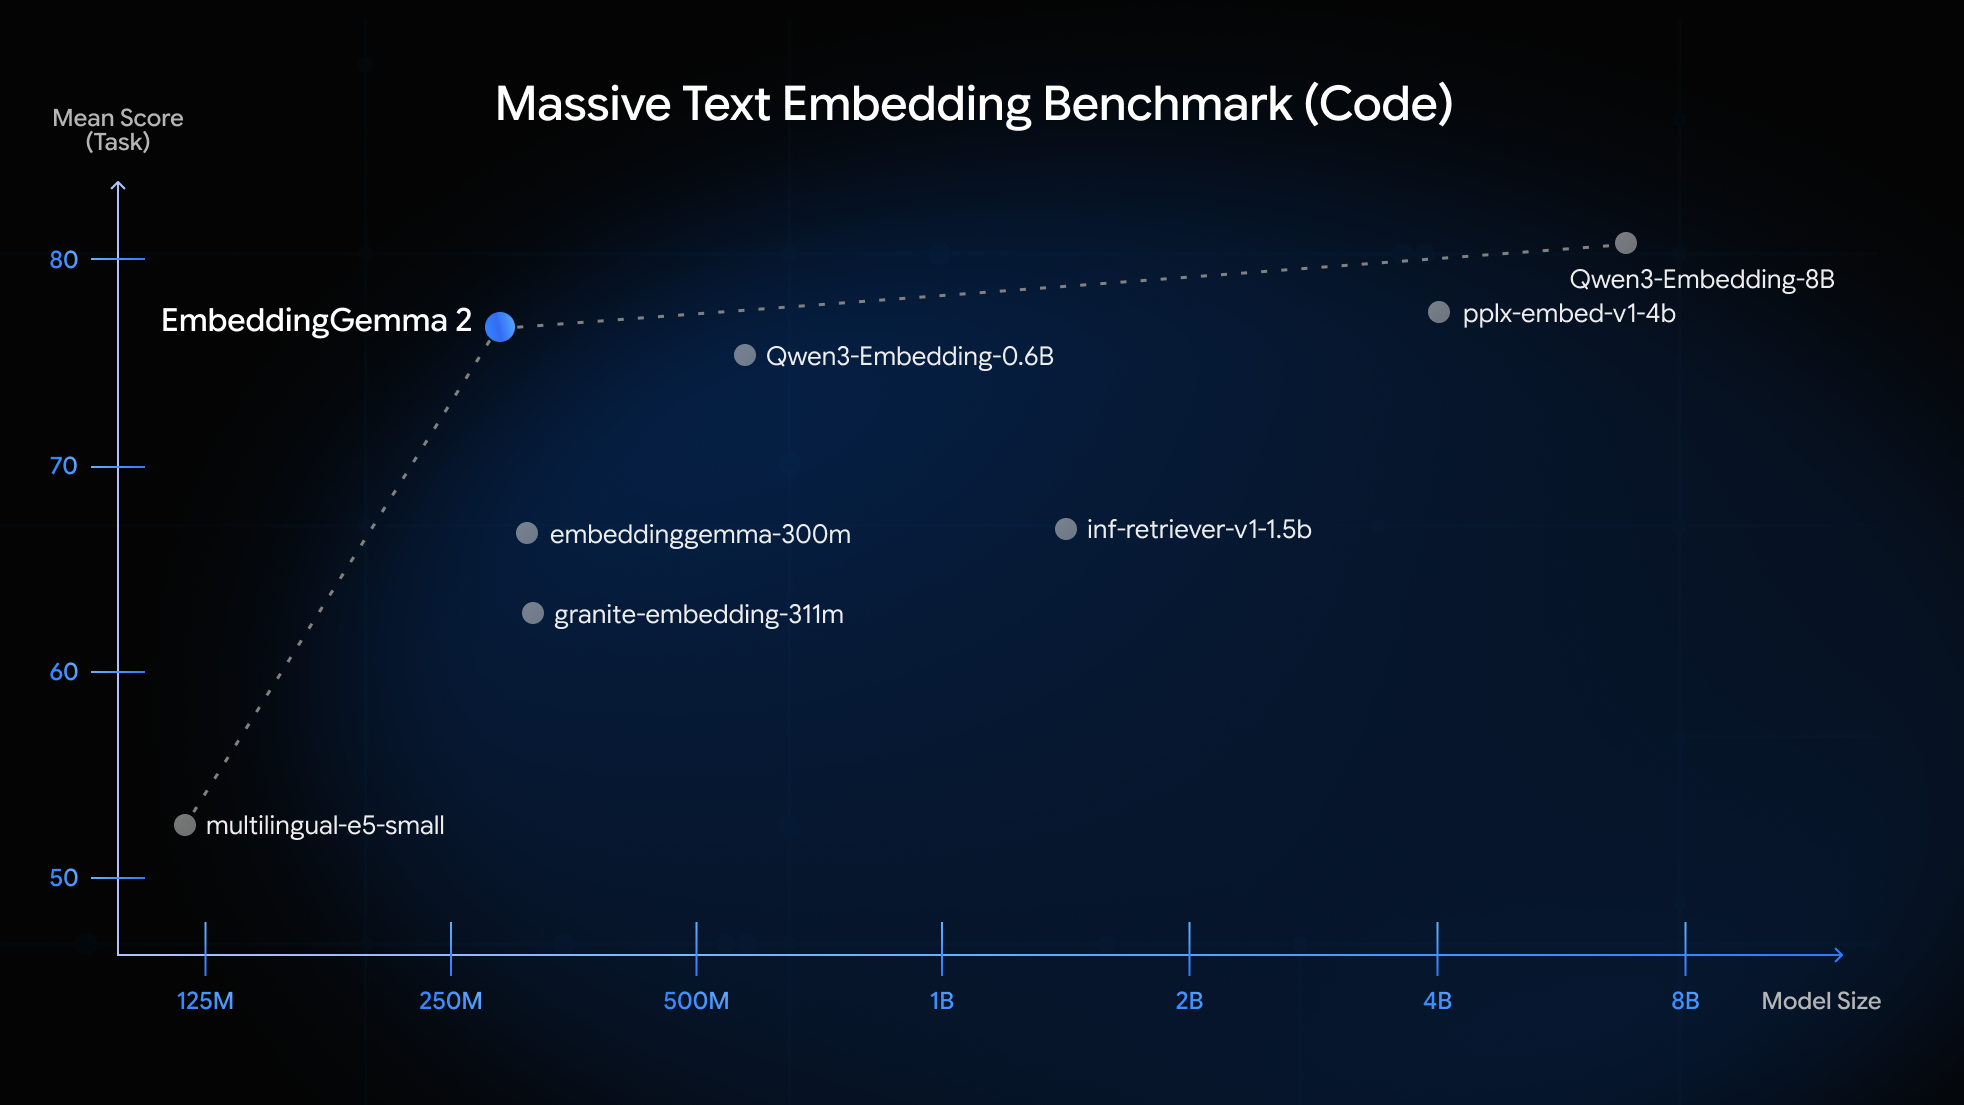
Googleが2026年10月6日、埋め込みモデルEmbeddingGemma 2の開発者ガイドを公開した。Gemma 4ベースの10億未満パラメーターで、テキスト・コード・画像・動画・音声を768次元の共有空間に写像する。用途別に270M〜740Mへ切り替え可能で、MTEB (Code) では前世代比14%向上としている(ベンダー公称値)。
Googleは2026年10月6日(現地時間)、埋め込みモデル EmbeddingGemma 2 の開発者ガイドを公開した。Gemma 4をベースとする10億未満パラメーターのコンパクトなオープンモデルで、テキスト・コード・画像・動画・音声を768次元の共有ベクトル空間に写像する。重みはApache 2.0ライセンスで公開され、Hugging Faceから取得できる。本稿は公式の開発者ガイドで確認できる範囲に限定して整理する。
単一モデルで5モダリティを768次元に統合 — 仕様
- 対応モダリティ: テキスト、コード、画像、視覚文書(PDF・スライド・チャート)、動画フレーム、音声を、特殊化したエンコーダーで処理しつつ共有バックボーン経由で同じ768次元空間に写像する
- モジュラー構成: 必要なエンコーダーのみ読み込む方式で、テキスト/コードのみ 270M、テキスト+画像・動画 440M(vision +170M)、テキスト+音声 570M(audio +300M)、全モダリティ 740Mパラメーターとなる
- コンテキスト: 全モダリティで共有の 8,192トークン。動画は既定で毎秒1フレームをサンプリングし、音声は16kHzモノラルを想定している
- コード理解: コード検索・技術文書検索でEmbeddingGemma 1を大きく上回るとし、ローカルのコードベース索引やエージェント型コード検索に向くとしている
- 連携: Gemma 4と同一のテキストトークナイザー・音声エンコーダー構成を共有するため、オンデバイスRAGで組み合わせた際の総メモリを抑えられるとしている
評価 — MTEB (Code) で前世代比14%向上(ベンダー公称値)
以下はいずれも開発者ガイドに記載のベンダー公称値であり、独立評価ではない。
- MTEB (Code): EmbeddingGemma 1比で 14%向上したとしている
- 多言語テキスト: 前世代の多言語テキスト精度を維持しつつ、画像・動画・音声の検索を追加したとしている
- 次元削減の保持率(公称値): 256次元ではテキスト・コードの品質の大部分を保持し、画像・動画・音声検索で約95%。128次元ではテキスト・コードで約90%、マルチモーダルで約75%としている
出典: EmbeddingGemma 2: The Developer Guide - Google Developers Blog
使い方 — sentence-transformersと次元削減
- 導入:
sentence-transformersv6.1.0以降に対応し、モデルIDgoogle/embeddinggemma-2で読み込む。画像・音声・動画を使う場合は対応エクストラと一緒に導入する - モジュラー読み込み: 読み込み時に
vision_config/audio_configをNoneにすると未使用エンコーダーをメモリに載せない。同一チェックポイントから4構成を読み分けられ、テキストのみ構成で埋め込んだクエリとフルモデルで埋め込んだ文書を直接突合できるとしている - タスクプロンプト: 検索クエリと文書で
prompt_name(SearchQuery/Documentなど)を使い分ける方式。メディア単体はモダリティ別の辞書形式、複合入力は<|image|>/<|video|>/<|audio|>のマーカーで埋め込む - Matryoshka次元削減:
truncate_dim(512/256/128)と正規化で短いベクトルを取得できる。bfloat16で100万件×768次元は約1.5GB、128次元では約250MB(約6分の1)になるとしている - 対応ツール: vLLM、Hugging Face Transformers、sentence-transformers、SGLang、MLX、Ollama、LMStudio、LiteRTでの実行、Unslothでの効率的なファインチューニング、AI Edge Galleryのオンデバイスデモが案内されている
注意点 — 公称値と検証範囲
- 評価の性質: 14%向上などの数値は開発者ガイドの公称値で、独立した再現評価ではない
- 次元削減の適用: 128次元のマルチモーダル用途では品質低下が大きいとされており、導入前に自前のデータでの検証が推奨されている
- 比較対象の限定: 「同規模で傑出したマルチモーダル性能」などの表現は同社の評価によるもので、対象モデルや時点の定義は開発者ガイドの記載範囲に依存する
