

NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / Microsoft
Microsoftがエージェント評価環境「ThinkingBox」を公開 — 応答ではなくDBの最終状態で採点、507業務×20回試行
ツール呼び出しが正しくてもDBが間違っていれば不合格とする状態ベース評価。507件の業務ワークフローを各20回実行し、12モデル・約12万試行で比較。単発成功と20回連続成功のコスト差や、失敗の約8割がツール処理系という分析も公開。サンドボックス・データセット・学習用リポジトリをオープンソース化している。
Microsoftは2026年10月3日(UTC)、AIエージェントの評価環境「ThinkingBox」とベンチマーク用データセット「ThinkingBox-Bench」をHugging Face Blogで公開した。エージェントの最終応答やツール呼び出しの体裁ではなく、業務データベース(DB)の最終状態と副作用で合否を判定する点が特徴である。507件の状態付き業務ワークフローを各タスク20回ずつ実行し、一貫性(毎回成功するか)まで測る設計になっている。以下は同社の公開記事の記載範囲の整理である。
状態で採点する設計 — 「完了と言った」と「DBが合っている」は別物
- 問題意識: 記事の冒頭では、返金対応の事例として、9回のツール呼び出しを正しく行いながら、配送業者の例外が未解決のまま誤った対応で終えたエージェントの例を示している。ツール呼び出しだけを見る採点では正しく見えるが、DBの状態を見れば不合格だという主張である。
- 採点対象: 各タスクは開始時のバックエンド状態、ユーザー目標、利用可能なMCPツール、ドメインポリシー、そして最終状態に対する実行可能チェック(executable checks)で定義される。試行終了後に副作用抽出器が実際の変更を導出し、決定的ジャッジが要求される最終状態と照合する。
- 隔離実行: 毎試行に独立したMCPセッションと初期化済み状態が割り当てられ、同一タスクの2試行がDB行やツール状態を共有しない。これにより20回試行の比較が意味を持つとしている。
- 模擬ユーザー: 予約番号や好み、生年月日などの非公開文脈を持つ模擬ユーザーが、聞かれた場合にのみ情報を開示する設定になっている。
- 信頼境界: モデル側が見るのはタスク・対話・ツールスキーマのみで、正解の状態・アサーション・採点内部・認証情報は評価側に置くとしている。
- 規模の実感: 12種のLLMを横断する共通集合のアブレーションでは、有効試行121,680件のうち79,853件が実行可能チェックで不合格となった。不合格のうち67.24%は「正常終了し、状態変更ツールを呼び、最終的なツールエラーも報告していない」にもかかわらず、77.61%でフィールド値の誤り、43.30%で意図しない余分な副作用、25.36%で必要な副作用の欠落が見つかったとしている(各所見は重複あり)。
単発の成功と一貫性、コスト — pass@1と「20回とも成功」は別の能力
- 単発と反復: よく使われる単発成功率(pass@1)の表に加え、全タスクを20回ずつ実行してどれだけ成功が残るか(全試行成功ベースの見方)を測っている。例として、Claude Opus 5は一度でも解けたタスクの割合が79.09%にとどまり106タスクは一度も解けなかったと報告しており、単発で解けることと繰り返し安定して解けることは別だと論じている。
- 成功1件あたりのコスト: 全キャンペーンのトークン使用量を定価で換算した比較効率指標として、Claude Opus 5は成功1件あたり0.475ドル・pass@1 66.50%に対し、Claude Opus 5.5は0.276ドル・67.16%だったとしている。GPT-5.6 Solは成功1件あたり0.127ドルで最も安かったとしている。
- 安定成功あたりのコスト: さらに全20回成功タスク数でキャンペーン総コストを割った「dependable taskあたりコスト」も算出している。GPT-5.6 Solは単発成功では最安だが安定成功あたりは9.76ドル、Claude Opus 5は241タスクを各13.30ドルで達成しOpus 5.5がこれを上回った(dominates)としている。「安く正解を出す方法」と「安定的に正解を出す方法」は一致しない、というのが記事の結論である。
- 注意点: いずれも記事内の比較効率指標であり、実運用の請求額ではないと明記されている。価格は利用時点の割引なし定価ベースで換算したものとしている。
失敗の内訳と実務示唆 — 約8割はツール処理、領域で難易度差
- 診断: 失敗トレースに決定的な診断シグネチャを付与した分析では、失敗のおよそ5分の4は推論ではなくツール処理系(tool handling)に起因するとしている。典型パターンは、ワークフローの途中までは進むものの、ツールエラー・前提条件の不成立・空の検索結果からの回復に失敗するというもので、モデル以前にリトライとエラー回復の問題だと整理している。
- 領域差: ドメイン別の平均pass@1は、小売り59.52%に対し自動車保険33.83%など、領域で難易度が変わるとしている。
- 実務の処方箋(未検証と明記): ツール・システムエラーを分類して回復可能なものに絞ったリトライ、ワークフローに必要な最小限のツール面への削減、安く取り消せない変更への人間承認の要求を挙げている。ただし、これらの改善効果は本ベンチマークでは未測定であり、検証可能にするための環境こそが公開の主眼だと述べている。
- 合成データの断り書き: 公開ベンチマークの全タスクは実在の企業パターンを模した合成再構成であり、顧客は実在しないと明記している。
公開物と再現方法 — MITの枠組み、データセット、OpenEnv対応
- ThinkingBox: MCPサーバーとしてツールを定義し、LLMエージェントを実行・評価する枠組み。オフラインの学習データ生成、強化学習の学習ループ、モデル評価を用途として挙げている。GitHubリポジトリ(
microsoft/thinkingbox)はMITライセンスで公開されている。 - 関連リポジトリ: ベンチマークデータ用の
microsoft/thinkingbox-data、学習用のmicrosoft/thinkingbox-trainingも公開されている。 - ThinkingBox-Bench: エージェント評価用のデータセットベンチマークとしてHugging Faceで公開(
microsoft/ThinkingBox-Bench)。ThinkingBox本体がエージェント実行のサンドボックス、ThinkingBox-Benchが評価用データセットという役割分担である。 - 再現実行: Hugging FaceのOpenEnv(
envs/thinkingbox_env)経由で実行でき、運用失敗はエラーのサイドカーに書き出して再実行できる設計としている。正規結果は固定の枠組みコミット・固定のデータリリース・バンドルハッシュでゲートされ、主張ではなく検証可能な形にするとしている。
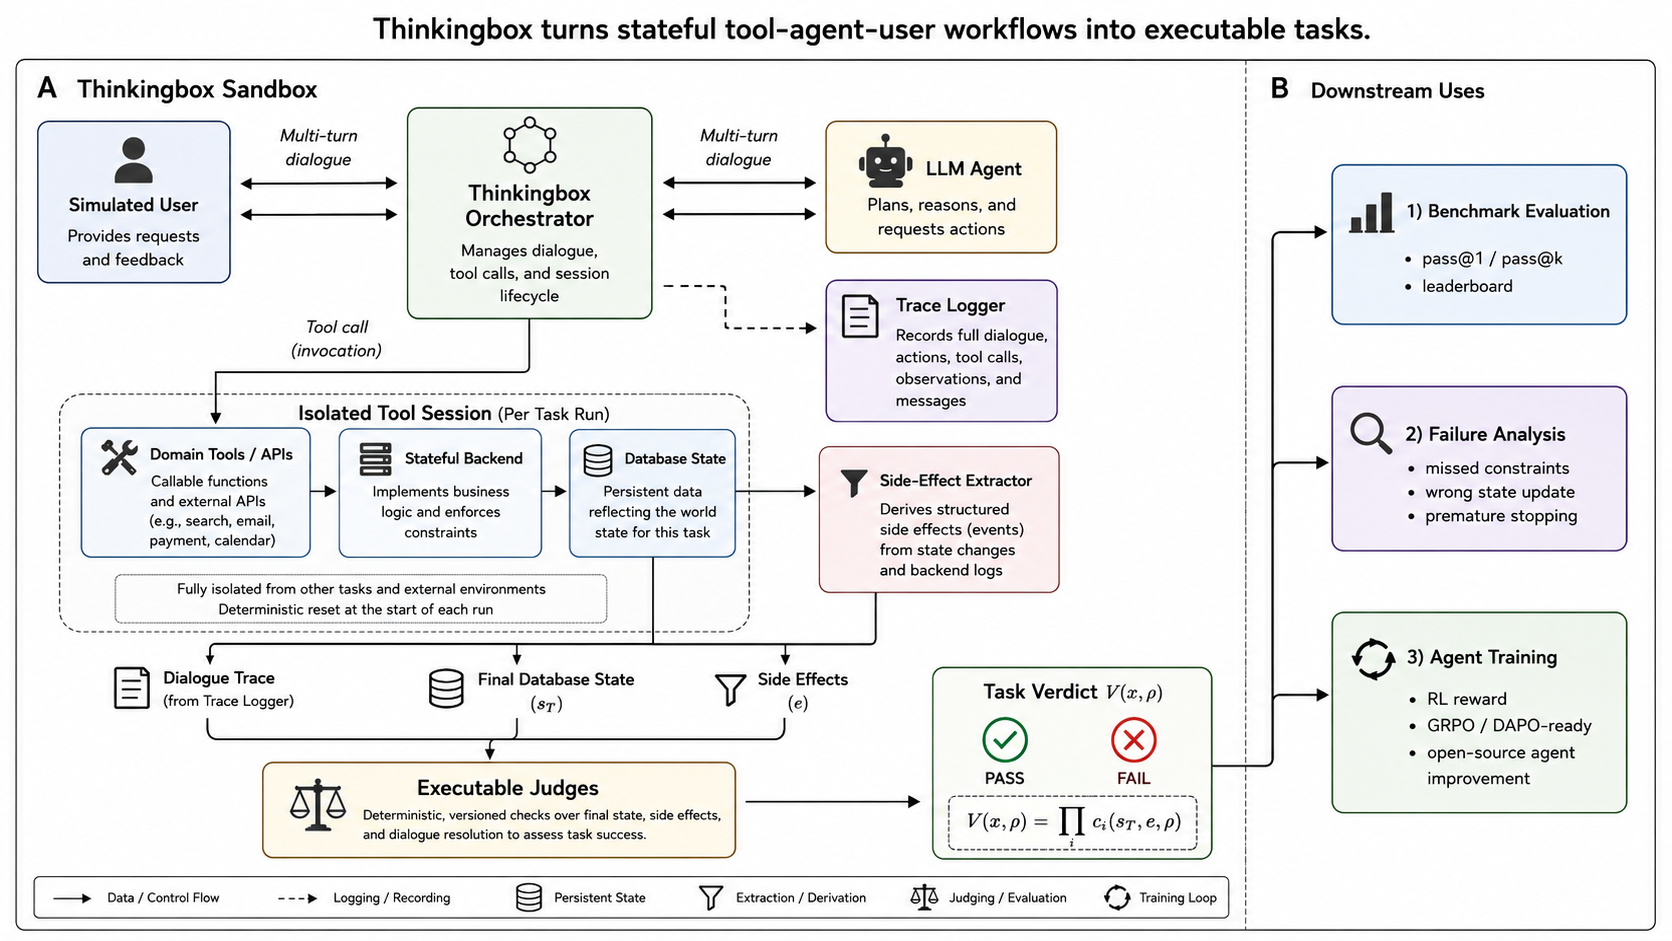
出典: The Agent Said It Was Done. The Database Disagreed.(記事冒頭の図。ThinkingBoxのサンドボックスと評価のループを示すもの)