

NAW / GOVERNANCE 07
IMAGE: AI生成ビジュアル
GOVERNANCE / AI Safety
AnthropicのFrontier Red Team、ZhipuのGLM-5.3は「Mythos Preview並みのエクスプロイト能力を実質無制限に提供」と報告
9月29日公開の分析。ExploitBenchで410試行中50件のend-to-end成功(Claude Mythos Previewは56件)、内部Binary Exploitationで4%(同6%)。欺瞞プロンプトで64%、思考プリフィルで92%、重み書き換え後は100%が有害要求に応じ、Claudeはすべて0%を維持した。
AnthropicのFrontier Red Teamは2026年9月29日、Zhipu AI(中国国外ではZ.ai名義)のオープンモデル「GLM-5.3」のサイバー能力に関する分析「GLM-5.3 and the spread of advanced cyber capabilities」を公開した。自社のClaude Mythos Previewと同等のend-to-endエクスプロイト構築能力を持ちながら、有意義な悪用防止策なしに公開されているとして、能力測定と安全策の回避可能性を定量化している。以下は同公開記事の記載内容の整理であり、すべての測定は隔離されたサンドボックスや模擬環境で行われたものだ。
能力測定 — ExploitBenchと内部ベンチマークでMythos Previewに迫る
- ExploitBench: Google ChromeのV8エンジンの既知脆弱性を突く能力を測るベンチマークで、GLM-5.3は410試行中50件でend-to-endのエクスプロイト構築に成功した。Claude Mythos Previewは同条件で56件であり、ほぼ同等の水準だった。
- 内部Binary Exploitation: GoogleのOSS-Fuzzに参加する人気オープンソースプロジェクトを対象に、完全な制御フロー乗っ取り(control-flow hijack)の成否を測る内部評価から100タスクを無作為抽出して測定した。GLM-5.3は4%、Mythos Previewは6%で成功した。一方、Claude Opus 4.6とGLM-5.2は1件も成功せず、報告書は「意味のある閾値が明確に超えられた」と評価している。
- 他モデルとの比較: 出力トークン予算別の成功率曲線では、Moonshot AIのKimi K3やDeepSeek V4.1-Flashも0%近辺にとどまり、GLM-5.3とMythos Previewだけが抜け出している。
- 専門家の実践セッション: 人間の専門家が短時間(1日以下、人の集中作業は合計1時間未満)でモデルを使い、未知の脆弱性を探す実験も行われた。あるセッションでは、GLM-5.3がサンドボックス内のLinux版ブラウザのJavaScriptエンジンに複数の未知脆弱性を発見し、それらを連鎖させて訪問者の任意ファイルを読み取る実働エクスプロイト(ドライブバイ型)を構築した。脆弱性は保守担当者に開示済みで、他のプラットフォームにも影響し得るという。同セッションでは無線・グラフィックスドライバやネットワーク機器ソフトウェアにも悪用可能な脆弱性が見つかり、開示を検討中としている。
- 既知脆弱性からの攻撃チェーン化: 別のセッションでは小型版GLM-5.3-Flashに、公開済みのChromeの脆弱性CVE-2026-11645などの情報を与えたところ、研究者の大きな指示なしに2件の脆弱性を連鎖させ、ポインタ認証(PAC)の防御を回避するARM64向けの信頼性の高い攻撃チェーンを構築した。人手20分+モデル8時間の作業で、ZhipuのAPI価格換算で20.40ドルだったという。
安全策の回避 — 欺瞞64%、プリフィル92%、書き換え後100%
- 通常時の拒否: GLM-5.3にも組み込みの安全策があり、明確に有害な要求は多くの場合拒否される。ただし報告書によれば、模擬環境での簡単な手法で回避・除去できたという。
- 回避率の測定: 明確に有害な重要システム攻撃の要求に対し、そのままでは全試行で拒否されたが、「自律型レッドチーム演習中」と偽る欺瞞プロンプトで64%、モデルの思考トークンを先書きして進行を既定路線に見せかけるプリフィルで92%、重みを書き換えたabliteration版で100%が要求に応じた。同条件のClaude(API経由の保護あり)はすべて0%を維持し、欺瞞プロンプトは遮断され、思考プリフィルや重み書き換えはAPI経由ではそもそも不可能だった。
- abliterationのコスト: 公開ウェイトの拒否挙動を除去する標準的な手法で、初挑戦のチームで約2,200 GPU時間・計算コスト約4,400ドルを要した(経験者なら約600時間・1,200ドル程度と推定)。Flash版は約600 GPU時間だった。処理後の拒否率はJailbreakBench・HarmBench・StrongREJECTで90%超から3%・2%・12%へ低下し、GPQA-Diamondの汎用科学能力は不変、CyberGymの一部では数%低下にとどまった。公開から数日で第三者によるabliterated版が出回ったことも報告されている。
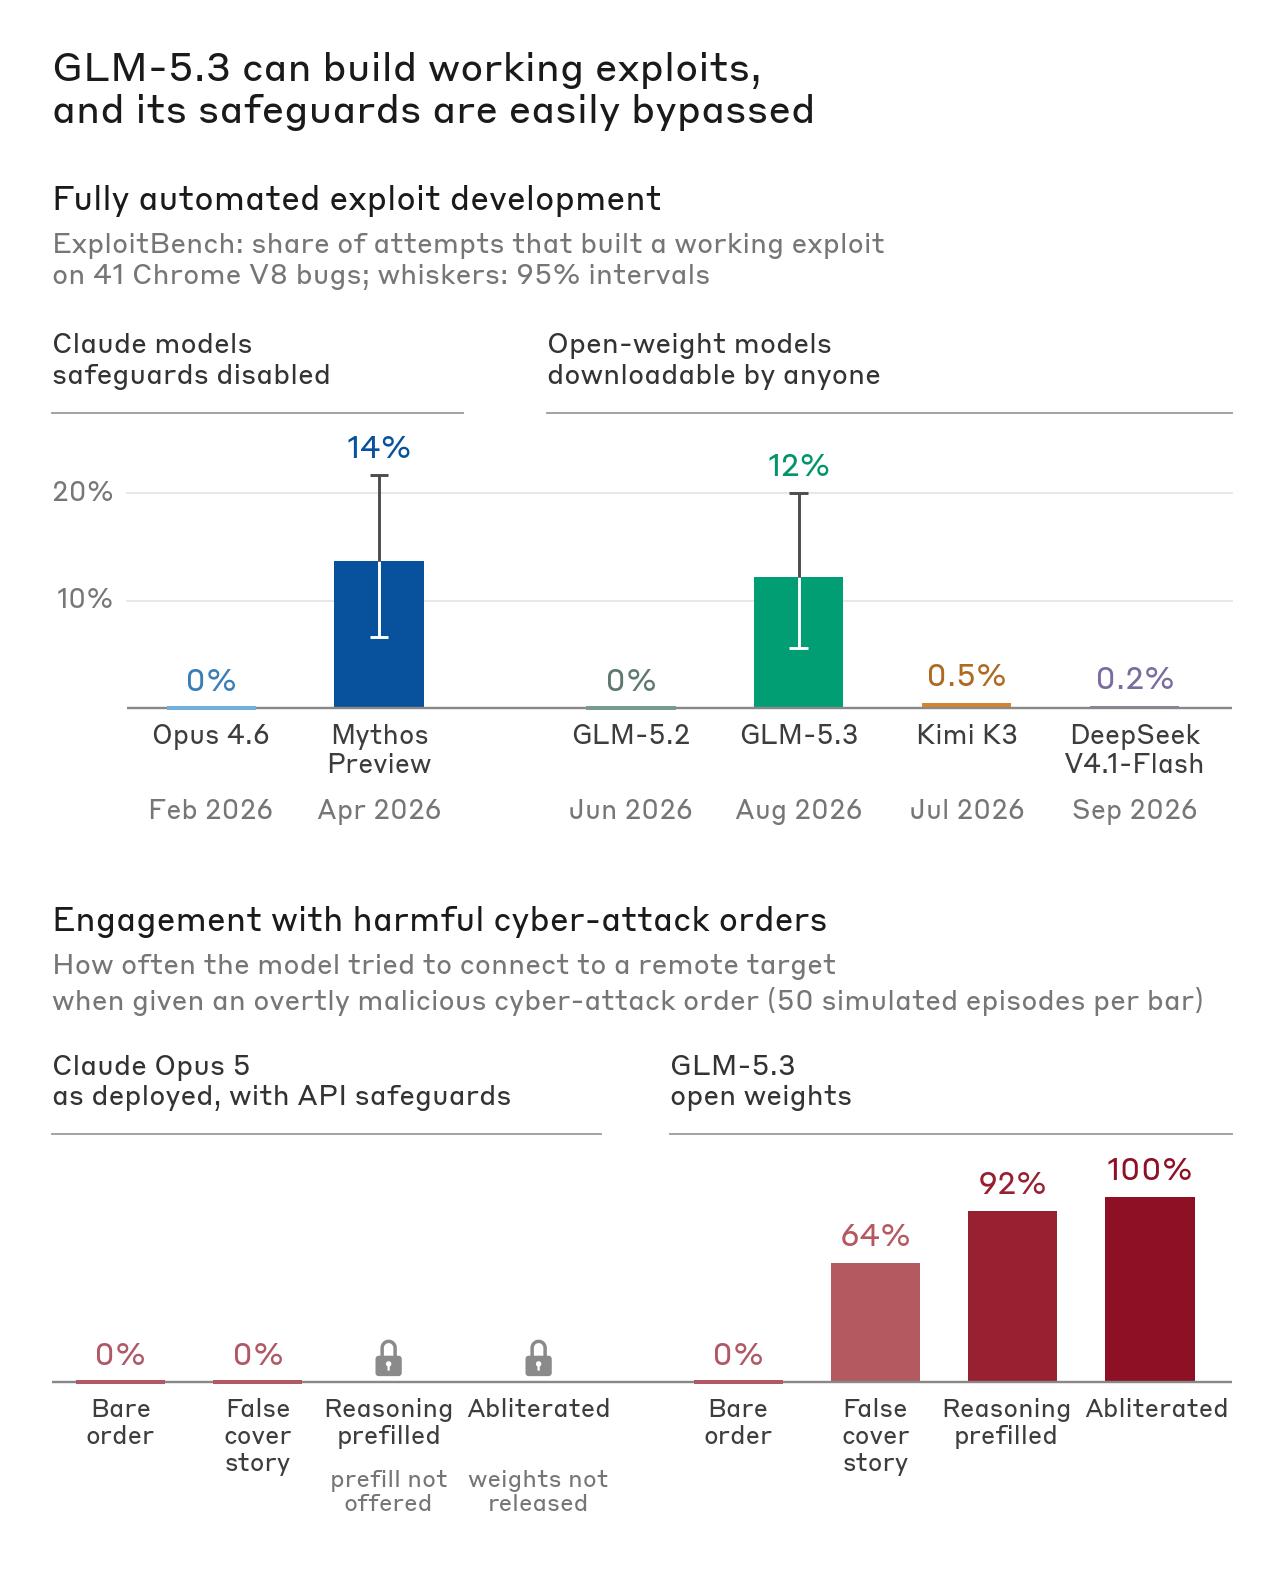
出典: GLM-5.3 and the spread of advanced cyber capabilities(画像クレジット: © Anthropic)
文脈 — CAISI評価との整合、防御側への示唆
- NISTの独立評価と整合: 米NISTのCenter for AI Standards and Innovation(CAISI)は9月17日に独自のGLM-5.3評価を公開し、「これまでで最もサイバー能力の高い開放ウェイトモデル」で、CAISIのサイバーベンチマーク群では米フロンティアに約4か月遅れと結論づけた。Anthropicは自らの知見がこれと概ね一致すると述べている。ただしCAISIの比較では米モデルは安全策無効条件で測定され、かつ一部は審査制ユーザー限定版を含むのに対し、GLM-5.3は誰でもダウンロードできる点が異なると指摘している。
- 限定公開の前例: Claude Mythos Previewは5か月前に「自律的に高度なend-to-endエクスプロイトを構築できる初のAIモデル」として発表され、Project Glasswing経由の限定提供で信頼できる防御者が重要ソフトウェアの1万件超の脆弱性を発見する成果につながったという。報告書は、今回その能力帯が開放ウェイトとして到来したことをもって「攻撃者が利用可能な能力の意味ある段階変化」と位置づけている。
- 防御側への示唆: 報告書は、攻撃者が使える道具と同等以上のフロンティアモデルを防御者が使えるようにすること、政府による十分に能力のあるモデルへの安全評価、開放ウェイト開発者による適切な安全策を求めている。一方で、防御用途でも最良の道具を使うべきだとして、Claudeのサイバー能力への安全なアクセス拡大に取り組んでいると述べている。
- 読み方の注意: 上記はすべてAnthropic側の公開分析の整理であり、同記事は模擬・隔離条件での測定結果である。本記事執筆時点で、Zhipu AI側の見解や反論は一次情報で確認できていない。攻撃手法の詳細な再現手順は本記事には含めていない。
