

NAW / PRODUCTS 03
IMAGE: AI生成ビジュアル
PRODUCTS / PRODUCTS
OpenAIがGPT-6のプロンプトキャッシュを強化 — ヒット率向上、30分枠の割引、診断ツールと明示ブレークポイント
OpenAIは2026年9月22日、GPT-6向けの改善版プロンプトキャッシュを発表した。既定で高いキャッシュヒット率、30分以内の共有プレフィックス再利用に対する最大90%の割引、ヒット率ダッシュボードとミス診断ツール、明示ブレークポイントなどを導入する。
OpenAIは2026年9月22日、GPT-6ファミリー向けの改善版プロンプトキャッシュを発表した。長時間動作するエージェントは指示・ツール定義・文脈を引き継いで連続リクエストを送るため、共有文脈の再利用が応答速度とコストを左右する。新システムは既定で高いキャッシュヒット率を提供し、開発者向けの計測・最適化手段を追加する。以下は同社発表ページの記載内容の整理である。
仕組みと割引 — 30分枠の共有プレフィックス再利用で最大90%引き
- 割引: キャッシュされた入力トークンは最大90%の割引。再利用の対象となる共有プレフィックスは30分の枠内でキャッシュ割引が適用される
- 効果(同社説明): GitHub Copilotの規模では、数十億リクエストにわたり新規処理が必要なプロンプトトークンの割合が従来比で50%超減少し、推論スタックの効率化と初回応答の高速化につながったとしている(GitHub CPOのコメントとして紹介)
- 狙い: リファクタリングや資料生成など数時間動くエージェントで、同じ指示・ツール定義・参照文脈の計算を再利用する
計測と診断 — ダッシュボードとミス診断ツール
- Prompt Caching Dashboard: アプリの入力のうちどれだけがキャッシュから供給されたかを表示し、ヒット率の推移やキャッシュ/非キャッシュのトークン構成を比較できる。ヒット率の低下検出や変更の影響評価に使う
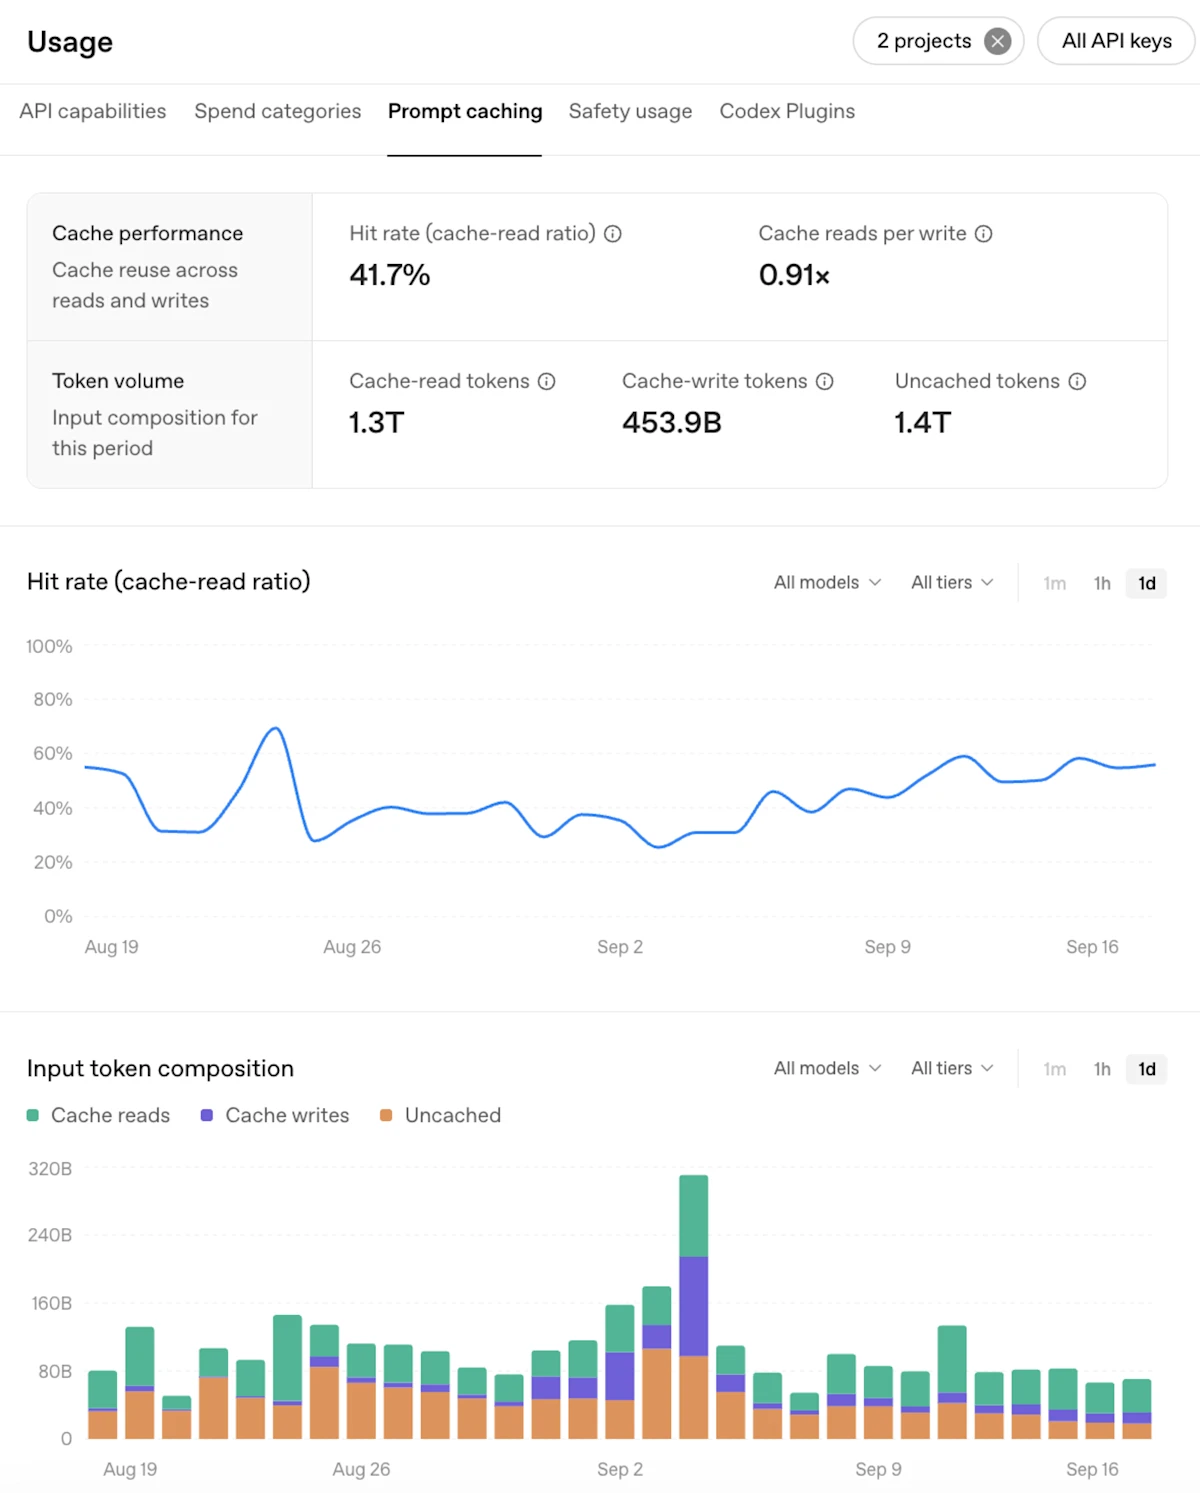
出典: Better prompt caching for GPT-6 - OpenAI
- 診断ツール: 予期せぬキャッシュミスでは、直近の応答とリクエストを比較してモデル・ツール・設定・入力のどれが再利用を阻害したかを示す。影響トークンの推定数で最適化の優先度を判断できる。例として
reason: tools_changedで5,629トークンがミスした診断出力を紹介している
最適化手段 — ブレークポイント、effort変更、プリウォーミング
- 明示ブレークポイント: キャッシュするプロンプトプレフィックスの区切りを開発者が指定できる。安定した文脈をキャッシュし、頻繁に変わる内容を末尾に置く設計が可能になる
- 推論effortの変更: GPT-6では
configuration_updateの追加により、リクエスト単位の推論effort設定を変えずに応答ごとのeffortを上げ下げでき、再利用可能な文脈を保ったまま難所だけ深く考えさせられる - ツール変更時の維持: ツール定義・スキーマ・順序を安定させ、
allowed_toolsで呼び出し対象だけを絞る、tool_choice: noneで定義を消さずに無効化する、新しい指示は開発者メッセージで文脈末尾に追記する、といった指針を示している - プリウォーミング: 共有の指示・ツール定義・参照資料を起動時などに事前処理し、初回リクエストの待ち時間から外す。既定の性能を補う任意の制御と位置づけている
導入企業の報告 — ヒット率90%超、コスト減(各社申告値)
- いずれも発表ページで紹介された導入企業の申告であり、独立した検証ではない
- ヒット率の改善: ある導入企業は1週間足らずで85%前後から90%超へ安定化、別の導入企業は評価環境で83%から91%へ上昇し、キャッシュ書き込みが約3分の2減、推論コストが36%減ったとしている
- コストの改善: 別の導入企業はヒット率が数ポイント上がってコストが20%減り、キャッシュ破損時のアラートと会話フォークの経済性向上を挙げている
