

IMAGE: AI生成ビジュアル
RESEARCH / Research
Inherent、27Bの“AI科学者”エージェント「Faraday」を公開 — Claude Opus 4.8とGPT-5.5を上回る論文再現性能
英Inherent Laboratoriesが、論文の図の再現をタスクに長期間の強化学習で訓練した27BパラメータのAI科学者エージェント「Faraday」を公開。100本の論文から作った310タスクのベンチマーク「Replica」で、はるかに大規模なClaude Opus 4.8とGPT-5.5を上回る再現精度を達成したと報告。コーディングエージェントを「道具」として指揮する構造が特徴。
英Inherent Laboratories(ロンドン)は2026年8月14日、研究論文の再現をタスクに訓練したAI科学者エージェント「Faraday」を公開した。27Bパラメータのモデルが、はるかに大規模なフロンティアモデルを上回る再現精度を示したとする報告で、AIによる科学の検証・再現という難所に長期間の強化学習で正面から取り組んだ事例として注目される。一次情報は公式研究ブログとarXiv論文(2608.13331)で公開されている。
Faradayとは — 「コーディングエージェントを道具として指揮する」27B
Faradayの核は、コーディングエージェントを「道具(tool)」として使いこなす上位の科学的判断層を学習させた点にある。
- ベースモデル: Qwen3.6-27Bを出発点に、長期間(long-horizon)の強化学習で事後訓練
- 道具の使い方: GPT-5.5 Codexなどのコーディングエージェントを呼び出し、実験設計・実装・可視化を委任しつつ、Faraday自身が仮説検証の方向付けと意思決定を担う。訓練時はGPT-5.4-miniを道具に用い、テスト時にはより高性能なGPT-5.5 Codexへ汎化できることも確認したと報告
- スケーラブルな監視の視点: 数桁大きいモデルを小さいモデルが「指揮して上回る」構造は、将来のより強力なコーディングエージェントに対しても、科学的判断層の価値を高める設計だと位置づけている
- 創業背景: Inherentは元Google DeepMindの研究者(Louis Kirsch、Kaloyan Aleksiev、Tautum Collins、Edward Hughesら)が創業。TechCrunchは2026年8月22日、Faradayの成果を「AnthropicとOpenAIを上回った」とする同社の主張を報じている(TechCrunchは発見用途の二次情報)
Replicaベンチマーク — 100本の論文から310の再現タスク
Faradayを訓練・評価するために導入されたのが、再現タスクの集合「Replica」だ。
- タスク設計: 研究論文に付随する図(figure)を、元プロットへのアクセスなし・時間と計算資源の制約下で再現させる。各タスクは論文から個別の結果や図を取り除いて生成され、エージェントは論文本文だけを手がかりに実験を設計・実装する必要がある
- 構成: 1990年から2026年に刊行されたMLおよびAI-for-science領域の論文100本から、310の再現タスクを派生。自然言語処理、材料科学、気象予測など多様なドメインを含む
- 評価軸: 単にプロットを似せることではなく、実験設計の妥当性、科学的実践の遵守、元論文の主張への忠実性、資源の有効活用といった「research taste(研究の勘所)」を含む
画像出典: Inherent — Training AI Scientists to Replicate Research(2026-08-14公開)
画像出典: Inherent — Training AI Scientists to Replicate Research(2026-08-14公開)
結果 — 大規模モデルを上回る再現精度
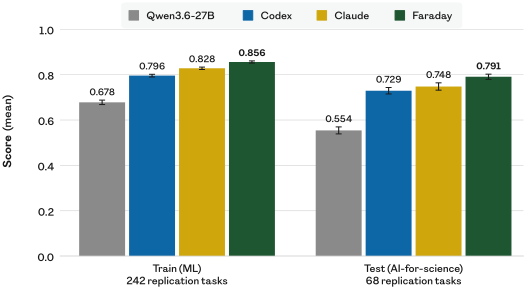
公開された評価では、FaradayがClaude Opus 4.8(Claude Codeハーネス)とGPT-5.5(Codexハーネス)を上回る平均再現スコアを示したと報告されている。比較では思考努力(thinking effort)をextra highに設定したベースラインが用いられた。
- 全体傾向: ML学習用スプリット、AI-for-scienceのホールドアウト(未見)スプリットのいずれでもFaradayが最高スコア
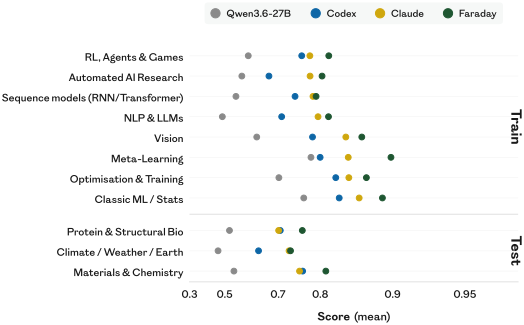
- ドメイン別: メタ学習、構造生物学、材料科学などで差が顕著。訓練ドメインとホールドアウトのテストドメインの双方で優位を維持し、事前学習時に見ていない近年の研究にも適用できていると報告
- 留意点: いずれもInherent自身が設計したReplicaベンチマークと同社が設計したジャッジによる評価であり、独立した第三者評価ではない。ベンダー公称値として扱い、再現実験や外部検証の蓄積を待つ必要がある
報酬設計の工夫 — ルーブリック付きLLMジャッジ
検証可能でない(non-verifiable)科学領域での強化学習を成立させるため、報酬信号の設計に工夫が凝らされている。
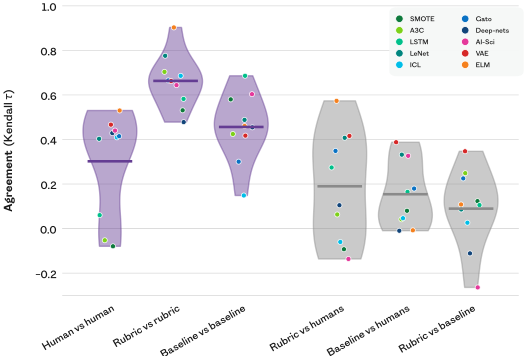
- 人手との一致を検証したLLMジャッジ: 専門家による人手評価と一致するかを検証した上で、LLMジャッジを採用
- 自動生成ルーブリックでノイズ低減: タスクごとに自動生成したルーブリック(採点基準)を付与することで、LLMの確率性に起因する報酬ノイズを低減。ベースラインのLLMジャッジより一貫性が高く、人手とのKendall tau一致度も高いと報告
- 学習安定化: マルチサンプル集約(multi-sample aggregation)とターン単位のクレジット割当て(turn-level credit assignment)で、長期間RLに特有の不安定性を緩和
画像出典: Inherent — Training AI Scientists to Replicate Research(2026-08-14公開)
なぜ「再現」か — 革新への足がかりという位置づけ
論文は、再現を「革新(innovation)の踏み台」と位置づける。論文には「うまくいったこと」しか書かれておらず、辿り着くまでの大量の失敗や試行錯誤は紙面に残らない。エージェントが再現に成功するには、ページに現れない「99%の汗」を仮説駆動の探索で補う必要があり、これはオープンエンドな研究に特徴的な能力だという。
- カリキュラムとしての拡張性: 単一の図だけでなく、論文から段階的に情報を削ったり、資源制約を変えたり、さらには「架空の論文」を与えて同じFaradayに革新を促すことも可能だとする
- 進化的ハーネスなしの発見: 既存のAI科学者エージェントのように手作りの進化ハーネスやテスト時の報酬がなくても、Faradayはロールアウト中に自発的に洞察を見つけ、スコアを段階的に改善する挙動を示すと報告(ロールアウト内の経過時間に対するスコア推移の図を公開)
- 安全性への含意: 同社は、科学的判断層とコーディングエージェントを分離する本アプローチが、スケーラブルな監視(scalable oversight)や報酬ハッキングの緩和にも示唆を与える可能性に触れている

