

NAW / RESEARCH 04
IMAGE: AI生成ビジュアル
RESEARCH / RESEARCH
LLMにも脳と同じ「機能モジュール」構造が現れる——46タスクの回路解析で確認(arXiv)
ヒトの脳は言語・形式的推論・他者理解・物理推論を異なる神経ネットワークで支える。この機能的専門化は知能の基本原理なのか、それとも生物固有の偶然なのか。MITの研究チームが46タスク・6モデル(24B〜123B)の回路解析で、LLMにも脳と同型のモジュール構造が出現することを示した。
ヒトの脳は高度な機能的専門化を示し、言語、形式的推論、他者理解(心の理論)、物理世界の推論をそれぞれ異なる神経ネットワークで支えている。このモジュール構造は「知能システムの基本原理」なのか、それとも生物の脳だけに見られる進化的な偶然なのか。本論文(Pengrui Han氏、Jacob Andreas氏、Evelina Fedorenko氏、Andrea Gregor de Varda氏=MIT)は、全く異なる最適化プロセスで作られたもう一つの知能システム——LLM——に同様の構造が出現するかを、46タスクにわたる回路解析で検証した。
公開(2026-08-17アナウンス)直後から、著者本人の発表スレッドなどで注目を集めている。
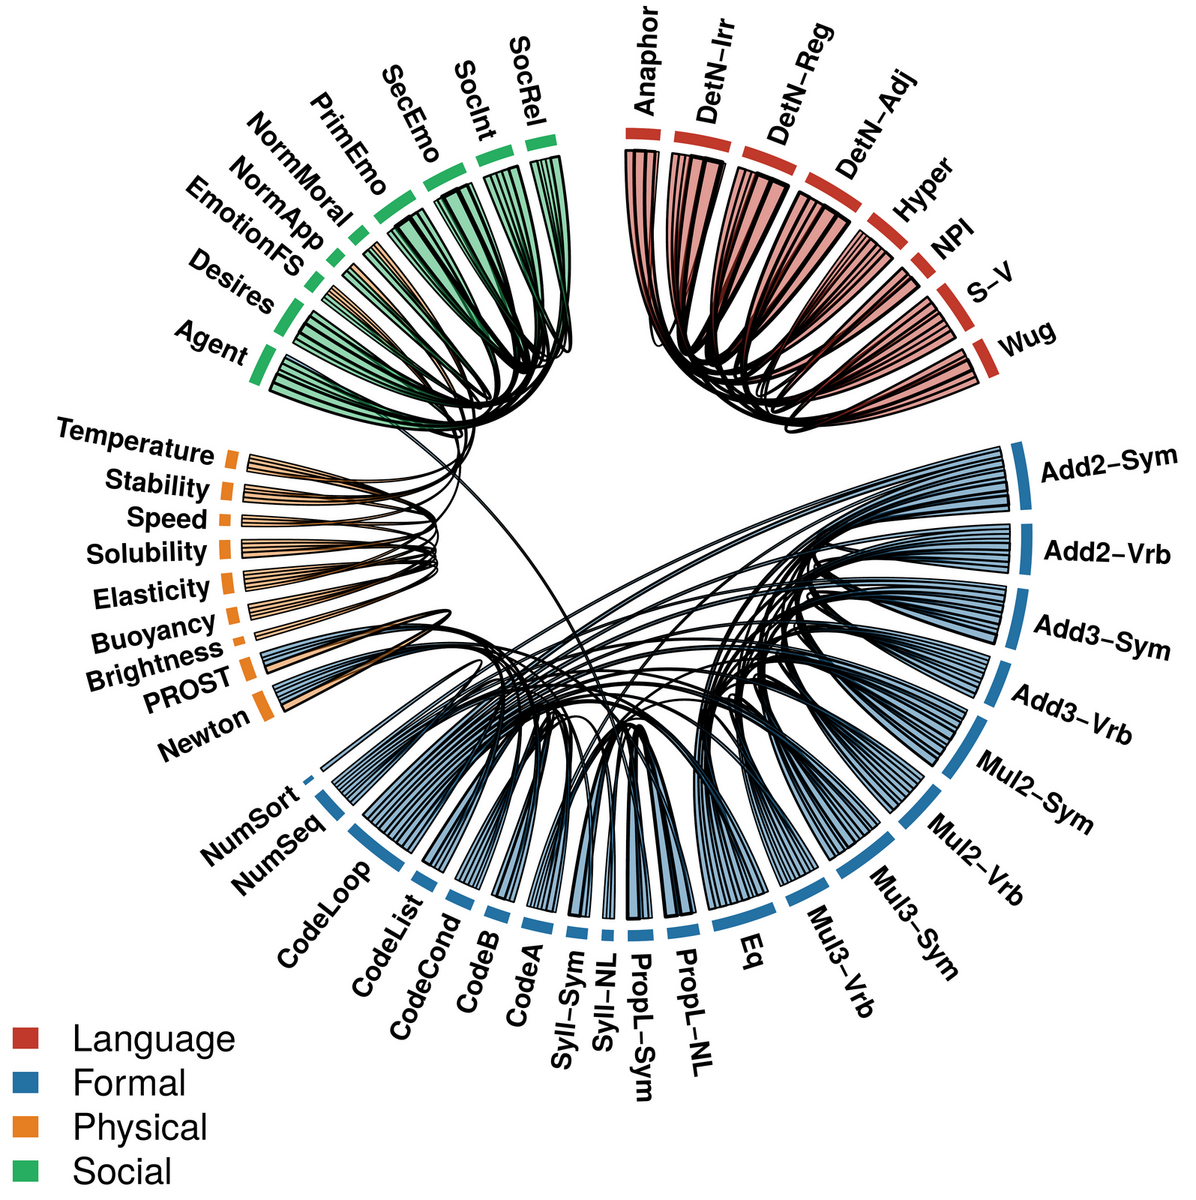
画像出典: 公式プロジェクトページ(LLM_Modularity、Figure 2)
方法:46タスク×6モデルの回路解析
- 4つの認知領域・46タスクのメタデータセット: 言語(8タスク・8,877組)、形式的推論(20タスク・19,941組)、物理推論(9タスク・9,200組)、社会的推論(9タスク・11,412組)——各領域は脳の既知の機能ネットワーク(言語ネットワーク、multiple-demandネットワーク、直観物理学ネットワーク、心の理論ネットワーク)に対応
- attribution patching: タスクごとに「正解が反転する最小対の入力(original/alternative)」を構成し、活性化差分×勾配で各MLPニューロンの貢献度を推定。上位0.1%のユニットをタスク選択的ニューロンとして特定
- 構造の定量化: タスク間のユニット重なりをペアワイズに計算し、教師なし階層クラスタリングで4領域が復元されるかを検証
- 因果的検証: 特定領域の上位0.1%ニューロンを切除(アブレーション)し、他のタスクへの転移を測定
- 対象モデル: インストラクションチューニング済みの6モデル(24B〜123B・4ファミリ)= Mistral-Small-24B-Instruct、Qwen2.5-32B-Instruct、OLMo-2-32B-Instruct、Llama-3.1-70B-Instruct、Qwen2.5-72B-Instruct、Mistral-Large-123B-Instruct
結果:脳と同型のモジュール構造がすべてのモデルに出現
- 構造的証拠: 6モデル平均で領域内オーバーラップ12.9% vs 領域間3.0%(パーミュテーションテストp<0.0001、約4.3倍)。LLM内でも「ヒト脳で同じネットワークを使うタスク」は同じニューロンを、「異なるネットワークを使うタスク」は別のニューロンを動員する
- 教師なし復元: 46×46タスク行列の階層クラスタリングが神経科学で定義された4領域を再現(Adjusted Rand Index = 0.78、p<0.0001)。モデル間の構造一致性も高い(平均Kendall’s τ = 0.70 ± 0.06)
- 因果的証拠: ドメイン内の切除で精度が25.9%低下する一方、ドメイン間の切除では2.5%低下(比10.3倍、p<0.0001)。「言語領域の切除→文法・綴りのエラーが出るが推論は保たれる」「物理推論領域の切除→文は流暢なまま結論が反転する」という質的な解離も確認
- 能力依存性: 同一パイプラインをGPT-2(124M、推論タスクでチャンスレベル以下)に適用すると「言語 vs それ以外」の大まかな区分しか現れず、3つの推論領域の細かな分化は見られない——モジュール性はモデルが実際にタスクを解ける場合にのみ出現する
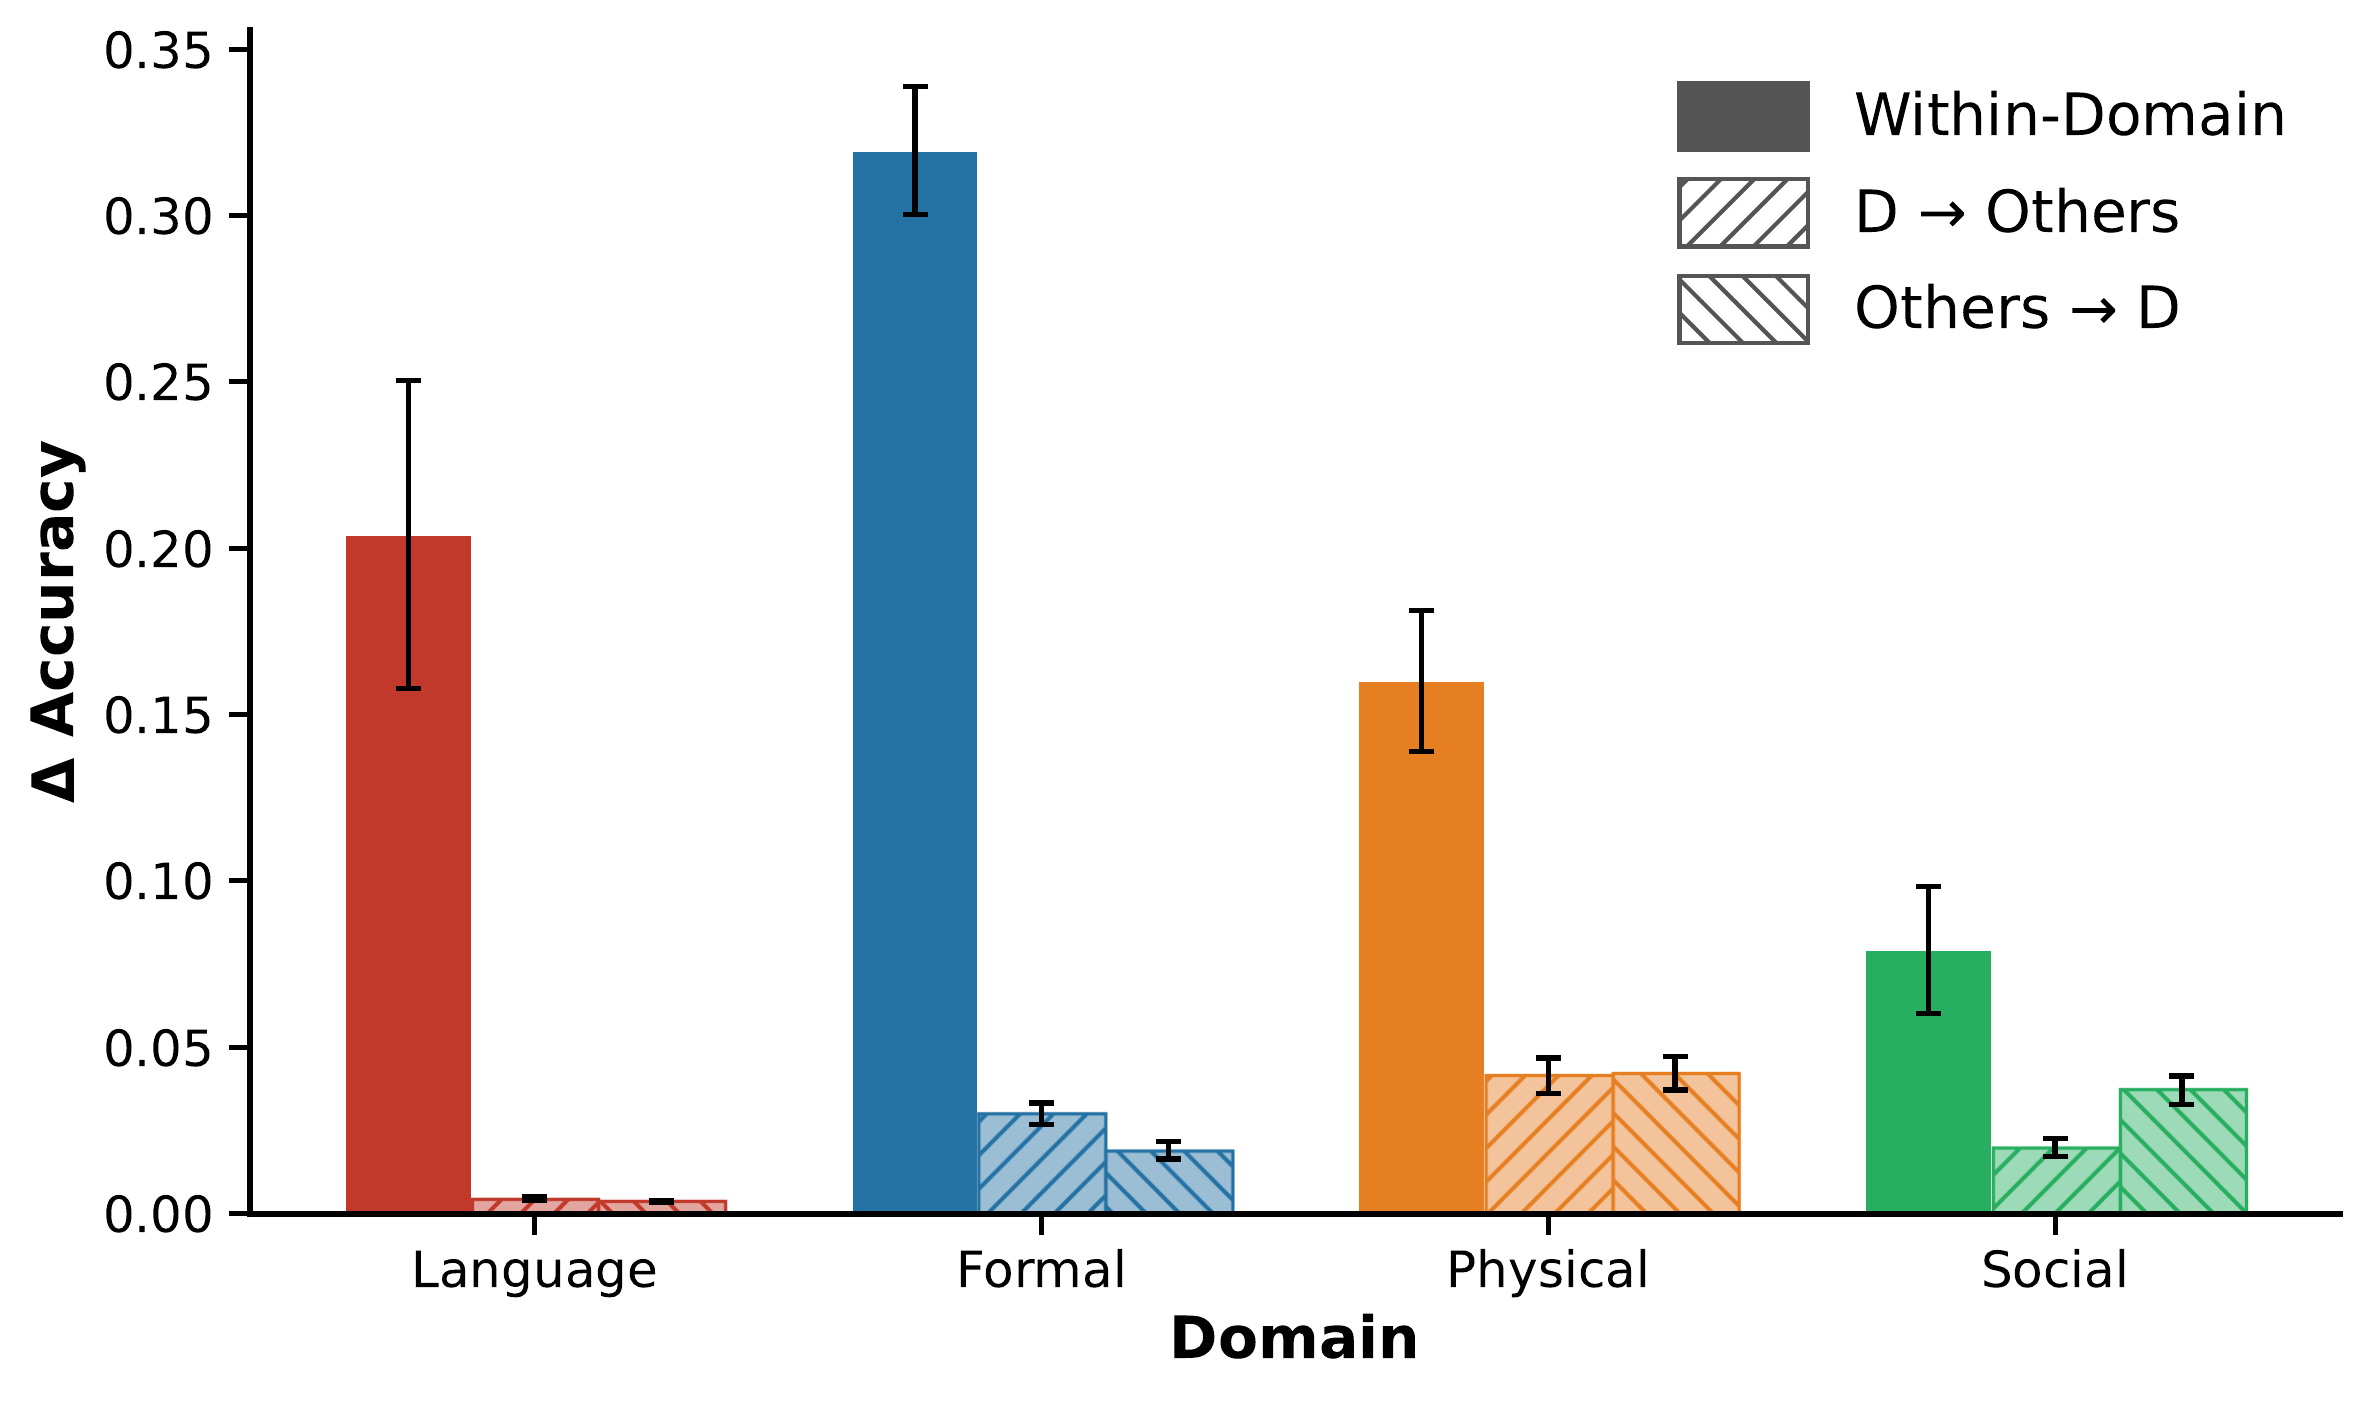
画像出典: 公式プロジェクトページ(LLM_Modularity、Figure 3)
議論:なぜモジュール性は現れるのか
- 代謝コスト説は不要: 皮質のモジュール性を説明する有力説は「タスクあたりの活性ニューロンを減らす省エネ圧力」。だがTransformerのforward passに代謝コストはなく、損失も活性ニューロン数を罰しない。それでもモジュール性は出現する
- 干渉回避仮説: 複数の推論が同じ入力に作用するとき、同時表現の分離可能性を保ち、ある領域の学習が別の領域を上書きしないよう、計算を分離する圧力が働く——「異なる計算に異なるニューロンを割り当てる」ことがこれを守る
- 含意: 勾配降下×次トークン予測という脳とは異なるプロセスで作られたシステムにも同じ構造が現れることは、モジュール性が「知能に共通する基本原理」である可能性を示唆する
- 公開資産: コードとデータはGitHubリポジトリとプロジェクトページで公開済み。46タスクの対比ペアも全量確認できる
出典: arXiv:2608.13567(Modular Cognitive Architecture Emerges in Large Language Models)、公式プロジェクトページ(LLM_Modularity)、GitHub: Pengrui-Han/LLM_Modularity(2026-08-17確認)。
